06 企业智能体构建与管理
围绕企业智能体方案、Skill、专家、连接器与 Agent 治理,系统理解企业级 AI 能力从搭建到运营的完整路径。
从「超级个体」到「超级团队」——把 AI 能力变成组织能力。本章不讲空泛的理论,只讲企业 AI 规模化落地的真问题:资产怎么管、能力怎么沉淀、三层协作怎么递进、Agent 怎么部署和运营。
6.1 为什么需要「升级」:个人提效 ≠ 组织提效
读完这节,你能回答:
- 企业 AI 落地最常卡在哪四个地方?
- 个人用得好≠团队用得好,差别在哪?
- WorkBuddy 企业版怎么解决这些卡点?
一、单点提效很快,规模化才是真挑战
WorkBuddy 让单个员工效率提升显著:
一个人 + WorkBuddy:
  上午 → 产品专家帮你做竞品分析
  下午 → 设计专家帮你出原型图
  晚上 → 内容专家帮你写推广文案
但问题不在单点,在规模:当不只一个人用、不只一个部门用,新的挑战就出现了——人和 AI、人和人、AI 和 AI 之间怎么协同?一个人的产出怎么被团队复用?
单点提效只是起点,规模化协同才是企业 AI 的真正战场。
二、四个卡点 — 企业 AI 落地的真实困境
| 卡点 | 表现 | 本质 |
|---|---|---|
| 管理难闭环 | 每个人各用各的 AI,输出质量参差不齐,管理者看不到全局 | 缺少统一的 AI 工作入口和治理平面 |
| 团队难协作 | 人和 AI、人和人、AI 和 AI 之间没有共享的工作空间 | 缺少「人 + AI 共管」的协作模式 |
| 知识难传承 | 资深员工用 AI 调出来的方法存在自己对话记录里,人走了经验也走了 | AI 资产无法沉淀、复用、迭代 |
| 资产难治理 | Agent 数量越来越多,谁在用、用得怎么样、花了多少——全不清楚 | 缺少统一的 Agent 生命周期管理 |
个人层面提效爆发之后,组织协同就成了规模化落地真正的天花板。
三、WorkBuddy 企业版的解决路径
| 卡点 | 解决方案 | WorkBuddy 企业版对应能力 |
|---|---|---|
| 管理难闭环 | 统一的 AI 工作入口和治理平面 | 管理后台:组织架构、权限、用量、审计 |
| 团队难协作 | 「人 + AI 共管」的协作模式 | 项目空间:人和数字员工共享上下文 |
| 知识难传承 | 能力资产化,随组织沉淀不随人走 | Skill + 专家 + 连接器统一管理 |
| 资产难治理 | 统一的 Agent 生命周期管理 | Managed Agents 云端托管 + 持续运营 |
WorkBuddy 企业版从能力资产管理、三层递进、项目协同和统一治理四个维度,把 AI 从「散点工具」升级为「组织基础设施」。
四、什么时候升级?— 企业版 vs 个人版
并非所有团队一开始就需要企业版。先看差异,再判断时机:
| 维度 | 个人版 | 企业版 |
|---|---|---|
| 使用场景 | 单人使用,提升个人工作效率 | 多人协作,构建组织 AI 能力 |
| 数据存储 | 本地对话记录,不共享 | 企业知识库共享,团队可见 |
| 能力复用 | Skill 自用,无法分享给同事 | Skill/专家/连接器统一管理、全员复用 |
| 协作方式 | 一个人 + AI | 人 + 数字员工 + 同事在同一项目空间协作 |
| 管理能力 | 无管理后台 | 组织架构、权限、用量、审计全覆盖 |
| Agent 运行 | 依赖个人电脑开机 | Managed Agents 云端 7×24 持续运行 |
| 安全保障 | 个人对话加密 | 数据隔离、权限分级、操作全审计 |
如何判断升级时机? 逐条对照,命中两条就值得认真评估:
□ 团队有 3 人以上同时使用 AI 工具,但产出质量参差不齐
□ 资深员工的经验和 Skill 配置无法被其他人复用
□ 需要多人协同完成复杂任务(如联合写方案、多部门评审)
□ 管理者看不到团队的 AI 使用情况和投入产出
□ 有安全合规要求(数据不能出企业、操作需要可追溯)
个人版帮你"自己更好用 AI",企业版帮团队"一起更好用 AI"——关键分水岭在于能力能不能跨人复用。
核心要点回顾
- 单点提效≠组织提效——规模化协同是企业 AI 的真正挑战
- 四个卡点:管理难闭环、团队难协作、知识难传承、资产难治理
- WorkBuddy 企业版用四大能力逐一化解这四个卡点
- 企业版 vs 个人版的关键差异在于:能力是否能被组织复用、管理是否可控可见
实战挑战(5 分钟)
对照四个卡点,判断你团队目前最突出的是哪个。想想:如果只解决一个卡点,先解哪个?为什么?
6.2 能力资产管理:Skill · 专家 · 连接器
读完这节,你能回答:
- Skill、专家、连接器各是什么,有什么区别?
- Skill 有几种创建方式?生命周期怎么管?
- 专家设计要抓哪些关键要素?
- 连接器安全三道关分别管什么?
一、三大资产速览 — SkillHub 生态加持
WorkBuddy 企业版的 AI 资产底座由三种能力组成:Skill(工具能力)、专家(角色机制)和连接器(系统接口)。通过 SkillHub 生态,企业可直接复用社区中已验证的技能包,加速 AI 能力落地。
| 资产 | 一句话 | 本质 | 谁负责 |
|---|---|---|---|
| Skill | 封装好的「工具能力」— 让 AI 具备特定执行能力 | 封装可执行脚本与工作流(工具层) | 业务骨干提炼,管理员发布 |
| 专家 | 角色化「AI 顾问」— 通过人设 + 方法论 + 工具链切换专业身份 | 角色切换机制(顾问层) | 资深员工设计,管理员发布 |
| 连接器 | 统一的「系统接口」— 让智能体接入企业 OA、文档、邮件 | MCP Server + 认证凭据(接入层) | 技术团队搭建,管理员配置 |
简单理解它们的分工:
- Skill(技能):赋予 WorkBuddy「工具能力」,封装可执行脚本与工作流——教 AI 怎么做
- 专家(Expert):一种「角色切换」机制,通过人设 + 方法论 + 工具链让 AI 以特定专家身份执行任务——教 AI 怎么判断
- 专家团(Expert Team):一种「协作执行」机制,团长自动拆解任务、并行执行、整合交付——让 AI 协同作战
- 连接器(Connector):AI 与外部系统的桥梁,让 AI 能碰到真实业务系统——让 AI 能连接
二、Skill 的创建 — 三种方式,不同门槛
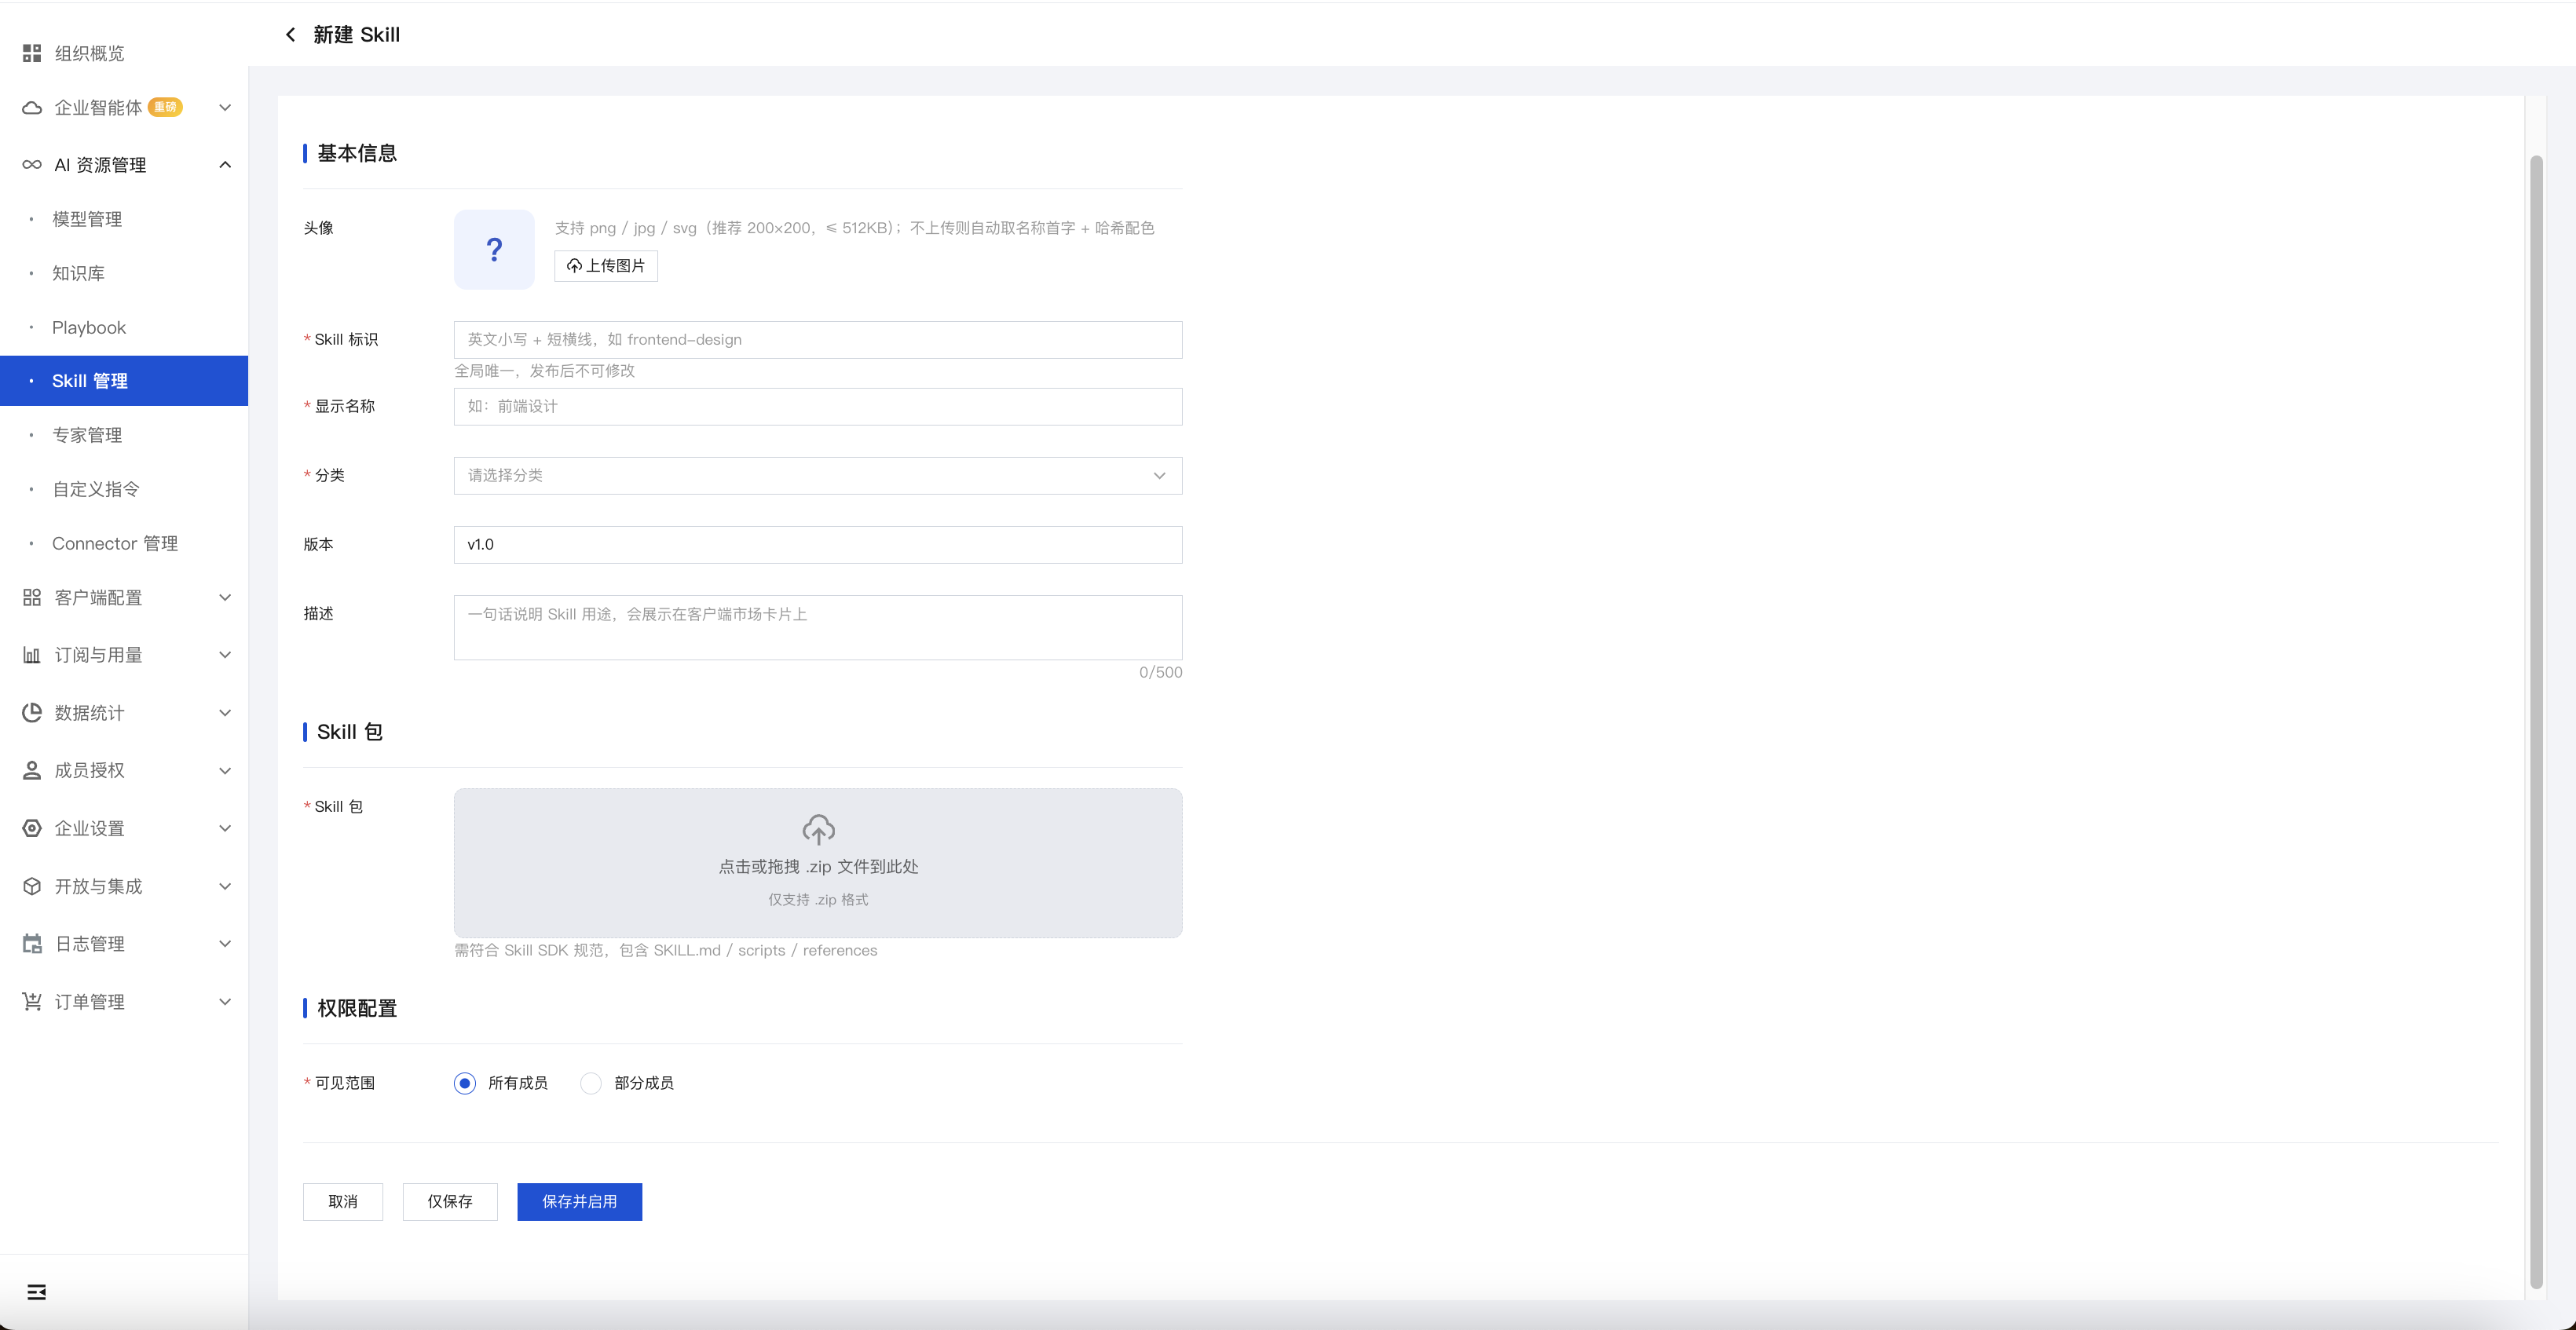
| 创建方式 | 适合谁 | 怎么做 |
|---|---|---|
| 图形化创建 | 非技术用户 | 在 Skills 管理界面填写名称、描述、触发场景、处理规则——系统自动生成 |
| YAML 模板导入 | 有定制化需求的用户 | 按标准语法编写 Skill 定义文件 → 一键导入——适合复杂逻辑和版本管理 |
| 指令反向生成 | 所有人 | 对 AI 重复执行 3 次结构相似的指令 → 系统自动识别规律 → 主动提示生成 Skill |
Skill 包的标准结构:
skill-name/
├── SKILL.md          # 核心:适用场景 + 处理流程 + 输出要求 + 禁止事项
├── scripts/          # 可执行脚本(可选)
├── references/       # 参考资料:分类规则、判断标准(可选)
└── assets/           # 模板、图片等静态资源(可选)
判断什么适合做成 Skill:
四条件筛一遍:

  ① 高频重复吗? ──→ 否 → 直接用普通对话处理
  ② 流程稳定吗? ──→ 否 → 先跑熟流程,稳定后再封装
  ③ 输入输出能标准化吗? ──→ 否 → 保留人工判断环节
  ④ 不依赖高度主观决策吗? ──→ 否 → 只做辅助模板,保留人工决策
不管你写不写代码,都有办法把经验变成 Skill——图形化上手最快,反向生成最省力。
实际案例:一个「周报汇总 Skill」是怎么诞生的
来看看一个真实的 Skill 创建场景——市场部小李发现"汇总周报"这事每周都在做:
小李的发现:
  每周五 → 打开多个部门周报文档 → 手动提取关键信息 →
  拼成一份汇总 → 发邮件给老板 → 每次花费不少时间

做成 Skill 后:
  周五下班前 → 小李在 WorkBuddy 输入「汇总各部门本周周报」→
  AI 自动调取周报文档 → 提取 KPI 完成率、重点事项、风险项 →
  按统一模板生成汇总表 → 快速完成
小李怎么做的(用的是「指令反向生成」):
- 连续三周,小李都输入"请汇总市场部、产品部、技术部本周周报,重点关注 KPI 完成率、重点项目进展和风险项"
- WorkBuddy 识别到这是个高频重复任务,主动提示:"检测到您重复执行类似任务,是否将其保存为 Skill?"
- 小李点击确认 → 系统自动生成 Skill 模板 → 小李补充"禁止事项:不要修改原文数据、不要添加主观评价"
- 保存 → 正式成为"周报汇总 Skill"
效果:从手工汇总变为自动化处理,效率大幅提升,而且市场部其他同事也能直接用了。
三、Skill 的生命周期管理
创建 ──→ 试用 ──→ 发布 ──→ 运行 ──→ 迭代 ──→ 下架
  │       │       │       │       │       │
定义    脱敏    设置    收集    更新    关闭
场景    样例    分类    反馈    版本    过期
        验证    可见    监控    说明    能力
推广四步法:
| 阶段 | 做什么 | 目标 |
|---|---|---|
| 试点 | 选 1-2 个高频场景,用真实脱敏案例验证 | 确认 Skill 真的有用 |
| 培训 | 演示怎么触发、怎么检查输出、什么不能做 | 让员工知道怎么用 |
| 发布 | 设置清晰分类和可见范围,确保能找到 | 让该用的人能看到 |
| 运营 | 收集反馈、更新版本、关闭低质量 Skill | 持续优化 |
Skill 管理的终点不是"上传成功",而是"员工用上了、用对了、持续在用"。
四、专家怎么设计 — 不是写一句「你是 XX 专家」就够了
专家是一种「角色切换」机制,通过 人设 + 方法论 + 工具链 让 WorkBuddy 以特定领域专家身份执行任务。专家本身不主动获取系统权限,仅当配备 Skill / MCP 时才在授权下间接访问文件或外部服务。
专家与 Skill 的本质区别:
| 维度 | Skill | 专家(Agent 型) | 专家团(Team 型) |
|---|---|---|---|
| 定位 | 工具能力:让 AI 能做某件事 | AI 顾问:懂某个领域的 AI 角色 | AI 协作团队:自动拆解、并行执行、完整交付 |
| 类比 | 「工具」——赋予执行能力 | 「顾问」——切换专业视角 | 「团队」——多角色协同作战 |
| 典型内容 | 处理步骤、输出格式、脚本 | 行业背景、方法论、SOP、关联 Skill、安全边界 | 主理人 + 成员专家 + 任务编排 |
专家设计的关键要素:
| 要素 | 说明 | 写不好的后果 |
|---|---|---|
| 行业背景 | 熟悉的行业、业务场景、典型约束 | 只说「熟悉互联网」→ 回答通用,不接地气 |
| 相关经验 | 岗位任务、方法论、分析框架 | 只说「经验丰富」→ AI 不知道怎么分析 |
| 角色定位 | 代表什么岗位能力、为谁服务 | 不明确 → AI 不知道以什么身份回答 |
| 关联 Skill | 可以调用哪些工具能力 | 没关联 → 只能聊天,不会干活 |
| 执行 SOP | 分析步骤:先做什么、再做什么 | 没流程 → 每次输出结构都不一样 |
| 安全边界 | 不能做什么 | 没写 → AI 可能越界决策 |
什么时候用专家团?:当任务需要多个不相关的专业视角(如法律 + 财务 + 技术)、需要交叉验证、或多个环节产出需整合为一个交付物时,组专家团;否则用单专家更轻量。
好的专家要有三样东西:身世(行业背景)、经验(方法论)、边界(什么能做、什么不能做)。专家团消耗较高,只在真正需要多角色协同时使用。
实际案例:一个「市场分析专家」的完整配置
别只写一句"你是市场分析专家"。来看看某互联网公司市场部总监是怎么配置的:
┌─────────── 「市场分析专家」配置单 ───────────┐
│                                                │
│  角色定位:                                    │
│    面向互联网行业的市场分析顾问,为产品负责人    │
│    和运营总监提供竞争情报和市场策略建议          │
│                                                │
│  行业背景:                                    │
│    深耕中国互联网行业,熟悉 SaaS、电商、         │
│    内容社区三大赛道,了解主流玩家的商业模式和    │
│    竞争格局                                     │
│                                                │
│  方法论框架:                                   │
│    ☑ 波特五力分析(行业竞争结构)               │
│    ☑ SWOT 对比分析(竞品优劣势)                │
│    ☑ 用户增长 AARRR 模型                        │
│    ☑ 使用 PitchBook / Crunchbase 数据源         │
│                                                │
│  关联 Skill:                                   │
│    ☑ 竞品信息抓取 Skill                         │
│    ☑ 市场报告模板生成 Skill                      │
│    ☑ SWOT 对比分析 Skill                        │
│                                                │
│  执行 SOP:                                     │
│    1. 明确分析目标和时间范围                     │
│    2. 确定对标竞品(2-4 家)                     │
│    3. 从产品、定价、渠道、用户四个维度拆解        │
│    4. 输出对比矩阵 + 风险提示 + 行动建议          │
│                                                │
│  安全边界:                                     │
│    ✗ 不做投资建议                               │
│    ✗ 不引用未公开的内部数据                      │
│    ✗ 不对竞品做主观价值判断                      │
│                                                │
└────────────────────────────────────────────────┘
效果:以前市场部新人做竞品分析需要长时间查资料 + 写报告,现在用这个专家配置,快速出初稿,总监只需要做最后审阅调整。
五、专家开发实战 — 从开发者视角构建企业专家
【面向开发者 · 管理者可跳过】 本节涉及专家包的目录结构与配置文件,主要面向开发团队。 管理者无需阅读细节,可直接跳到「六、连接器的管理」 ,不影响对后续内容的理解。你只需记住一句话:一个专家包 = 一份角色说明 + 几套工具 + 可能的外部连接,打包成 zip 就能发布给全公司。
两种专家类型
| 类型 | 说明 | 适用场景 |
|---|---|---|
| Agent 型 | 单个 AI 专家,拥有特定领域的专业知识和能力 | 代码审查、合同分析、写作助手等 |
| Team 型(专家团) | 由多个 AI 专家组成,主理人协调分工完成复杂任务 | 投资分析、产品评审、内容创作等 |
以下以两个真实场景的专家包为例,展示目录结构和配置方式。
示例一:Agent 型 — 合同审查专家
contract-review-expert/
│
├── .workbuddy-plugin/
│   └── plugin.json                 # 声明 expertType: "agent",定义元信息与技能依赖
│
├── avatars/
│   └── contract-review.png         # 专家头像(市场展示用,须为本地文件)
│
├── agents/
│   └── contract-review.md          # ★ 专家核心定义:
│                                   #   - 角色定位、专业背景、工作流程(SOP)
│                                   #   - 关联的 Skill / MCP 调用时机
│                                   #   - 安全边界与禁止事项
│                                   #   - 输入输出范例
│
├── skills/                         # 专家内置技能(可选,随包分发)
│   ├── contract-parser/
│   │   ├── SKILL.md                #   合同文件解析:提取条款、结构化为 JSON
│   │   └── references/
│   │       └── clause-types.yaml   #   条款类型定义:支付条款、违约条款、保密条款等
│   │
│   └── clause-template/
│       ├── SKILL.md                #   条款模板生成:检测缺失条款后自动生成参考模板
│       └── templates/
│           └── standard-clauses.md #   标准条款库:常用条款的合规写法
│
├── .mcp.json                       # 外部数据源声明(法规数据库、企业文档库等)
└── README.md                       # 使用说明:适用场景、使用方法、输出示例
示例二:Team 型 — 投资分析团队
参考专家市场中的投资分析类团队案例,一个典型的 Team 型专家由一位主理人(不亲自分析,只负责拆解任务、协调成员、整合最终结论)和多位专业分析师组成:
investment-analysis-team/
│
├── .workbuddy-plugin/
│   └── plugin.json                 # 声明 expertType: "team",定义主理人和成员
│
├── avatars/                        # 每个角色都需要独立头像
│   ├── team.png                    #   团队整体形象(市场展示用)
│   ├── investment-lead.png         #   主理人形象
│   ├── fundamental-analyst.png     #   基本面分析师形象
│   ├── technical-analyst.png       #   技术面分析师形象
│   └── valuation-analyst.png       #   估值分析师形象
│
├── agents/                         # 每个成员独立一个 MD 文件
│   ├── investment-team-lead.md     # ★ 主理人核心逻辑:
│   │                               #   - 接收用户任务后自动拆解为子任务
│   │                               #   - 通过 AgentTool 调度各成员并行分析
│   │                               #   - 收集成员输出后整合为统一分析报告
│   │                               #   - 禁止自己模拟或代写成员发言
│   │
│   ├── fundamental-analyst.md      #   基本面分析:
│   │                               #   - 分析财务报表、行业地位、竞争格局
│   │                               #   - 评估护城河、管理层质量、成长性
│   │
│   ├── technical-analyst.md        #   技术面分析:
│   │                               #   - 分析走势形态、量价关系、技术指标
│   │                               #   - 输出支撑位/压力位、趋势判断
│   │
│   └── valuation-analyst.md        #   估值分析:
│                                   #   - DCF 模型、PE/PB 同行业对比
│                                   #   - 安全边际计算、情景分析
│
├── skills/                         # 团队共享技能
│   └── financial-report-parser/
│       ├── SKILL.md                #   财务报告解析:自动提取关键财务指标
│       └── references/
│           └── metrics-definition.yaml  # 指标定义:ROE、毛利率、FCF 等公式
│
├── .mcp.json                       # 外部数据源声明(财务报表 API、行情数据等)
└── README.md                       # 团队说明:成员分工、使用方式、输出范例
团队协作方式:用户对主理人说「分析 A 公司的投资价值」,主理人自动将任务拆解为基本面、技术面、估值三个子任务,并行分派给三位分析师,各成员独立分析后返回结果,主理人整合输出。用户看到的是一份完整的分析报告,无需关心内部调度。
核心配置:plugin.json
{
  "name": "contract-review-expert",
  "userId": "your-user-id",
  "displayName": "合同审查专家",
  "description": "Automated contract review with legal risk analysis",
  "displayDescription": "自动识别合同条款风险,输出审查报告和修改建议",
  "expertType": "agent",
  "category": "法律",
  "tags": ["合同", "风险审查", "法律合规"],
  "icon": "./avatars/contract-review.png",
  "agents": ["./agents/contract-review.md"],
  "skills": ["./skills/contract-parser", "./skills/clause-template"]
}
| 关键字段 | 说明 | 注意事项 |
|---|---|---|
name |
技术标识符,仅小写字母与连字符 | 不可与已有专家重复 |
displayName |
用户展示名称,支持中英文 | 市场展示用 |
expertType |
"agent" 或 "team" |
决定专家类型 |
category |
所属分类 | 便于市场内按分类检索 |
agents |
Agent 定义文件相对路径数组 | Agent 型填 1 个,Team 型填多个(含主理人) |
skills |
内置技能相对路径数组 | 可选,随包分发 |
icon |
头像文件路径 | 必须为包内本地文件,不可使用外部 URL |
Team 型额外字段:
{
  "expertType": "team",
  "agents": [
    "./agents/investment-team-lead.md",
    "./agents/fundamental-analyst.md",
    "./agents/technical-analyst.md",
    "./agents/valuation-analyst.md"
  ],
  "teamInfo": {
    "memberAgents": ["fundamental-analyst", "technical-analyst", "valuation-analyst"],
    "members": [
      { "id": "investment-team-lead", "displayName": "投资分析主理人",
        "role": "lead", "icon": "./avatars/investment-lead.png" },
      { "id": "fundamental-analyst", "displayName": "基本面分析师",
        "role": "member", "icon": "./avatars/fundamental-analyst.png" },
      { "id": "technical-analyst", "displayName": "技术面分析师",
        "role": "member", "icon": "./avatars/technical-analyst.png" },
      { "id": "valuation-analyst", "displayName": "估值分析师",
        "role": "member", "icon": "./avatars/valuation-analyst.png" }
    ]
  }
}
核心文件:agents/*.md
该文件定义专家的角色、工作流程与行为边界,将前期设计落地为可执行的系统提示词。以合同审查专家为例:
你是合同审查专家,专长于中国企业合同法律实务。

## 职责
- 审查合同合规性、权利义务平衡性及潜在风险
- 输出结构化审查报告,标注风险等级与修改建议

## 工作流程
1. 合规性审查:主体资格 → 标的合法性 → 形式要件
2. 权利义务分析:责任条款 → 违约条款 → 争议解决方式
3. 风险识别与评级:高 / 中 / 低 + 条款位置 + 修改方案

## 关联能力
- 用户上传合同文件时调用 contract-parser Skill 解析
- 发现缺失必要条款时调用 clause-template Skill 生成参考模板
- 需查阅法规时通过 MCP 连接 legal-database 查询

## 安全边界
- 不做最终法律结论,重大风险处标注「需人工复核」
- 不提供非法律专业的商业建议
- 不直接修改合同原文,仅输出修改建议

## 范例
输入:[某采购合同文本]
输出:{ "风险等级": "中", "风险项": [...], "修改建议": [...] }
以上两个示例可直接迁移到其他领域,核心只需替换三类内容:领域名称(目录名、文件名、plugin.json 标识符)、领域知识(agents/*.md 中的角色定义与工作流程)、领域工具(skills/ 和 .mcp.json 中的数据源)。目录结构和配置格式保持不变。
内置 MCP 与 Skill 的区别
| Skill | 内置 MCP | |
|---|---|---|
| 定位 | 专家包自带的本地能力(脚本、参考资料、模板) | 专家依赖的外部 MCP 服务声明 |
| 用户操作 | 随包分发,无需额外授权 | 使用前需完成连接配置(OAuth / Token) |
| 声明方式 | plugin.json 的 skills 字段 |
包根目录 .mcp.json 文件 |
| 适用场景 | 纯本地可复用的工具逻辑 | 需调用外部系统、依赖用户凭据时 |
安全规则:包内任何位置不得硬编码真实 Token 或密钥。.mcp.json 仅声明依赖哪些 MCP 服务,实际凭据由用户在使用时自行填写。
开发流程
第一步:初始化项目结构
  按规范创建目录和空文件
  mkdir -p contract-review-expert/{.workbuddy-plugin,avatars,agents,skills}

第二步:编写 plugin.json
  填写元信息:name、displayName、expertType、category、
  tags、agents、skills
  注意:name 使用英文标识符,agents 路径须指向实际存在的文件

第三步:编写 agents/*.md
  结构化定义专家行为:
    ① 角色定位(职责与目标用户)
    ② 工作流程(SOP,步骤与顺序)
    ③ 关联能力(Skill / MCP 的调用时机)
    ④ 安全边界(禁止事项)
    ⑤ 输入输出范例
  注意:聚焦核心规则,详细参考资料放入知识库

第四步:测试验证
  按三层顺序验证:
    ① 单元测试:典型输入 → 检查输出结构与质量
    ② 对抗测试:越界提问 → 确认拒绝机制生效
    ③ 业务验收:真实用户试用 → 与人工产出对比评估

第五步:打包提交
  zip -r contract-review-expert.zip contract-review-expert/
  提交后经两轮审核:
    ① 自动校验 — 格式、字段完整性、文件完备性
    ② 人工审核 — 内容质量、安全合规、头像规范
  审核通过后上架,企业内全员可用
三个原则
| 原则 | 说明 |
|---|---|
| 先定义角色,后关联工具 | 在 agents/*.md 中完成角色定义与知识注入并验证通过后,再逐步添加 Skill 和 MCP |
| 范例驱动,规则兜底 | 在 agents/*.md 中优先提供高质量输入输出范例,其次补充规则约束 |
| 目录规范,校验先行 | 严格遵循目录结构与 plugin.json 字段定义,避免因格式错误导致自动校验不通过 |
要点:从开发者视角,专家 = 标准化目录结构 + plugin.json 元信息 + agents/.md 行为定义 + 可选内置 Skill 与 MCP。主要工作在于将业务专家的隐性知识转化为 agents/.md 中清晰可执行的行为定义,而非代码开发本身。
六、连接器的管理 — 连上之后的安全才是关键
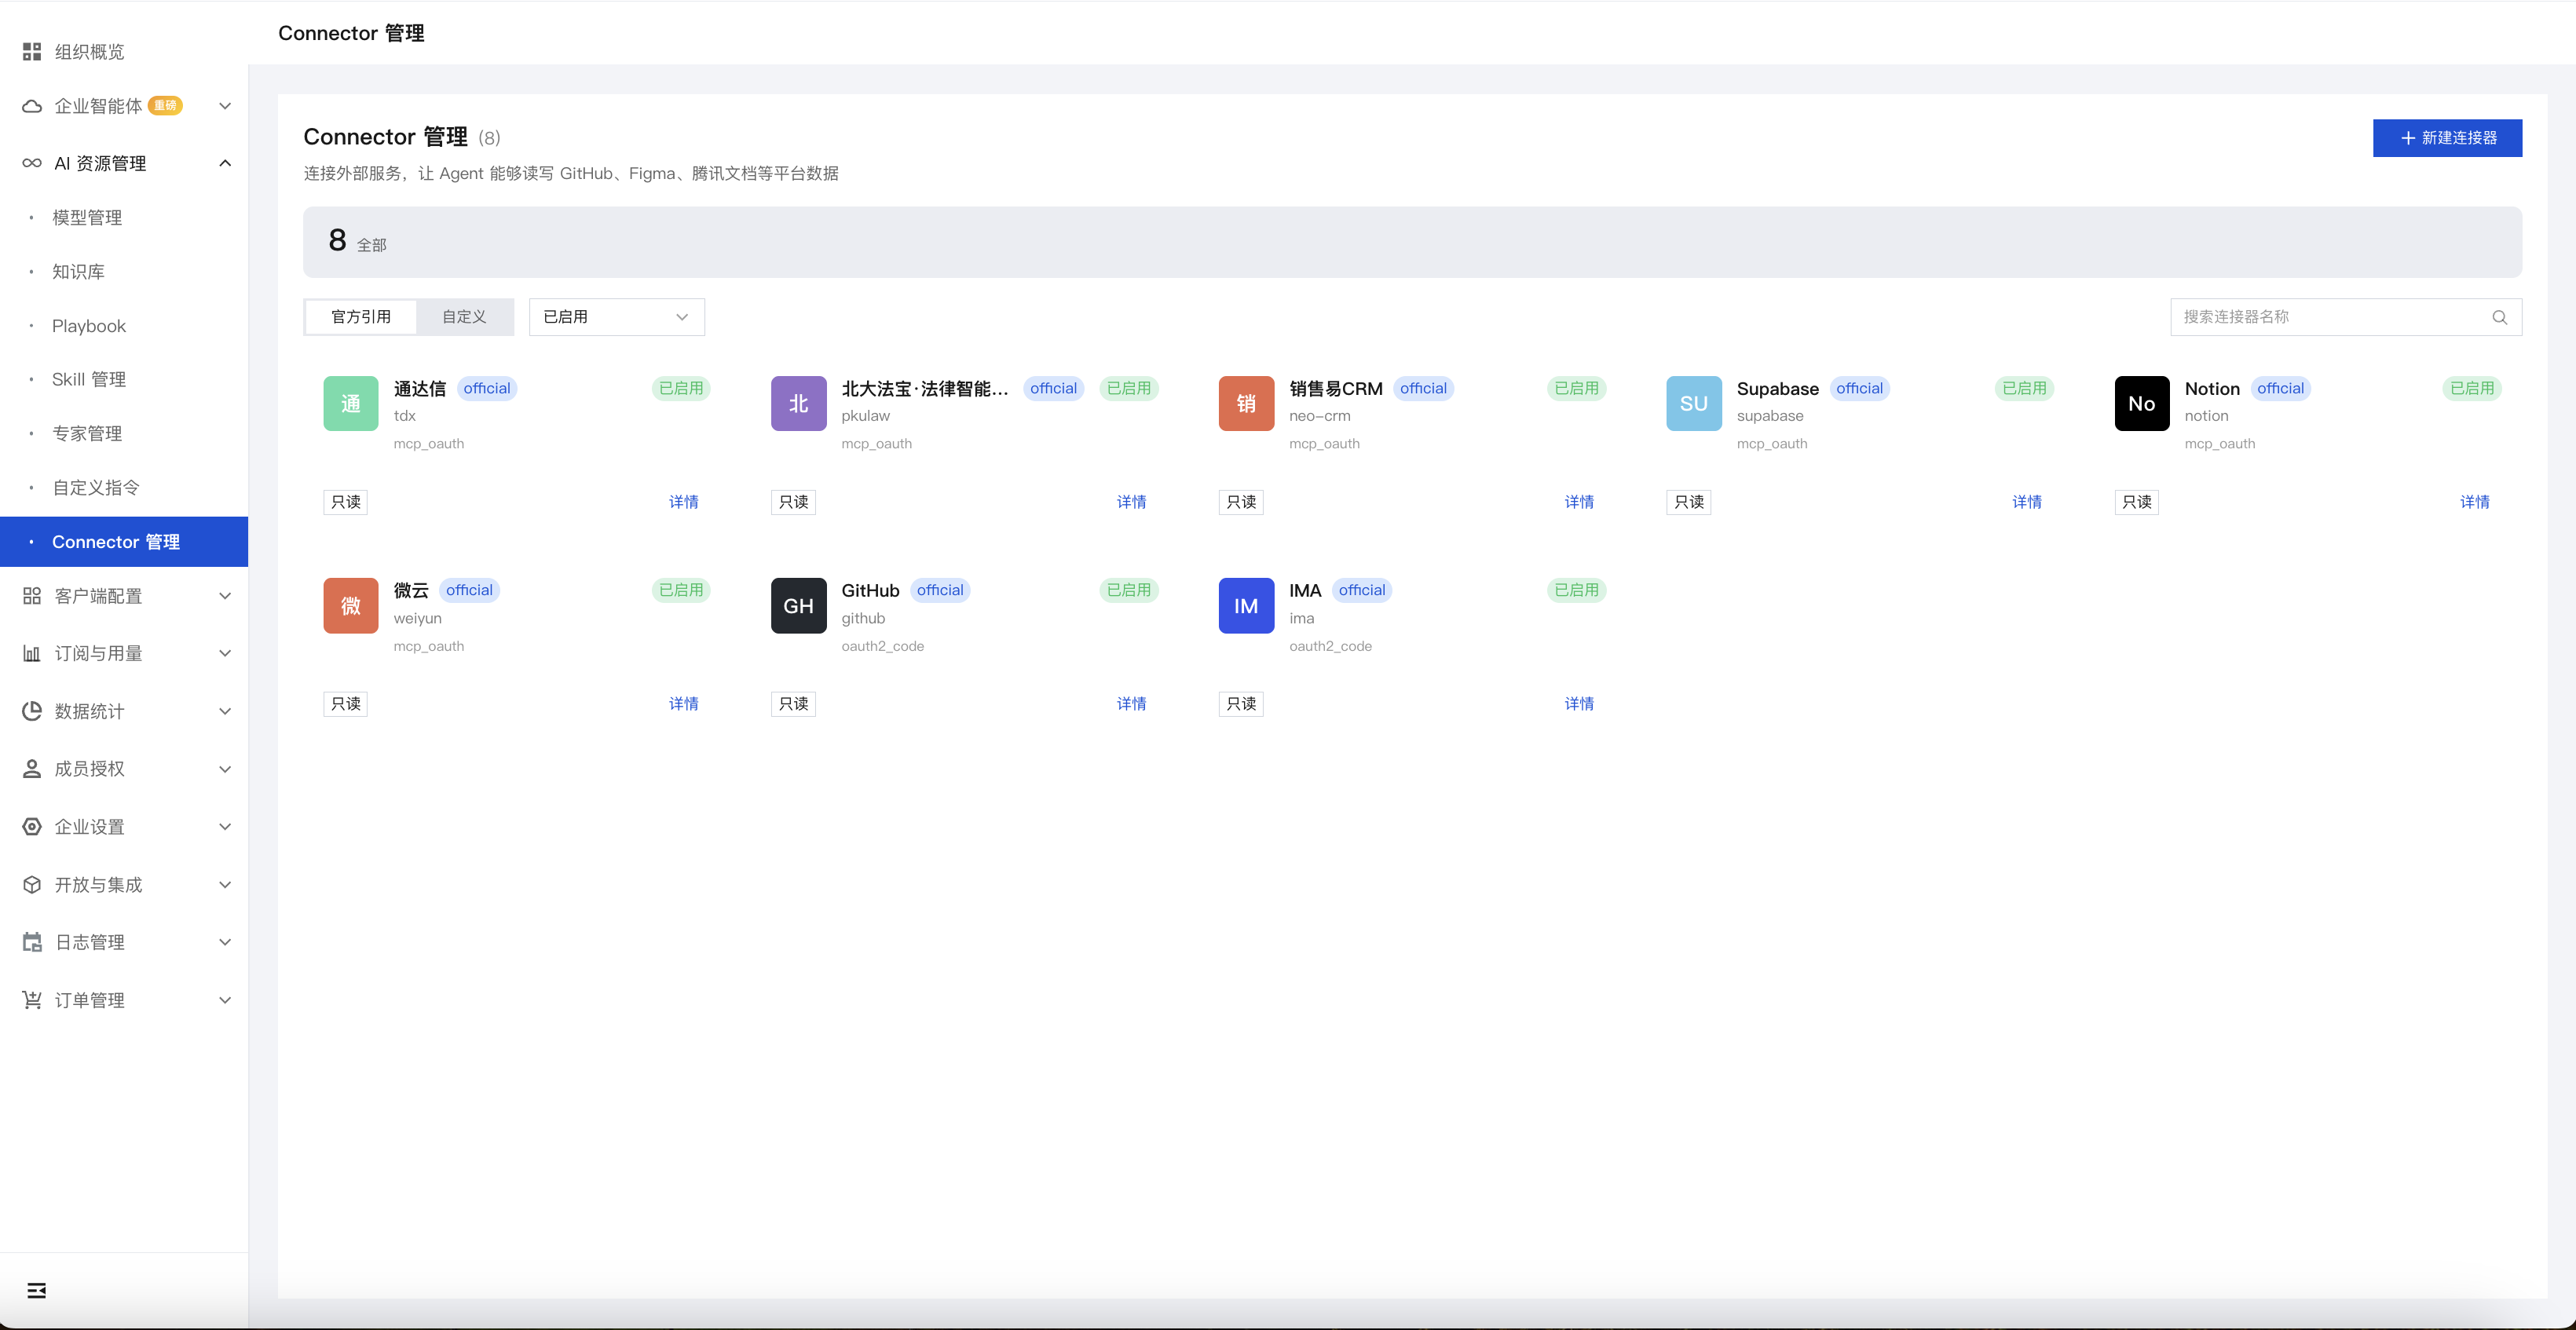
MCP(模型上下文协议)= AI 与外部系统的标准通信协议:
没有 MCP 的时候,接邮箱写一套代码,接文档又写一套;
有了 MCP,所有系统用同一套接口标准——就像所有手机都用 Type-C 充电,不用每个品牌配一根线。
两种连接器类型:
| 类型 | 是什么 | 什么时候用 |
|---|---|---|
| 官方连接器 | WorkBuddy 预置,已对接腾讯系产品 | 企微、腾讯文档、QQ邮箱、TAPD → 一键授权开通 |
| 自定义连接器 | 企业自建 MCP Server | 内部 OA、自建数据库、业务中台 → 按 MCP 规范搭建 |
连接器安全三道关:
① 连之前:谁搭建、谁审批、谁负责?→ 每个自定义连接器必须有明确责任人
② 连上后:能访问什么、能执行什么?→ 最小权限原则,精确到字段级
③ 用起来:操作可追溯吗?→ 开启审计日志,定期审查,不用及时关闭
连接器给 AI 开了一扇通往企业系统的门——门开了,安保也得跟上。
连接器的完整生命周期
连接器不是"搭建完就不管了",需要全程运维:
创建 → 测试 → 发布 → 运行监控 → 异常处理 → 下线

 │      │      │       │         │         │
定义   脱敏    设置    关注      及时      不用
协议   验证    可见    调用量    修复      关闭
               范围    和异常
| 阶段 | 做什么 | 重点关注 |
|---|---|---|
| 创建 | 技术团队按 MCP 规范搭建 Server,管理员在后台录入配置 | 协议版本兼容性 |
| 测试 | 用脱敏数据验证:能正常连接?返回数据格式对吗? | 权限范围是否正确(只读/读写) |
| 发布 | 设置可见部门和可见范围,关联到对应 Agent | 不该看到这个连接器的部门不要开放 |
| 运行监控 | 关注调用量、响应时间、错误率 | 调用量突然暴涨可能是被滥用 |
| 异常处理 | 连接超时、返回异常数据 → 技术团队介入 | 异常时不自动重试敏感操作 |
| 下线 | 不用了及时关闭,避免僵尸连接器堆积 | 下线前检查是否有 Agent 仍在使用 |
配置示例:接入企业内部 OA 审批系统
场景:HR 部门希望 AI 帮员工查询请假审批状态

步骤:
1. 技术团队搭建 OA MCP Server
   - 暴露两个接口:查询请假记录(只读)、查询审批进度(只读)
   - 不暴露:提交请假申请(写入权限不放给 AI)

2. 管理员在 WorkBuddy 后台配置
   - 连接器名称:「OA 请假查询」
   - 类型:自定义连接器
   - 可见部门:HR 部、所有员工
   - 权限:仅查询,不可修改

3. 关联到「HR 助手 Agent」
   - 员工在 WorkBuddy 输入:「我的请假审批到哪一步了?」
   - AI 通过连接器查询 OA → 返回审批节点和当前处理人

关键安全设定:
  ☑ 单向只读:AI 只能查,不能提交或修改
  ☑ 脱敏输出:返回结果不显示审批人手机号
  ☑ 频率限制:单员工每分钟最多查询 5 次
常见坑:
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 权限开太大(读写全给) | AI 可能误操作真实数据 | 默认只读,写入需额外审批 |
| 不做频率限制 | 被循环调用打爆业务系统 | 设置 QPS 上限 |
| 内网地址直接暴露 | 外部无法访问 | 通过网关或 VPN 暴露 |
| 异常不告警 | 连接器失效后无人发现 | 配置监控告警,异常即时通知 |
| 离职员工连接器未回收 | 安全漏洞 | 员工离职同步清理连接器权限 |
七、MCP Server 构建入门 — 不只是技术团队的事
管理者不需要亲自写代码,但需要理解 MCP Server 是什么、怎么来的、怎么管。
什么是 MCP Server(技术视角):
MCP Server = 一个按照 MCP 协议标准封装的服务程序

它做的事就三件:
  ① 暴露工具列表(告诉 AI "我能干什么")
  ② 接收 AI 的调用请求(AI 说"帮我查一下 XX")
  ③ 执行操作并返回结果(查完了,这是结果)
最简单的 MCP Server 长什么样:
以「企业内部文档搜索 Server」为例:

┌─────────────────────────────────┐
│        MCP Server               │
│                                 │
│  工具列表:                      │
│    ☑ search_docs(keyword)       │
│      → 搜索企业文档库            │
│    ☑ get_doc_content(doc_id)    │
│      → 获取文档全文              │
│                                 │
│  只暴露这两个工具,AI 就能:      │
│    "帮我找一下Q2市场策略文档"     │
│    "打开第3页看看执行计划"        │
│                                 │
│  不暴露的工具:                   │
│    ✗ delete_doc(删除文档)      │
│    ✗ modify_permission(改权限) │
└─────────────────────────────────┘
构建 MCP Server 的四个关键决策:
| 决策点 | 选项 | 建议 |
|---|---|---|
| 开发语言 | Python / Node.js / Go | 用团队最熟悉的技术栈 |
| 部署位置 | 企业内网 / 云上 / 本地 | 数据敏感型选内网部署 |
| 认证方式 | API Key / OAuth / 证书 | 生产环境必须加认证 |
| 暴露范围 | 只暴露必要工具,不暴露底层能力 | 一个 Server 只服务一类场景 |
安全红线(构建阶段就要做):
□ 输入校验:AI 传来的参数要校验(不能传 SQL 注入、路径穿越)
□ 权限最小:一个 MCP Server 只暴露必要工具,不开放底层数据库连接
□ 日志记录:每次调用都记录(谁、什么时候、调了什么、结果是什么)
□ 超时控制:单次调用超过阈值自动中断(防止长时间阻塞)
□ 版本管理:MCP Server 代码进 Git,改了什么、谁改的可追溯
以上检查项主要面向技术团队在构建阶段的自我核查。对于不直接参与编码的管理者,审查技术团队方案时可聚焦三个底线问题,直接向团队提问即可判断方案是否可控:
- 暴露了多少工具?有没有写入/删除类操作? → 接口应在 3-5 个以内,写入类操作需逐一说明业务必要性,出现"先开全权限"的理由视为不合理。
- 调用日志是否开启?能查到谁什么时候调了什么吗? → 日志应持久化存储(非仅存内存),至少保留 90 天。
- 谁是责任人?出问题找谁? → 需明确技术负责人和备份联系人,代码和文档有统一存放位置。
MCP Server 本质上是个"守门人"——帮 AI 安全地、受控地访问企业系统。构建时每多暴露一个工具,就多一份安全责任。
核心要点回顾
- Skill = 工具能力,专家 = 角色切换机制(人设+方法论+工具链),连接器 = 系统接口——三者互补
- Skill 三种创建方式覆盖不同技术背景,SkillHub 已有海量现成技能可复用
- 专家设计要写清行业背景、执行 SOP 和安全边界;从开发者视角看,专家 = plugin.json 元信息 + agents/*.md 提示词 + 可选内置 Skill/MCP,按标准目录结构打包为 .zip 提交
- 连接器管理贯穿完整生命周期,安全三道关全程管控
- MCP Server 是连接器的技术底座,构建时遵循权限最小和可审计原则
实战挑战(5 分钟)
从团队日常工作中找出 2 个高频、流程稳定的任务场景,试着为其中一个设计专家角色——列出行业背景、执行 SOP 和安全边界。设计完后想想:这个专家和你直接写 Prompt 有什么本质区别?
6.3 三层递进与团队协作:专家 → 助理 → 项目
读完这节,你能回答:
- 专家→助理→项目,三层递进的逻辑是什么?为什么是递进而不是并列?
- 「项目」空间里人和 AI 怎么协同?
- 资产持续积累的机制是什么?怎么让每次协作都为下一次加速?
一、三层递进总览 — 从个人强化到组织协同
理解三层递进,可以类比一个团队使用专业软件的过程:
每个人学会用 Excel → 单点效率提升。 第二层(助理) :Excel 连上数据库,定时自动刷新报表 → 不再需要手动操作。 第三层(项目) :多人在线共享同一个分析看板,实时协作 → 团队产出质变。
每一步都不是替代上一步,而是建立在上一层的积累之上。
        第三层:项目(组织协同)
        ┌─────────────────────────────┐
        │ 人 + 数字员工 + 同事同一空间协作 │
        │ 共享上下文 · 任务接力 · 资产复用   │
        └────────────▲────────────────┘
                     │ 从个人连接到组织协同
        第二层:助理(远程连接)
        ┌─────────────────────────────┐
        │ 手机/企微/飞书远程指挥电脑干活   │
        │ 持续在线 · 多端触达 · 即时响应   │
        └────────────▲────────────────┘
                     │ 从坐着用到随时用
        第一层:专家(个人强化)
        ┌─────────────────────────────┐
        │ 一句话召唤岗位级 AI 专业能力     │
        │ 角色化 · 有方法论 · 有关联工具    │
        └─────────────────────────────┘
        起点:任何一个员工都能从这里开始
三层不是并列的可选项,而是递进关系——专家层为个人提效打基础,助理层打破桌面限制实现随时响应,项目层将人和 AI 纳入同一协作空间。每一层都是上一层的前提。
如何判断当前在哪一层、该不该升级?
| 当前状态 | 处于哪一层 | 升级信号 |
|---|---|---|
| 每次都要打开电脑、打开 WorkBuddy 手动提问 | 专家层 | 出现「不在电脑前时也想用 AI」的需求 |
| 已经通过手机远程使用,但任务还是自己一个人做 | 助理层 | 出现「需要同事一起参与这个任务」的需求 |
| 已经在项目空间中与人和 AI 协作 | 项目层 | 关注资产沉淀,让每次协作成果持续积累 |
二、第一层:专家 — 带着企业知识去干活
以某游戏公司为例,他们为团队配置了多位领域专家:游戏引擎专家负责 Unreal 代码生产、策划专家辅助关卡设计、全栈工程师专家处理服务端逻辑、内容创作专家生成分镜视频和营销素材。员工的日常工作从「自己查文档 + 自己写」变成了「一句话描述需求,专家在对应领域给出专业级产出」。
| 维度 | 能力 |
|---|---|
| 知识底座 | 接入企业知识库,回答基于企业真实文档,有据可依 |
| 能力组合 | 可关联企业 Skill 完成具体操作,不只是「聊天」 |
| 管理方式 | 管理员统一配置、发布给指定部门,质量和权限可控 |
企业版专家 = 通用 AI 能力 + 企业专属知识 + 组织标准方法论。
三、第二层:助理 — 打破「必须坐在电脑前」
以某连锁消费品牌为例,他们基于 WorkBuddy 打造了 AI 面试系统和门店运营决策平台,推动连锁门店从经验驱动转向数据驱动。员工不在门店时,AI 助理持续处理面试预约、运营数据汇总、异常预警等任务——不再需要人守在电脑前。
| 场景 | 怎么用 |
|---|---|
| 管理层 | 出差途中发消息查询经营数据,AI 拉取报表并推送结论 |
| 远程操控 | 通过微信或钉钉发消息,AI 在办公电脑上执行任务后将结果回传至手机 |
| 跨时区团队 | 海外成员下班前布置任务,AI 在国内时间执行,次日结果已在群内 |
助理层让 AI 从「需要你守着它」变为「它持续在线守着你」——打破物理位置和设备的限制。
四、第三层:项目 — 把人和 AI 装进同一个协作空间
某团队在设计企业级管理平台时,将产品负责人、产品管理专家和原型工程师纳入同一个项目空间:产品管理专家负责需求分析与功能拆解,原型工程师负责页面布局与交互原型,AI 实时预览并反馈调整建议,产出的设计资产自动归档为团队知识库。
| 群聊 | 项目空间 |
|---|---|
| 聊天记录随时间沉没 | 上下文持续维护,可回溯 |
| 文件分散在各人电脑 | 产物自动归档,可检索 |
| 人和 AI 各自独立 | 人和 AI 在同一上下文中接力推进 |
| 做完就散,下次从头来 | 过程产物沉淀为团队资产,下次直接复用 |
项目模式的关键不是「群里多了一个 AI 机器人」,而是 AI 与人在同一个空间中协同推进任务,产物持续沉淀。
五、资产持续积累 — 每次协作都在为下一次加速
这个机制的底层逻辑是:当一次任务完成时,过程和产物不是丢弃而是沉淀,让下一次同类任务起步更快。
以上述游戏公司为例:
第一次做竞品分析:
  策划专家 → 调取竞品信息、产品数据 → 输出分析报告 → 任务完成

如果没有积累:
  第二次做竞品分析 → 重新搜索、重新分析 → 和上次一样从头开始

有了积累之后:
  第一次产出的报告模板 + 分析框架 自动沉淀为 Skill
    ↓
  第二次做竞品分析 → 直接调用 Skill → 自动套用分析框架
    → 只需关注增量信息 → 产出更快、质量更稳定
这个机制的关键不在于某一次任务做得多好,而在于下一次同类任务能否复用上一次的成果。它贯穿三层递进的始终:专家层的产出可以沉淀为 Skill,助理层的有效流程可以固化为自动化规则,项目层的协作产物成为团队知识资产。
核心要点回顾
- 三层递进:专家(带着企业知识干活)→ 助理(打破桌面限制、持续在线)→ 项目(人+AI 同空间协作),每一层以上一层为基础
- 专家层以某游戏公司为例:多位领域专家覆盖策划到营销全流程;助理层以某连锁消费品牌为例:门店运营决策平台驱动数据化转型;项目层以某企业级管理平台为例:产品管理与原型工程并行协作
- 资产持续积累:每次协作的产物沉淀为可复用资产,让团队能力随时间增长
实战挑战(5 分钟)
定位你团队当前在哪一层用 AI,然后找一个「第一个人做完、第二个人能直接用」的工作任务。想想:当前卡在哪儿,才能走到下一层?
6.4 智能体运行与组织治理
读完这节,你能回答:
- Agent、Runtime、Session 三层架构分别管什么?为什么缺一不可?
- Agent 的能力怎么组装?上线要走哪几步?
- 管理后台六大维度分别管什么?企业 AI 治理要点有哪些?
一、Agent、Runtime、Session — 一个智能体的三层架构
    ┌────────────────────────────┐
    │          Agent             │ ← 配置层:定义身份和能力
    │  名称 · System Prompt      │
    │  技能 · 专家 · MCP 工具     │
    │  知识库 · 渠道 · 自动化     │
    └────────────┬───────────────┘
                 │ 部署
    ┌────────────▼───────────────┐
    │         Runtime            │ ← 运行层:让 Agent 真正跑起来
    │  计算资源 · 运行状态        │    一个 Agent 可有多个 Runtime
    │  测试环境 / 正式环境        │    (测试一套、正式一套)
    └────────────┬───────────────┘
                 │ 承载
    ┌────────────▼───────────────┐
    │         Session            │ ← 会话层:每次用户交互的记录
    │  上下文 · 消息历史 · 文件   │    不同用户的 Session 相互独立
    └────────────────────────────┘
| 组件 | 管什么 | 怎么管 |
|---|---|---|
| Agent | 身份定义、能力组合、发布状态 | 配置完先测试 → 验证通过再发布 |
| Runtime | 运行状态、资源占用、异常停止 | 监控运行状态 → 异常时查日志 |
| Session | 会话内容、调用链路、回复质量 | 关注异常回复和敏感信息泄露 |
以上三层中,Runtime 层的实际承载由 Managed Agents 提供——它是 WorkBuddy 企业版中的云端托管运行服务,每个 Agent 独享隔离沙箱与数据环境,具备独立身份与全程审计,支持版本管理与状态快照。
Agent 定义"能做什么"、Runtime 确保"跑得起来"、Session 记录"做了什么"——三层各管各,缺一不可。
二、Agent 能力组装 — 不是能力越多越好
一个「企业行政助手 Agent」的配置逻辑:

  ☑ 关联:周报汇总 Skill、会议纪要 Skill、热点摘要 Skill
  ☑ 关联:报销咨询专家
  ☑ 关联:企业知识库 MCP 工具、企业微信通知 MCP 工具
  □ 不关联:代码审查 Skill(行政场景用不到)
  □ 不关联:CRM 客户系统 MCP(行政场景不需要)

  原则:Agent 只关联其服务场景所需的能力
           多关联一个不必要的入口,就多一个出错和消耗的风险
能力组装清单:
| 能力类型 | 选择原则 | 风险点 |
|---|---|---|
| Skill | 只关联与业务目标直接相关的 Skill | 无关 Skill 可能导致误调用 |
| 专家 | 只关联专业方向匹配的专家角色 | 专家数量过多,员工不知道选哪个 |
| MCP 工具 | 优先只读工具,写入工具慎开 | 写入类工具需要人工确认机制 |
| 知识库 | 选择与 Agent 服务场景匹配的知识库 | 知识库权限过大可能导致信息泄露 |
Agent 的能力配置遵循"够用就好"原则——先确认场景需要什么,再决定关联哪些能力。
实际案例:三个典型 Agent 的组装方案
同一家公司的不同部门,Agent 配置差异很大——场景决定能力:
┌── 「行政助手 Agent」— 行政部 ──┐
│                               │
│  服务:全员日常行政支持         │
│                               │
│  关联 Skill:                  │
│    ☑ 会议室预约 Skill           │
│    ☑ 差旅报销模板 Skill         │
│    ☑ 入职指南查询 Skill         │
│                               │
│  关联专家:无                   │
│                               │
│  关联 MCP:                    │
│    ☑ 企业日历(只读)           │
│    ☑ 公司制度库(只读)         │
│                               │
│  ✗ 不关联:财务审批 MCP(只查不批)│
│           IT 运维 Skill        │
└───────────────────────────────┘

┌── 「数据分析 Agent」— 运营部 ──┐
│                               │
│  服务:运营团队数据查询与分析    │
│                               │
│  关联 Skill:                  │
│    ☑ SQL 查询模板 Skill         │
│    ☑ 数据看板生成 Skill         │
│    ☑ 异常检测告警 Skill         │
│                               │
│  关联专家:                    │
│    ☑ 数据分析专家(统计方法论)   │
│                               │
│  关联 MCP:                    │
│    ☑ BI 系统(只读查询)        │
│    ☑ 数据库(只读,不含用户数据) │
│                               │
│  ✗ 不关联:用户数据表(合规红线)  │
│           数据库写入权限         │
└───────────────────────────────┘

┌── 「新员工导师 Agent」— HR部 ──┐
│                               │
│  服务:新入职员工前 30 天引导    │
│                               │
│  关联 Skill:                  │
│    ☑ 入职 Checklist Skill       │
│    ☑ 常用工具教程 Skill         │
│    ☑ 常见问题 FAQ Skill         │
│                               │
│  关联专家:                    │
│    ☑ 企业文化导师专家            │
│                               │
│  关联 MCP:                    │
│    ☑ 企业知识库(新人专区)      │
│    ☑ 培训系统(课程查询)        │
│                               │
│  ✗ 不关联:员工薪资 MCP          │
│           HR 内部审批系统        │
└───────────────────────────────┘
设计要点:三个 Agent 都是「够用就好」的范例——行政 Agent 不做数据分析,数据分析 Agent 不碰员工信息,导师 Agent 不访问 HR 内部系统。每个 Agent 的能力边界清晰、权限最小。
三、企业智能体构建实战 — 什么时候做什么、从零怎么搭
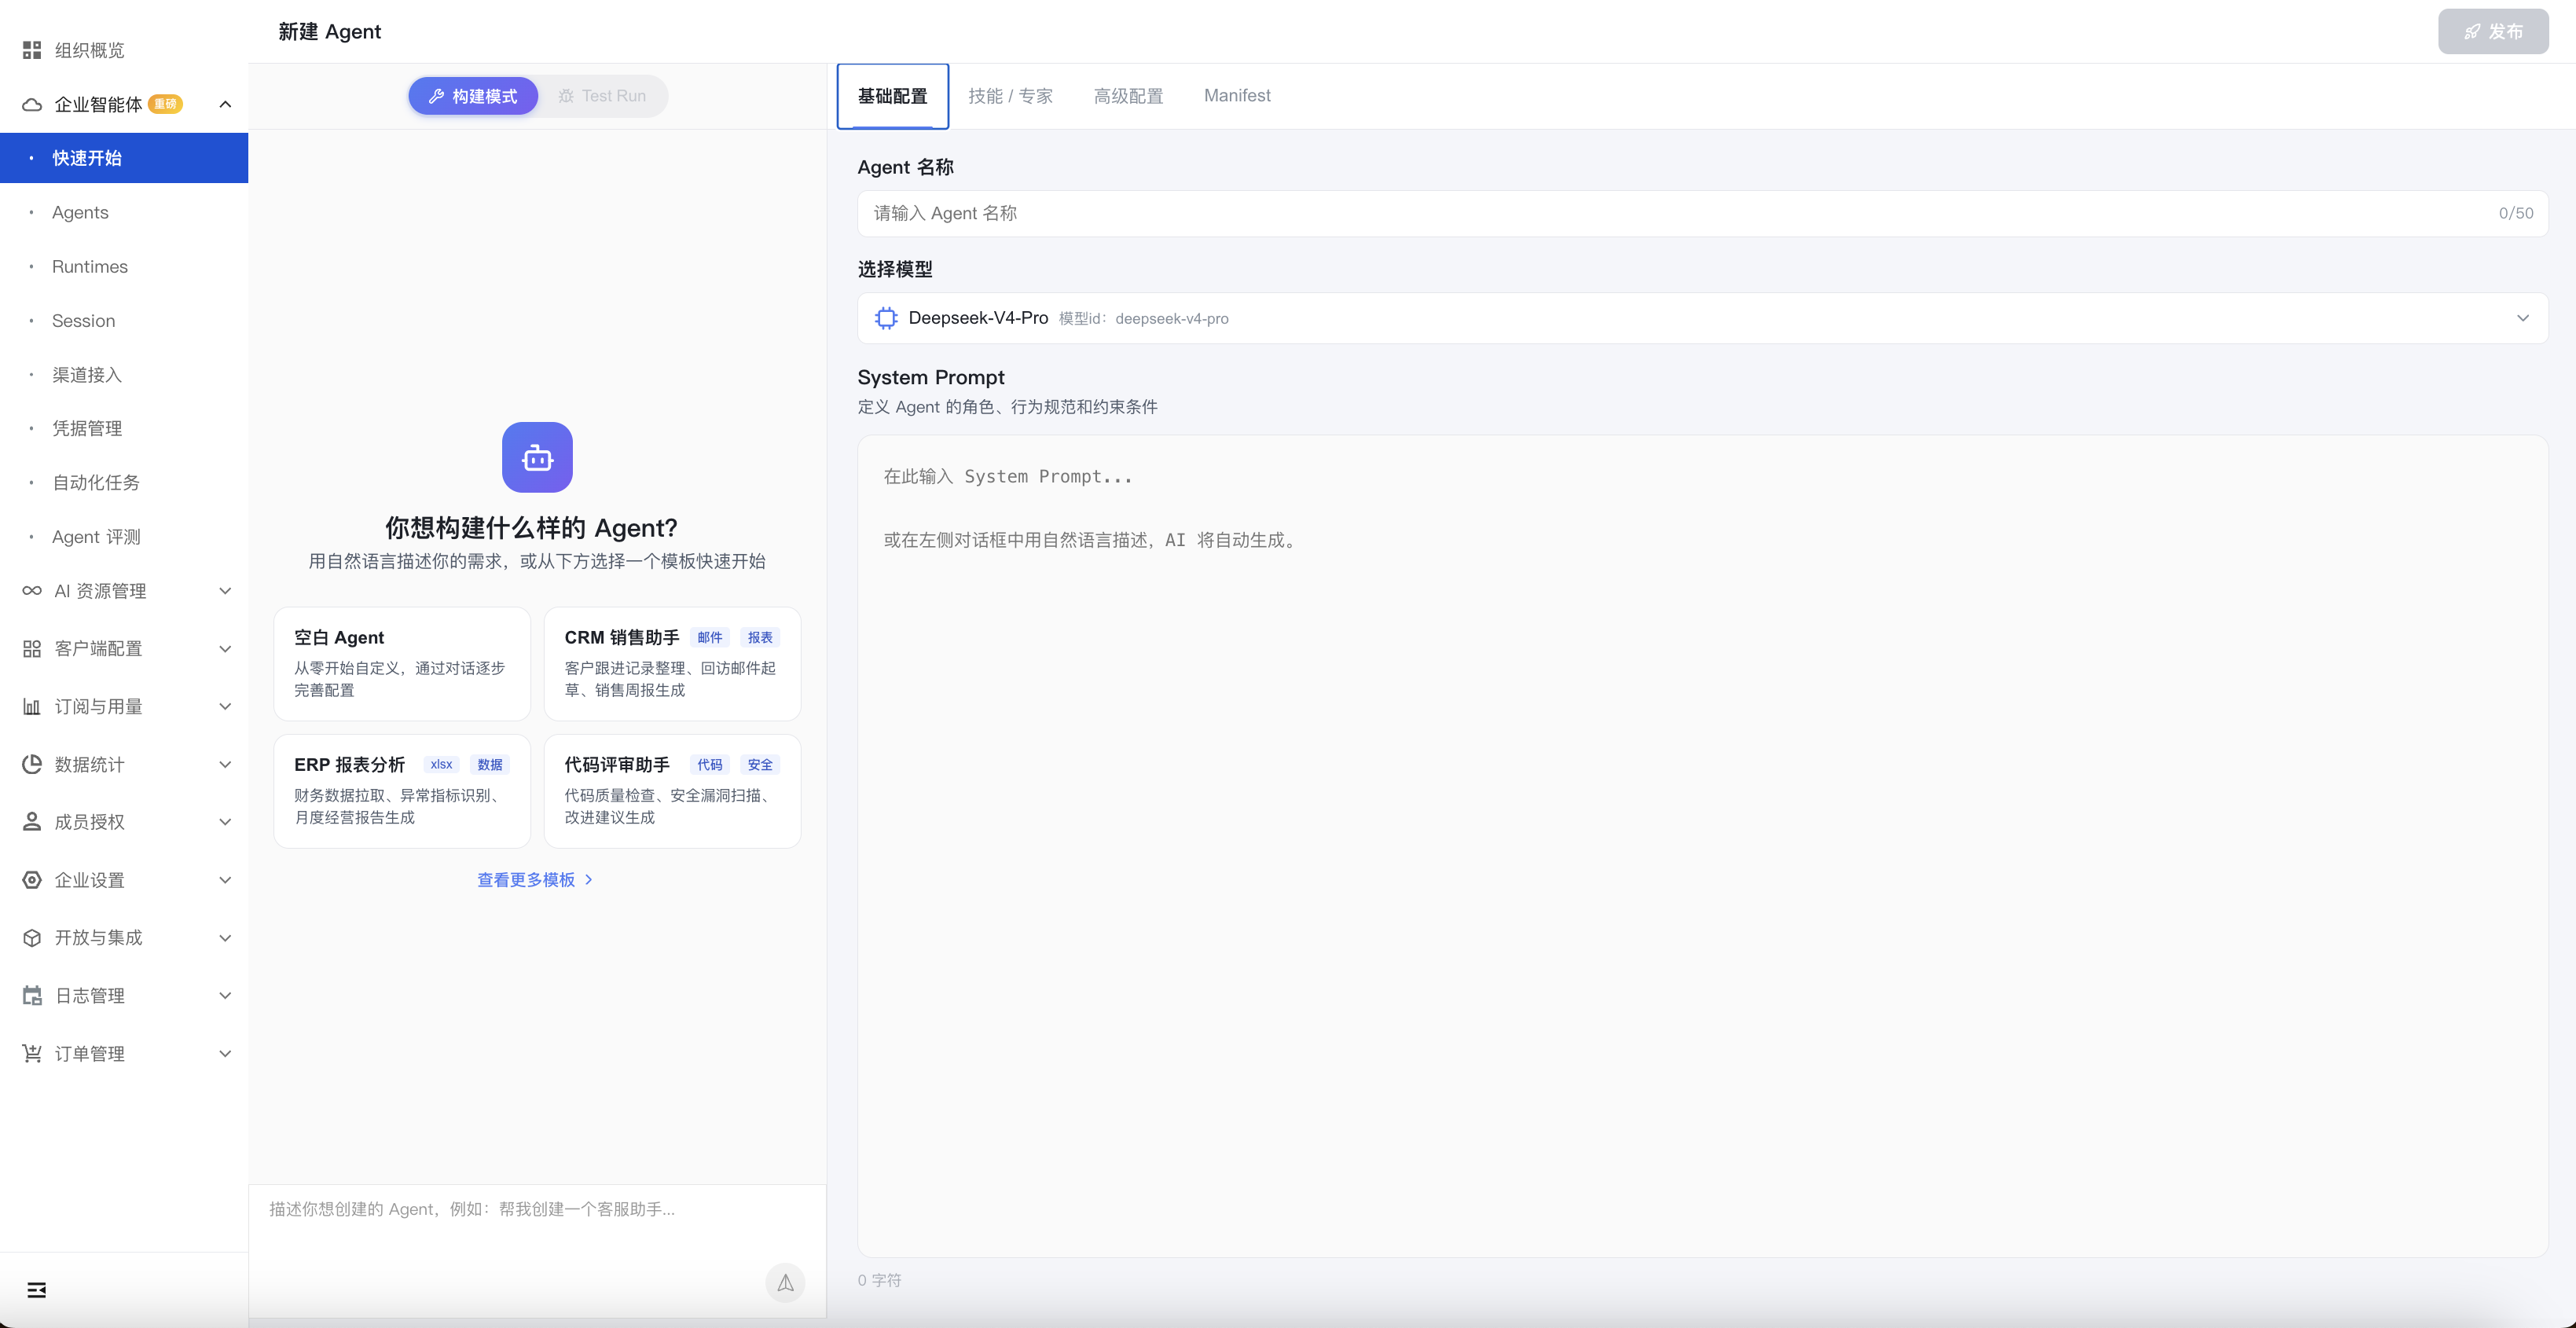
构建一个企业级 Agent 不同于单次对话或简单 Skill 封装——它需要业务理解、技术配置和持续运维三层能力的配合。
前置条件:构建 Agent 需要什么
| 条件 | 说明 | 是否必须 |
|---|---|---|
| 明确的业务场景 | 有具体的使用者、使用频次和期望产出,不是"试试看" | 必须 |
| 可梳理的标准流程 | 业务流程可以被拆解为清晰的步骤和判断规则 | 必须 |
| 可接入的数据源 | 需要的数据能通过 MCP 或 Skill 访问到 | 必须 |
| 管理员权限 | 创建和发布 Agent 需要企业管理后台的操作权限 | 必须 |
| 业务骨干参与 | 有人能提供领域知识、典型场景和验收标准 | 推荐 |
| 技术对接能力 | 如需自建 MCP Server,需要开发团队配合 | 按需 |
所需角色与难度
| 角色 | 职责 | 工作量 |
|---|---|---|
| 业务负责人 | 定义场景边界、提供验收标准、参与试运行反馈 | 中(持续参与) |
| 管理员 | 在后台创建 Agent、配置权限与可见范围、监控运行 | 低(配置为主) |
| 开发工程师 | 编写 System Prompt、对接 MCP Server、自查安全边界 | 中(一次性投入为主) |
| 种子用户 | 试运行阶段真实使用、反馈问题 | 低(日常使用即可) |
整体难度:对简单场景(纯对话型 Agent),熟悉产品后半天内可完成;对复杂场景(需新建 MCP Server 或多工具协同),涉及开发资源投入,需要 1-2 个角色的跨职能配合。
工作原理:一个 Agent 是如何运转的
用户发起任务
    │
    ▼
Agent 接收请求(System Prompt 定义角色与边界)
    │
    ├── 需要数据?──→ 调用 MCP Server 查询外部系统 ──→ 返回结构化数据
    │
    ├── 需要执行操作?──→ 调用关联 Skill 执行脚本 ──→ 返回执行结果
    │
    ├── 需要专业判断?──→ 调用关联专家做子领域分析 ──→ 返回建议
    │
    ▼
Agent 整合所有结果,按 System Prompt 定义的格式输出
    │
    ▼
结果交付给用户(同时被记录到 Session,成为审计和迭代的依据)
关键点:Agent 本身是一个调度中心——它按 System Prompt 中定义的逻辑决定何时调用哪个工具、如何整合结果、以什么格式输出。工具的权限和边界由管理员在配置阶段设定,Agent 无法越权。
决策框架:四种方式怎么选
一个任务摆在面前,判断路径:

① 一次性问答?                     → 直接对话即可
   例:「今天天气怎么样」「解释一下KPI」

② 高频+流程固定+输入输出标准?      → 做成 Skill
   例:每周汇总部门周报、每次发布会前跑checklist

③ 需要专业判断+方法论+领域知识?     → 做成专家(Agent 型)
   例:市场分析、法律风险评估、代码审查

④ 需持续运行+多工具协同+定时触发?   → 在企业后台创建 Agent
   例:定时运维巡检、新员工入职引导、客服质检
   注:Agent 在后台配置后常驻云端运行,可关联多个专家和 Skill
从零搭建一个 Agent 的完整步骤:
以运维场景为例。通过定义角色边界(System Prompt)、注入环境信息(监控系统与日志平台的 MCP 连接)和维护长期记忆(故障模式库),可以搭建一个持久运行的企业运维 Agent。其构建过程可归纳为以下五步:
┌── 第一步:明确业务场景 ──────────────┐
│                                      │
│  谁用:运维团队                       │
│  做什么:定时巡检关键服务状态,        │
│          发现异常自动告警并输出初步    │
│          排查方向                      │
│  安全边界:只做巡检和诊断,不做任何     │
│            变更操作                    │
│                                      │
└──────────────────────────────────────┘
              ↓
┌── 第二步:设计能力清单 ──────────────┐
│                                      │
│  Skill:                             │
│   ☑ 服务健康检查 Skill               │
│   ☑ 日志异常检测 Skill               │
│   ☑ 告警通知模板 Skill               │
│                                      │
│  专家:                              │
│   ☑ 运维故障诊断专家(常见故障模式库  │
│       与排障 SOP)                    │
│                                      │
│  MCP 工具:                          │
│   ☑ 监控系统 API(CPU/内存/磁盘,    │
│       只读)                          │
│   ☑ 日志平台查询接口(只读)          │
│                                      │
│  不关联:                            │
│   ✗ 服务器 SSH 执行权限              │
│   ✗ 数据库写入接口                   │
│                                      │
└──────────────────────────────────────┘
              ↓
┌── 第三步:编写 System Prompt ────────┐
│                                      │
│  "你是企业 IT 运维巡检 Agent。        │
│                                      │
│   职责:                             │
│   - 定时巡检核心服务状态             │
│   - 发现异常立即告警,附带初步排查方向│
│   - 对告警进行分级(P0/P1/P2)        │
│                                      │
│   工作方式:                          │
│   - 先查监控大盘,再查异常服务日志    │
│   - 对照故障模式库匹配已知类型         │
│   - 输出:异常描述 + 影响范围        │
│           + 可能根因 + 建议排查方向   │
│                                      │
│   安全边界:                          │
│   - 只读巡检,不执行变更操作          │
│   - P0 告警须通知值班人,不可仅推群    │
│   - 不确定的根因标记为'需人工确认'     │
│   - 不访问用户数据和业务数据库"         │
│                                      │
└──────────────────────────────────────┘
              ↓
┌── 第四步:试运行验证 ────────────────┐
│                                      │
│  - 用历史告警数据回放:               │
│    诊断结论与真实处理结果一致性如何   │
│  - 注入异常场景:                    │
│    Agent 能否检测并正确分级           │
│  - 邀请运维同事试用:                 │
│    输出是否有用、哪里需要调整          │
│                                      │
└──────────────────────────────────────┘
              ↓
┌── 第五步:发布上线 ──────────────────┐
│                                      │
│  - 设置可见范围:运维团队 + 值班群    │
│  - 配置定时巡检周期                   │
│  - 关联告警通知 MCP                   │
│  - 确认审计日志已开启                 │
│                                      │
└──────────────────────────────────────┘
构建 Agent 的三个原则:
| 原则 | 说明 | 常见误区 |
|---|---|---|
| 场景驱动,不技术驱动 | 先有明确的业务痛点,再决定要不要建 Agent | 工具和接口都准备好了才去找场景,容易造出无人使用的 Agent |
| 权限收紧,逐步放开 | 上线时采用最小权限,运行稳定后再按需扩展 | 一次性关联所有可用 Skill 和 MCP,后续难以排查问题来源 |
| 可观测,可回滚 | 每次改动保留记录,出问题时能快速恢复到上一个版本 | 直接修改后发布,无变更记录,问题定位困难 |
企业智能体构建 = 业务场景清晰 + 能力边界明确 + 权限最小化 + 渐进式上线。关键是解决业务问题,不是技术炫技。
四、Agent 上线流程 — 不验证完不要面对全员
Agent 上线不是配置保存就结束——必须经过验证才能面向真实用户。流程分四个阶段,每个阶段有明确的负责人和验收标准:
① 配置          ② 试运行          ③ 小范围验证        ④ 正式发布 + 持续监控

定义 Prompt     用脱敏样例跑       选种子用户试用       设置可见部门与范围
关联 Skill/MCP   检查输出质量       收集使用反馈         发布使用公告
配置知识库       验证安全边界       调整优化             进入持续监控
| 阶段 | 负责人 | 重点检查 | 跳过本阶段的后果 |
|---|---|---|---|
| 试运行 | 开发工程师 | 用脱敏数据验证输出质量与安全边界,System Prompt 是否足够清晰 | 直接发布后输出不稳定,员工首次使用体验差 |
| 小范围验证 | 业务负责人 | 邀请种子用户在真实场景中试用,关注「能解决实际问题吗」「有越界行为吗」 | 无人知晓 Agent 能干什么,建完就被闲置 |
| 正式发布 | 管理员 | 设置清晰的分类和可见范围,确保目标用户能在后台找到并使用 | 分类错误或权限遗漏,该用的人找不到 |
| 持续监控 | 管理员 | 关注 Session 趋势、异常回复比例、用户反馈 | 发布后放任不管,效果随时间衰减 |
Agent 上线 ≠ 配置完直接全员可见,必经「试运行 → 小范围验证 → 确认有效 → 正式发布」四个阶段。
五、管理后台 — 让数字员工「可管理、可衡量、可优化」
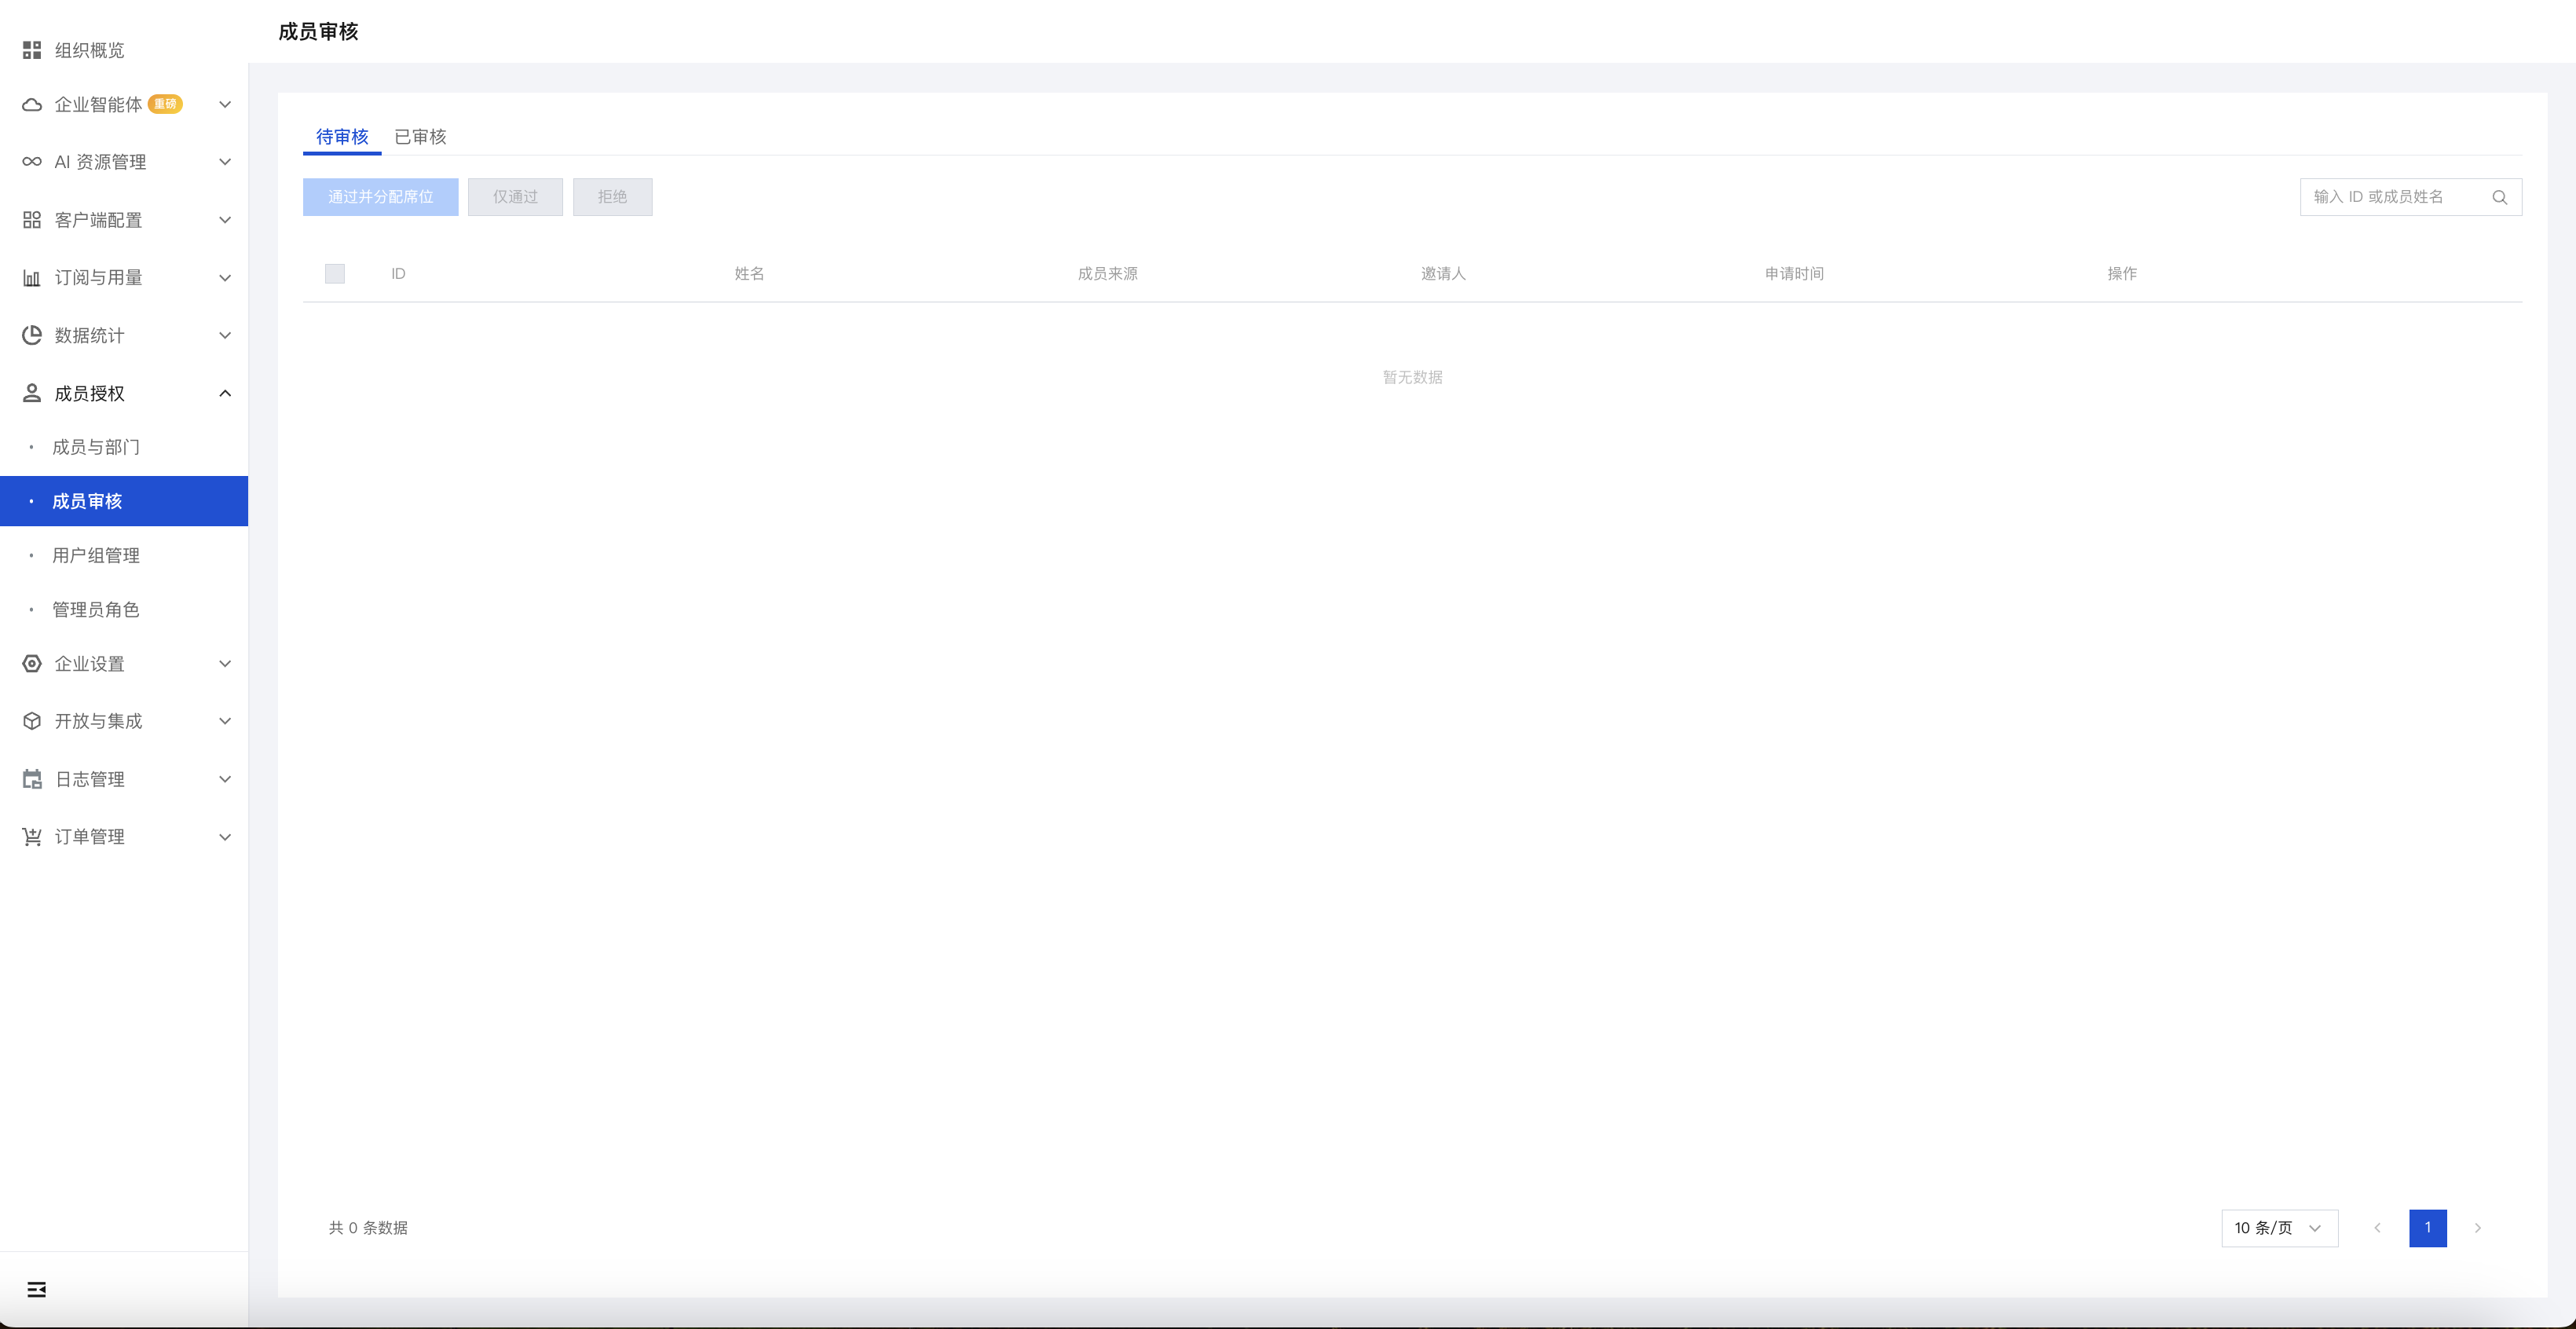
企业管理后台是 WorkBuddy 企业版统一治理的中枢,涵盖运行观测、资产管理、组织权限、安全审计和成本分析。以下六个维度对应管理者日常最关心的问题:
| 管理维度 | 管理者关心什么 | 后台能做什么 | 实际用法举例 |
|---|---|---|---|
| 组织架构 | 谁在用、谁没用,AI 在哪个部门渗透率最高 | 部门设置、成员管理、坐席分配 | HR 部门导入全员后,可按团队分别授权,限制外包人员的使用范围 |
| 资产管理 | 建的 Skill 和专家有多少被复用,哪些已过时需要下架 | 统一管理、发布、下架 Skill / 专家 / 连接器 / 知识库 | 运营团队每月巡检资产列表,关闭三个月无调用的 Skill |
| 权限控制 | 不同岗位看到的能力是否匹配其职责 | 角色边界、可见范围、成员授权 | 普通员工不开放财务审批 MCP;实习岗位不开放客户数据查询 |
| 用量统计 | 各部门花费是否合理,高消耗场景是否值得 | 部门归集、趋势分析、单场景消耗分解 | 市场部消耗激增 → 查看使用明细 → 发现是文案生成集中在同一个 Skill → 评估是否沉淀模板 |
| 安全审计 | 有没有越权操作,有没有敏感信息泄露 | 操作日志、异常告警、会话审查 | 审计发现某 Agent 会话中出现了不应访问的字段 → 收紧该 Agent 的 MCP 权限 |
| 成本管理 | 总预算还剩多少,下季度是否要调整 | 预算设置、超额预警、部门账单 | 季度末自动预警:某部门消耗已达预算 90% → 通知管理者评估是否追加 |
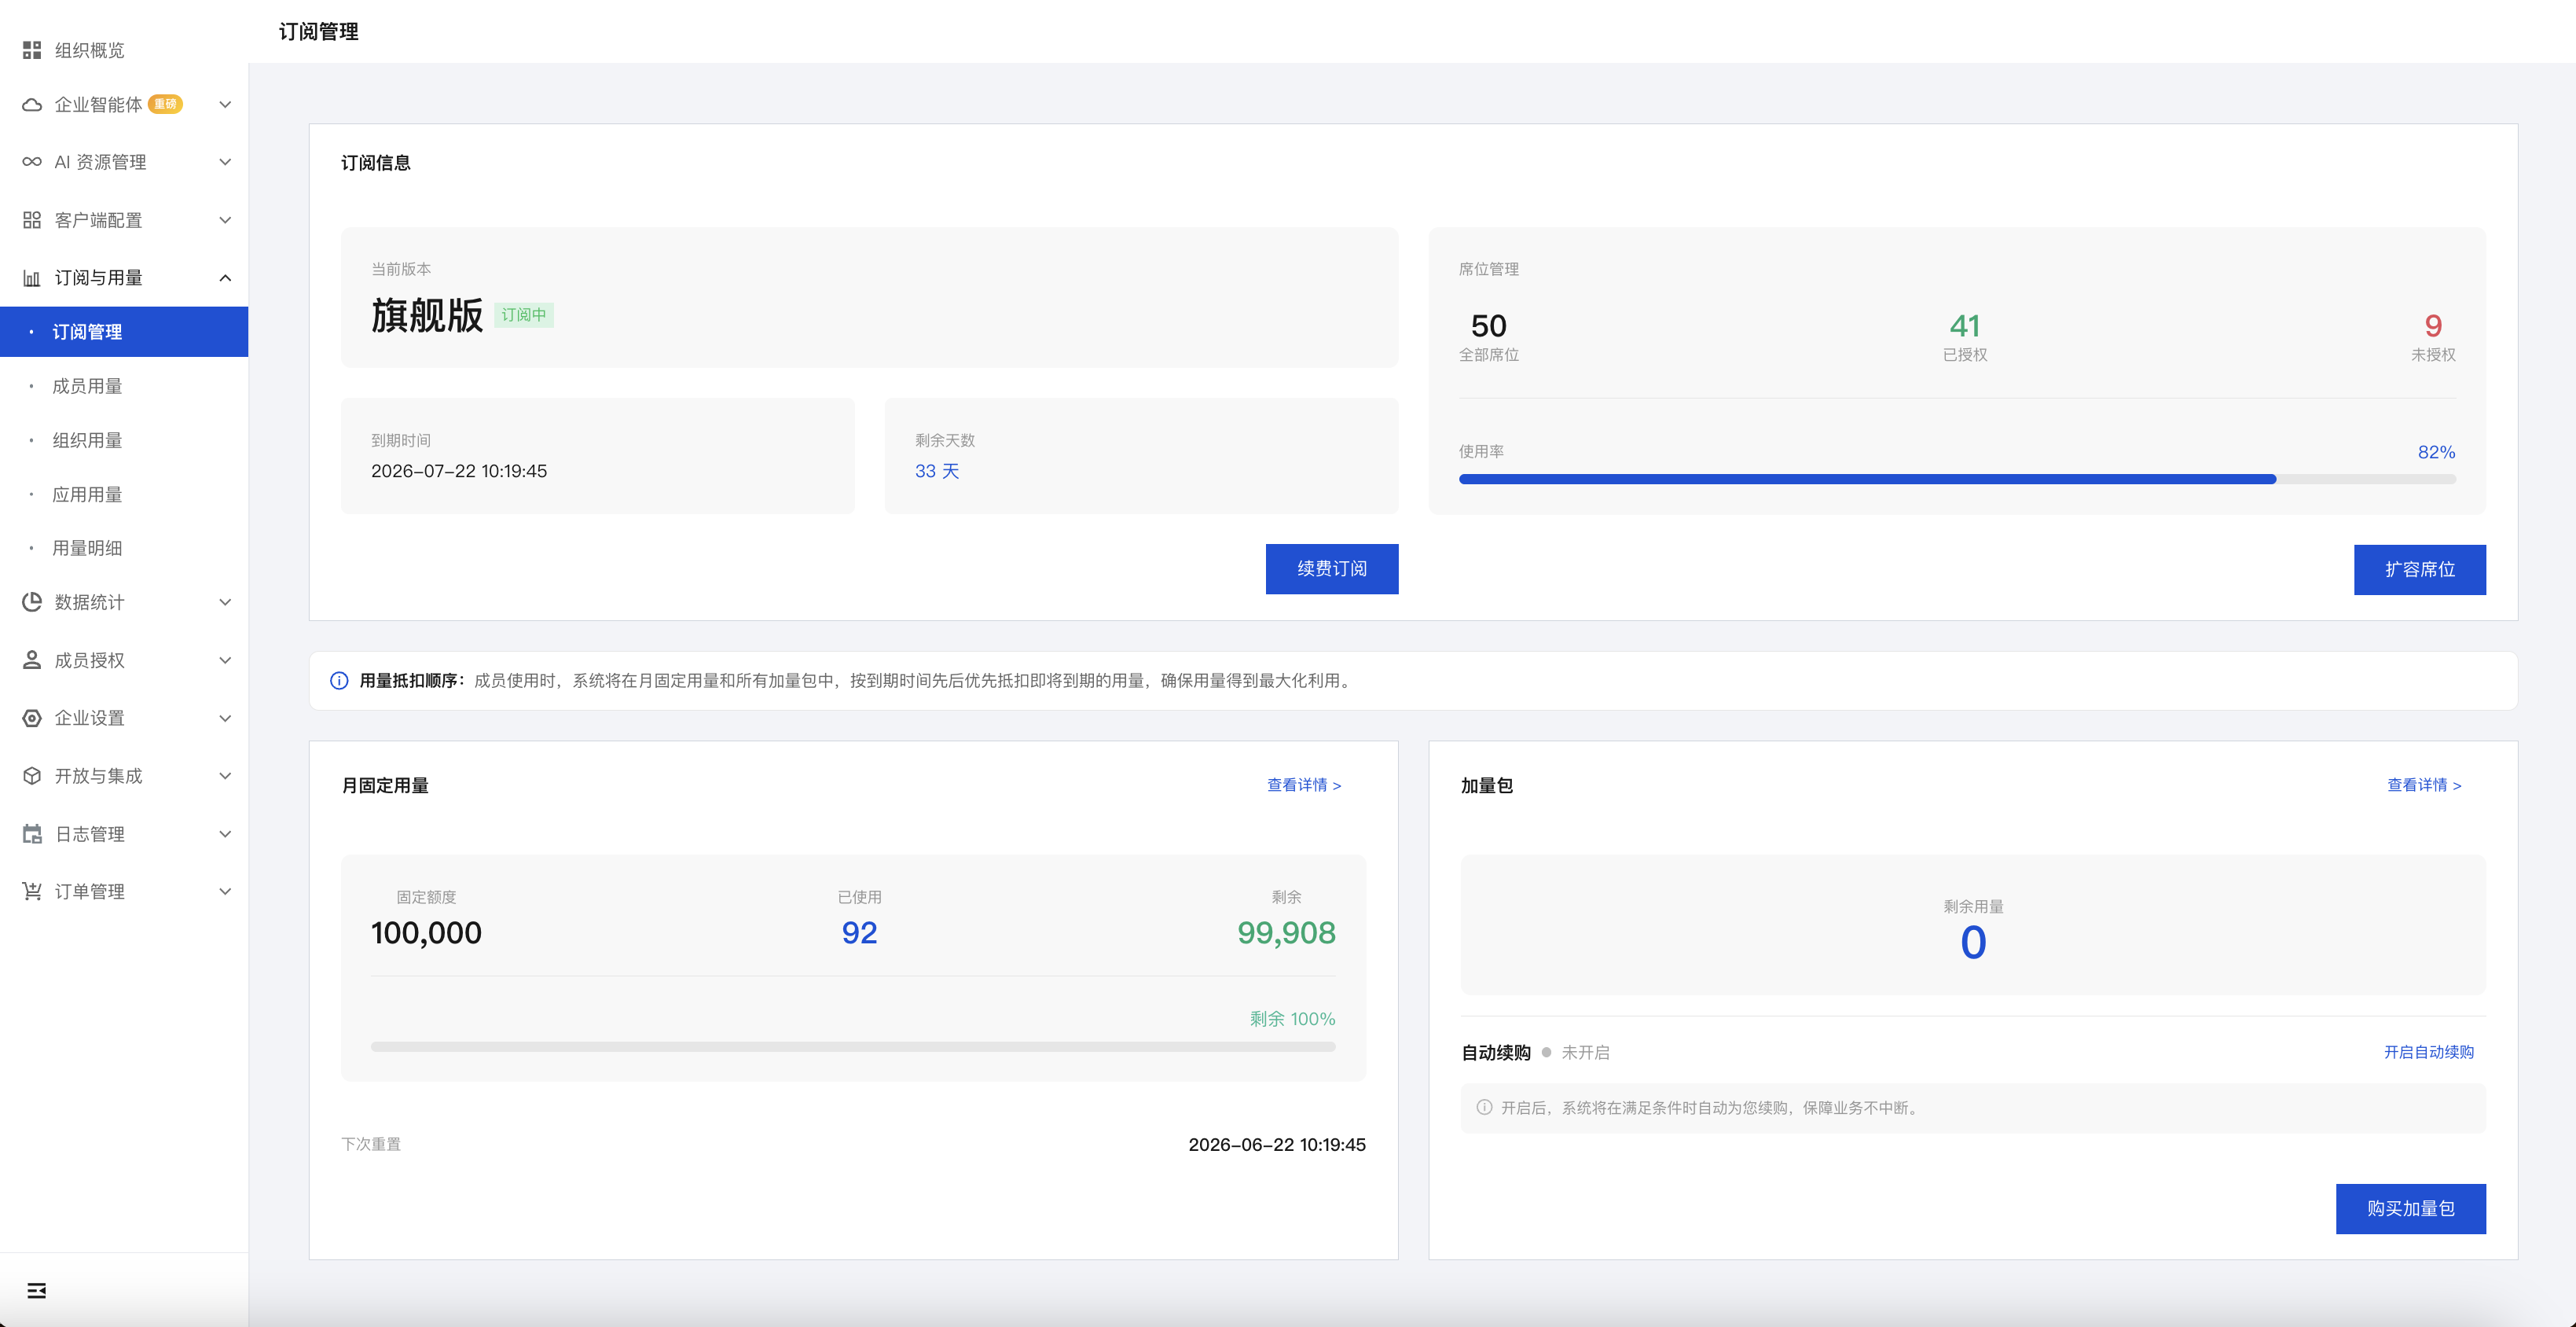
管理后台解决的根本问题是:让 AI 在企业中的使用从「不可见」变为「可管理、可衡量、可优化」,从而将单点的 AI 提效纳入组织的持续治理体系中。
六、企业 AI 治理速查表
AI 治理的起点是「可见」——管理者需要知道 Agent 在组织中是否真正被使用、用在什么地方、产生了什么价值。以下五个维度覆盖了日常治理的核心关注点:
| 关注维度 | 关键指标 | 预期表现 | 低于预期时的应对 |
|---|---|---|---|
| 是否用起来了 | 活跃用户数、周均 Session 数 | 目标部门的活跃率持续上升,周均 Session 保持稳定或增长 | 检查 Agent 场景与员工实际工作是否匹配;组织一次使用培训或示范 |
| 是否用对地方 | 高频使用场景分布、各 Skill 调用占比 | 使用集中在与业务目标相关的场景上,调用分布合理 | 如果出现预期外的使用模式,调整 Agent 的能力范围或补充引导说明 |
| 资产是否积累 | Skill 创建数、知识库更新频率、资产复用次数 | 新需求和经验持续沉淀为 Skill 或知识库条目,复用率上升 | 指定专人定期回顾高价值会话,将可复用的流程提炼为 Skill |
| 成本是否合理 | 部门消耗分布、单场景人均消耗、异常消耗预警 | 消耗集中在核心业务场景,单位产出成本稳定 | 分析高消耗场景的投入产出比;评估是否有更合适的模型或更精简的 Prompt 替代 |
| 安全是否可控 | 审计日志异常数、越权调用记录、敏感信息泄露告警 | 审计日志中无未预期的越权操作,异常告警在合理频率内 | 收紧相关 Agent 的 MCP 权限;排查 System Prompt 是否缺乏足够的拒绝边界 |
建议首次上线后每周巡检一次,待运行稳定后可放宽至每月。关键是在 Agent 数量增长过程中保持治理节奏——Agent 越多,分散管理的风险越大。
七、快速开始 — 企业版上线第一步
企业版上线的核心思路是「先跑通最小闭环,再逐步扩展」,避免一次性全面铺开但无人真正使用。
第一步:架构初始化(管理员)
  ├─ 登录管理后台,完成组织架构导入与成员添加
  └─ 配置基础权限:明确哪些角色可以创建 Skill、发布专家、管理连接器

第二步:选定首个落地场景(管理者 + 业务骨干)
  ├─ 盘点团队中高频重复的任务流程
  ├─ 选择其中最有代表性且流程最稳定的一个场景
  └─ 由熟悉该业务的骨干参与设计,确保领域知识准确

第三步:创建首批能力资产(业务骨干 + 管理员)
  ├─ 将选定场景封装为 Skill(可优先使用指令反向生成)
  ├─ 基于该场景设计对应的专家角色
  └─ 邀请少量种子用户试用并收集反馈

第四步:验证效果并逐步推广(管理者)
  ├─ 查看后台数据:活跃用户、Skill 调用趋势
  ├─ 收集种子用户反馈,识别卡点和改进方向
  └─ 调优确认无误后,逐步扩大至整个部门,再将新经验沉淀为更多资产
启动检查清单:
□ 组织架构与成员导入已完成
□ 首个落地业务场景已确定
□ 场景负责人已明确
□ 首批 Skill 已创建并通过试用验证
□ 种子用户已完成实际使用并反馈
□ 管理者已查看后台数据,确认使用情况
□ 推广计划已确定
企业版上线的关键在于先聚焦一个场景、一个 Skill、一个部门跑通全流程,验证有效后再横向复制。
核心要点回顾
- Agent/Runtime/Session 三层架构:配置层、运行层、会话层各司其职
- 能力组装遵循「够用就好」原则,不关联无关能力
- 企业智能体构建五步法:场景→能力→Prompt→验证→发布
- Agent 上线必经四阶段:配置→试运行→小范围验证→正式发布
- 管理后台六大维度让数字员工可管理、可衡量、可优化
- 企业 AI 治理速查表覆盖五大关注维度,快速自查 Agent 团队的健康状态
- 企业版上线先跑通最小闭环(一个场景、一个 Skill、一个部门),验证有效后再横向复制
实战挑战(5 分钟)
选一个业务场景,搭一个 Agent 方案——列出要关联的 Skill、专家、MCP 工具和知识库。然后想想:这个 Agent 如果上线,你会怎么验证它真的有用?
本章总结
| 章节 | 要点 |
|---|---|
| 6.1 为什么需要升级 | 四个卡点——管理难闭环、团队难协作、知识难传承、资产难治理——让个人提效无法自动变成组织提效 |
| 6.2 能力资产管理 | Skill = 工具能力(三种创建方式+生命周期);专家 = 角色切换机制(设计要素+开发规范:plugin.json + agents/*.md + 目录结构 + zip打包);连接器 = 系统接口(生命周期+安全三道关);MCP Server = 连接器技术底座(按协议构建+权限最小) |
| 6.3 三层递进 | 专家(角色切换+企业知识加持)→ 助理(打破桌面限制,7×24 在线)→ 项目(人+AI 同空间协作)+ 资产持续积累 |
| 6.4 智能体运行与治理 | Agent/Runtime/Session 三层架构 + 能力组装够用就好 + 构建五步法(场景→能力→Prompt→验证→发布)+ 上线四阶段 + 管理后台六大维度 + 治理速查表 |
企业 AI 不在"每个人都会用 AI",而在"每个人的 AI 能力能不能沉淀为组织能力"。建好 Skill(工具)、专家(顾问)、连接器(桥梁)三大资产底座,走通专家→助理→项目的三层递进,让每次协作的成果持续积累——这才是从超级个体到超级团队的完整路径。
定期更新提醒:WorkBuddy 企业版持续迭代,SkillHub 社区技能库每周更新。建议您定期关注版本发布和新增能力,及时将新功能纳入企业 AI 治理体系。
本资料仅供个人学习与备份使用,内容版权归原作者所有