分类:数据分析难度:中等作者:stephenlzc日期:2026-07-24Skill:xlsx
用 WorkBuddy 清洗 119 份门店 Excel 并生成可交互运营看板
场景描述
茶饮连锁品牌「茗悦茶舍」(教学用模拟数据)在全国有约 50 家门店,各门店自行用 Excel 记录每日销售明细并汇总到总部。实际收到的 119 个 .xlsx 文件问题非常典型:
- 列名三套体系并存:中文(日期/品项/销售额)、中文变体(星期/品类/营业额(元)/客流量)、英文(Date/Category/Revenue(¥)/Customers/ATV)
- 结构不一致:14 个文件带大标题行(真实表头在第 2 行),24 个文件按「月」或「季」拆成多个 Sheet
- 日期格式 6 种:
2025-01-01、2025/01/01、2025.01.01、03/03/2025(日/月/年)、03月02日(缺年)、07-05(缺年月日) - 金额字段有噪声:混入 ¥/CNY/RMB/元、千分位逗号,还有「待补录」「--」等缺失标记和负数退货
- 同一门店分散在多个文件:例如北京三里屯店的数据散落在 6 个文件里
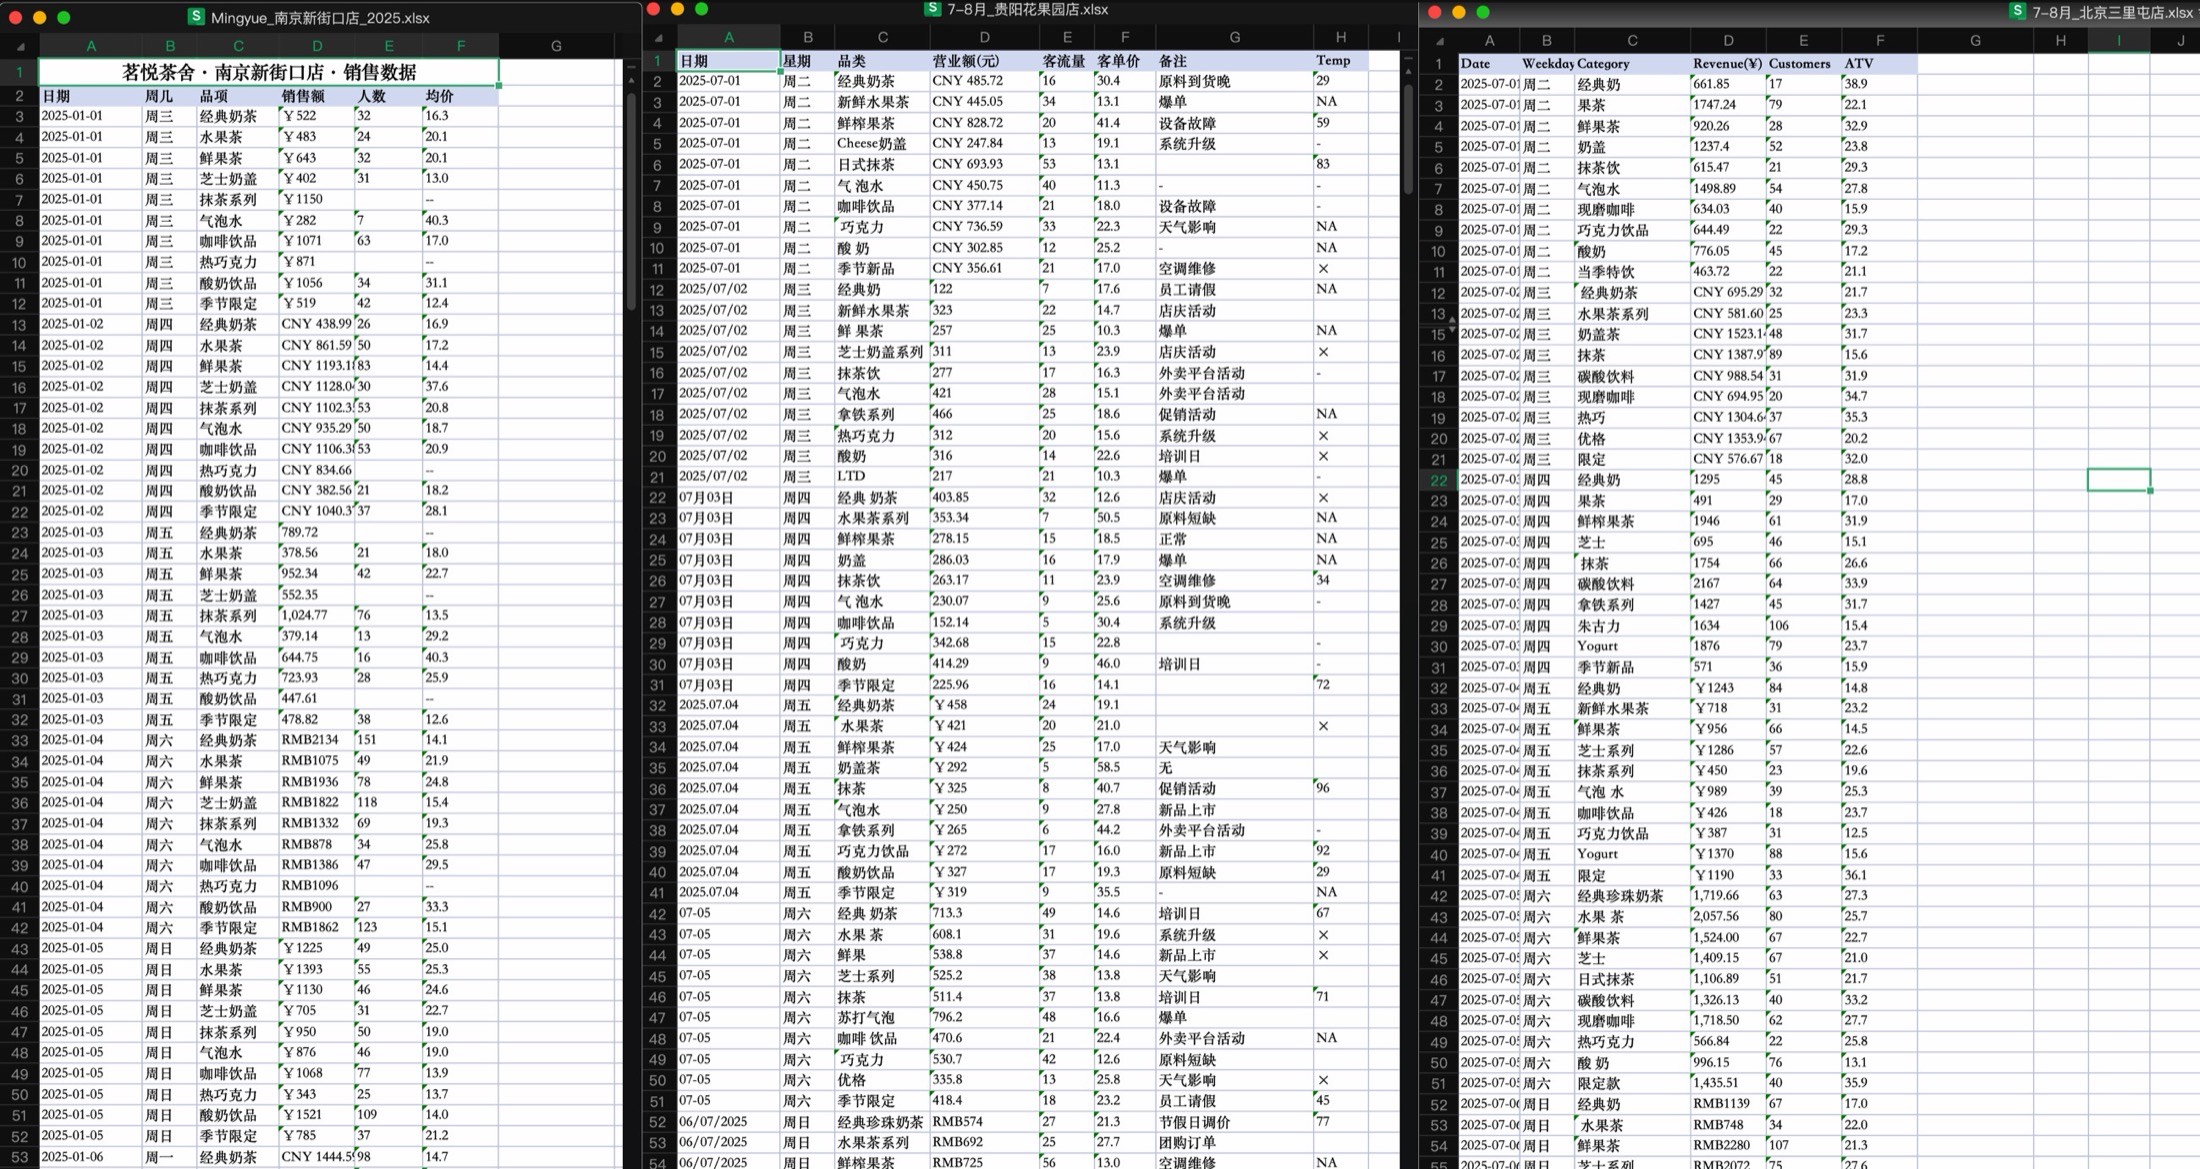
手工合并和清洗这类数据通常需要 6-7 小时,且容易出错。这个案例演示如何把工作一次性交给 WorkBuddy,并拿到可以直接汇报的交付物。
想要完成的任务
输入:sales_data/ 目录下 119 个格式混乱的门店销售 Excel。
目标和交付物:
- 把所有门店数据合并、清洗成一张干净的汇总表(格式统一、去重、口径明确)
- 生成一份多 Sheet 的 Excel 运营分析报告:区域汇总、城市汇总、TOP10 门店、品类占比、月度趋势
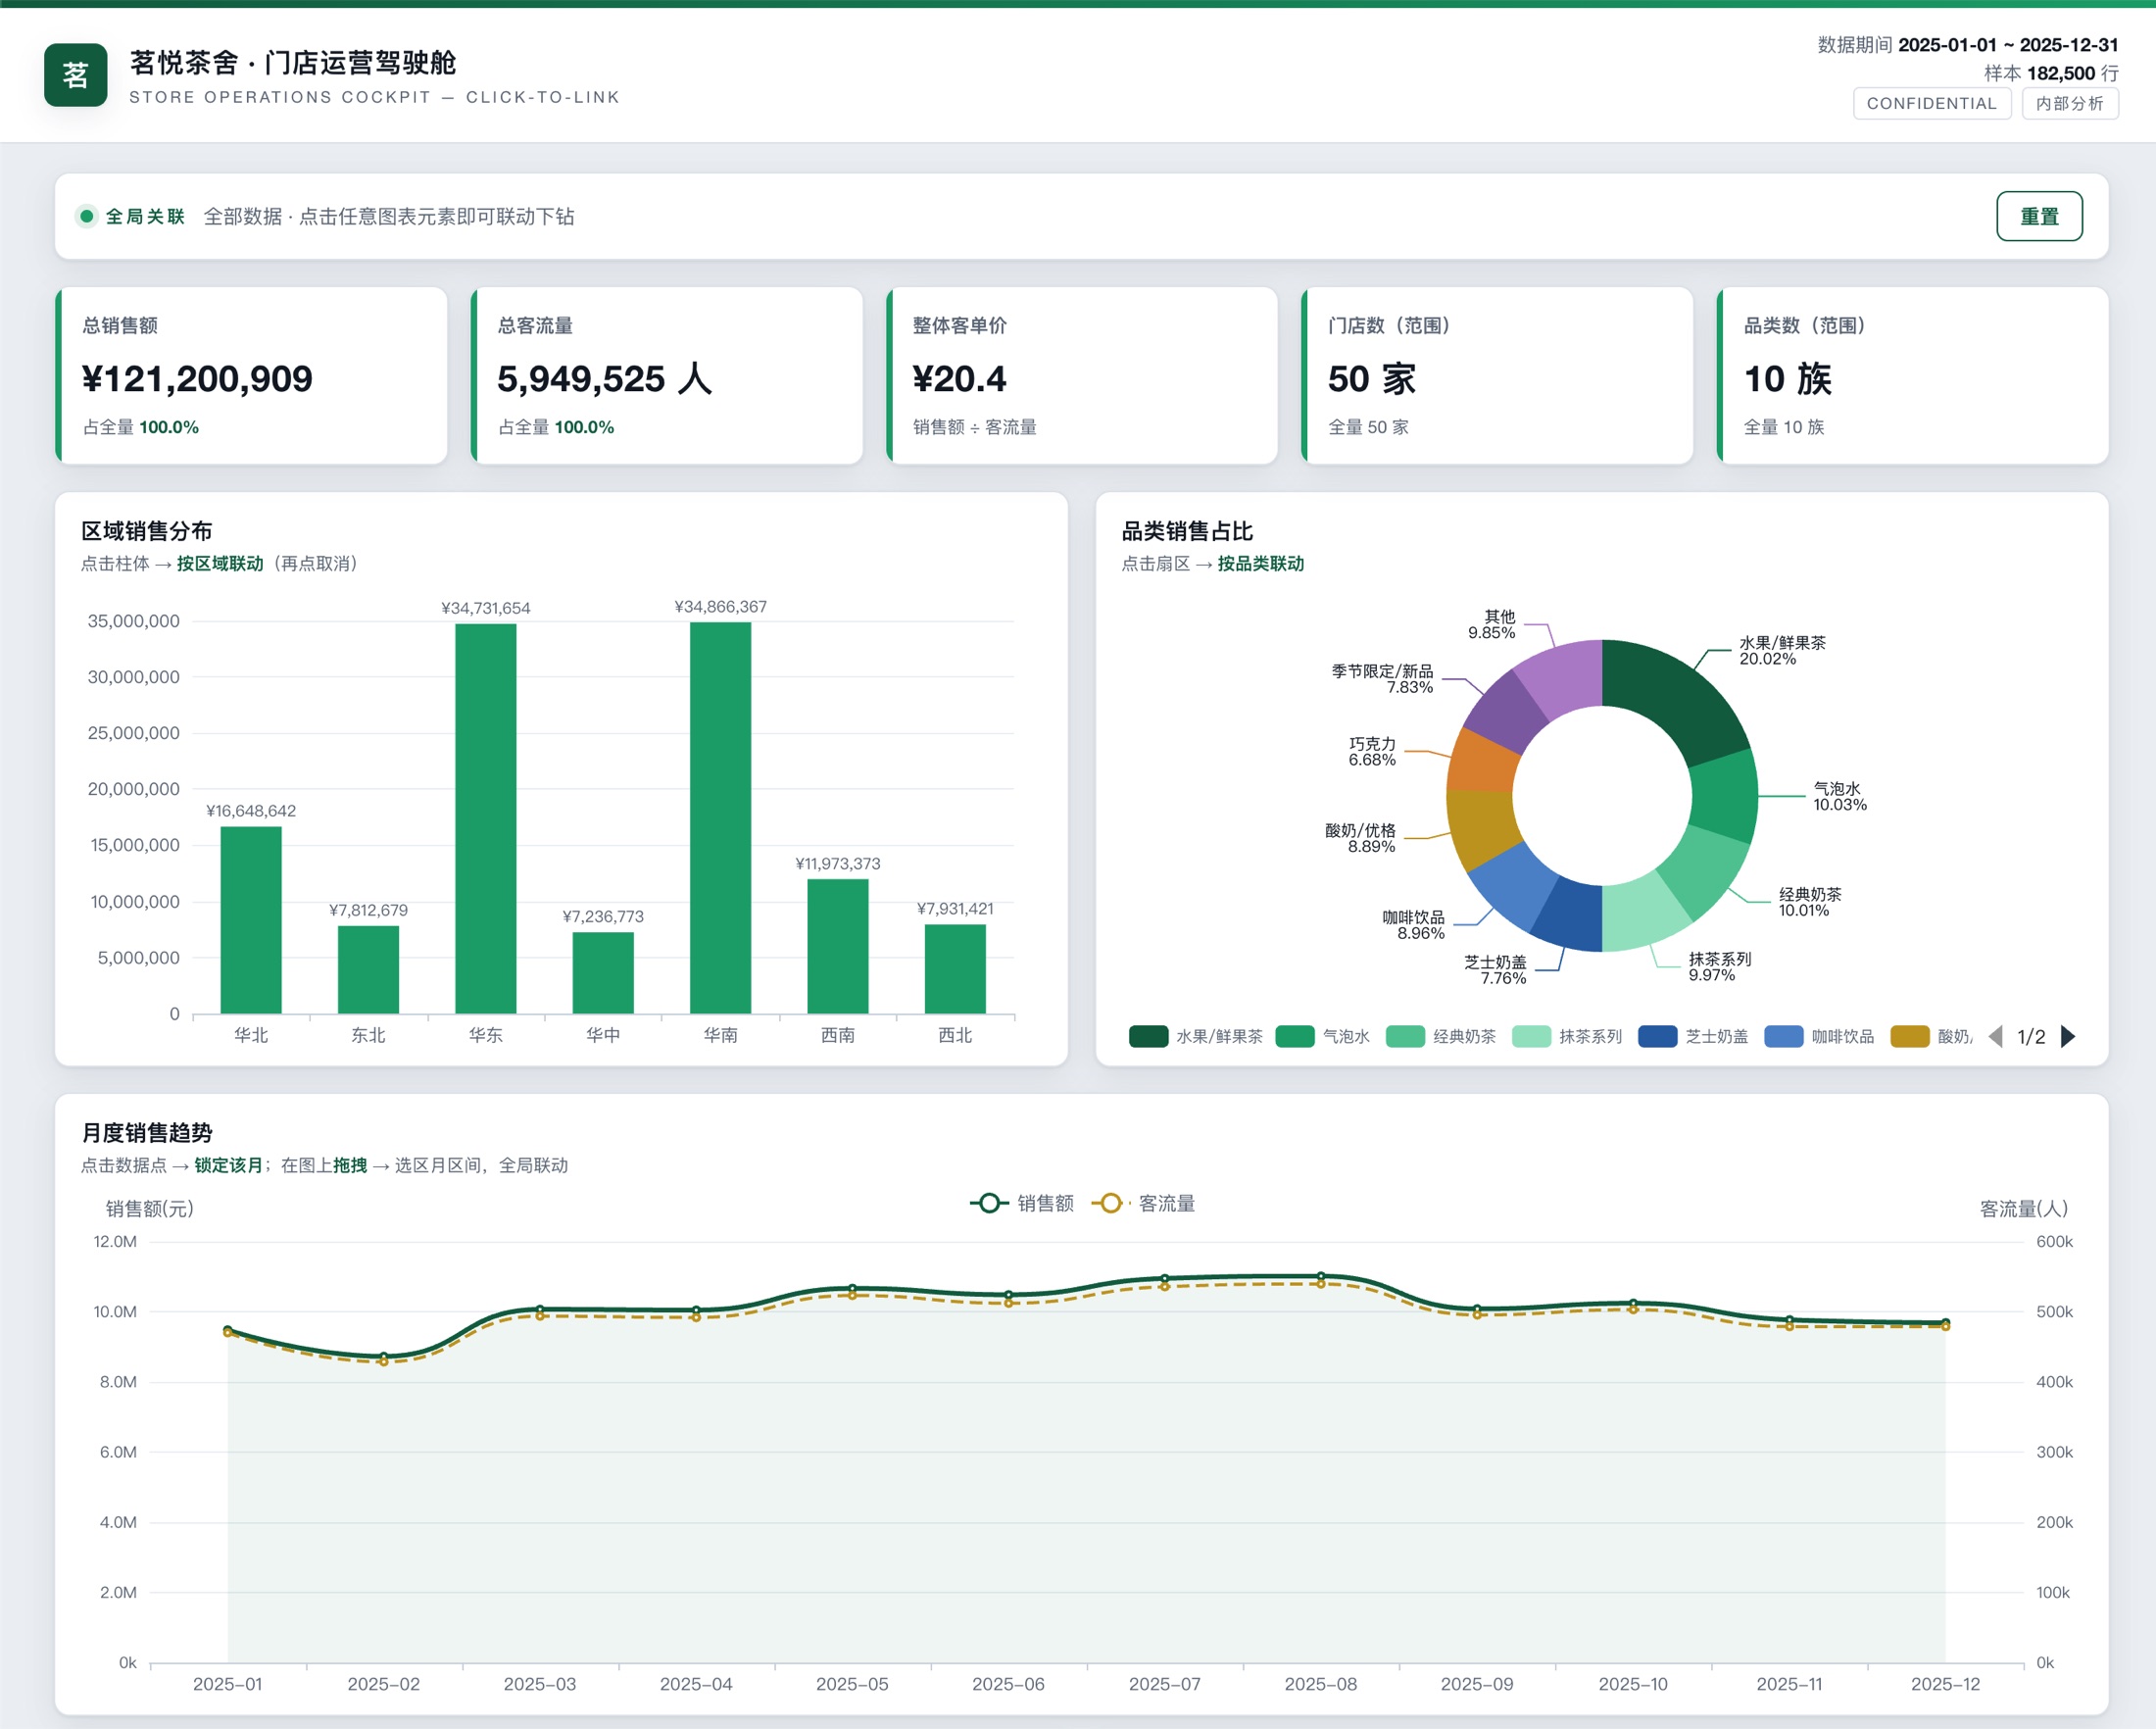
- 生成一个可离线打开的交互式 HTML 看板:点击任意图表维度即全局联动重算(「驾驶舱」式体验)
使用的 Skill
| Skill | 用途 | 来源或安装方式 |
|---|---|---|
| xlsx | 读取/写入 Excel、生成带图表和活公式的分析报告、公式重算校验(recalc) | WorkBuddy 内置 |
其余工作(文件遍历、Python 数据清洗、HTML/ECharts 看板生成)由 WorkBuddy 的通用文件读写和代码执行能力完成,无需额外安装 Skill。
前置条件
- WorkBuddy 可正常使用,能读写本地文件
- WorkBuddy 自带的 Python 环境(pandas + openpyxl,由 WorkBuddy 自动管理,无需手工安装)
- 输入文件:门店销售 Excel 放在一个目录下(本案例为 119 个
.xlsx) - 不需要任何外部账号或 API Key
在 WorkBuddy 中的操作
- 摸底:让 WorkBuddy 先扫描目录,报告文件数量、格式差异和脏数据类型,先出方案再动手。
- 清洗合并:确认方案后,WorkBuddy 编写并运行清洗脚本,输出
cleaned_data/汇总表.xlsx(汇总表 / 门店统计 / 数据质量报告 三个 Sheet),同时保留可复现脚本。 - 生成 Excel 分析报告:基于汇总表生成 8 个 Sheet 的
门店运营分析报告.xlsx,占比、合计、客单价、环比全部用 Excel 活公式(源数据更新即重算),并用 recalc 校验 0 公式错误。 - 生成 HTML 看板:要求「可点击维度联动、咨询所交付物风格」,WorkBuddy 用 ECharts(下载到本地、离线可用)生成
门店运营分析看板.html。 - 升级为驾驶舱:追加一句指令,把筛选面板改成「点到哪关联到哪」的全局联动,趋势图支持拖拽选月区间(复用时可直接用下文优化版第三轮提示词,一步提清这些要求)。
每一步 WorkBuddy 都会汇报它发现了什么、做了什么假设,人只需要在关键节点确认口径。
提示词或任务指令
实际执行共三轮对话。第一轮提示词为当时原文;第二、三轮在原文基础上做了优化(见每轮后的说明),复用时可直接采用优化版。
第一轮(清洗合并,原文):
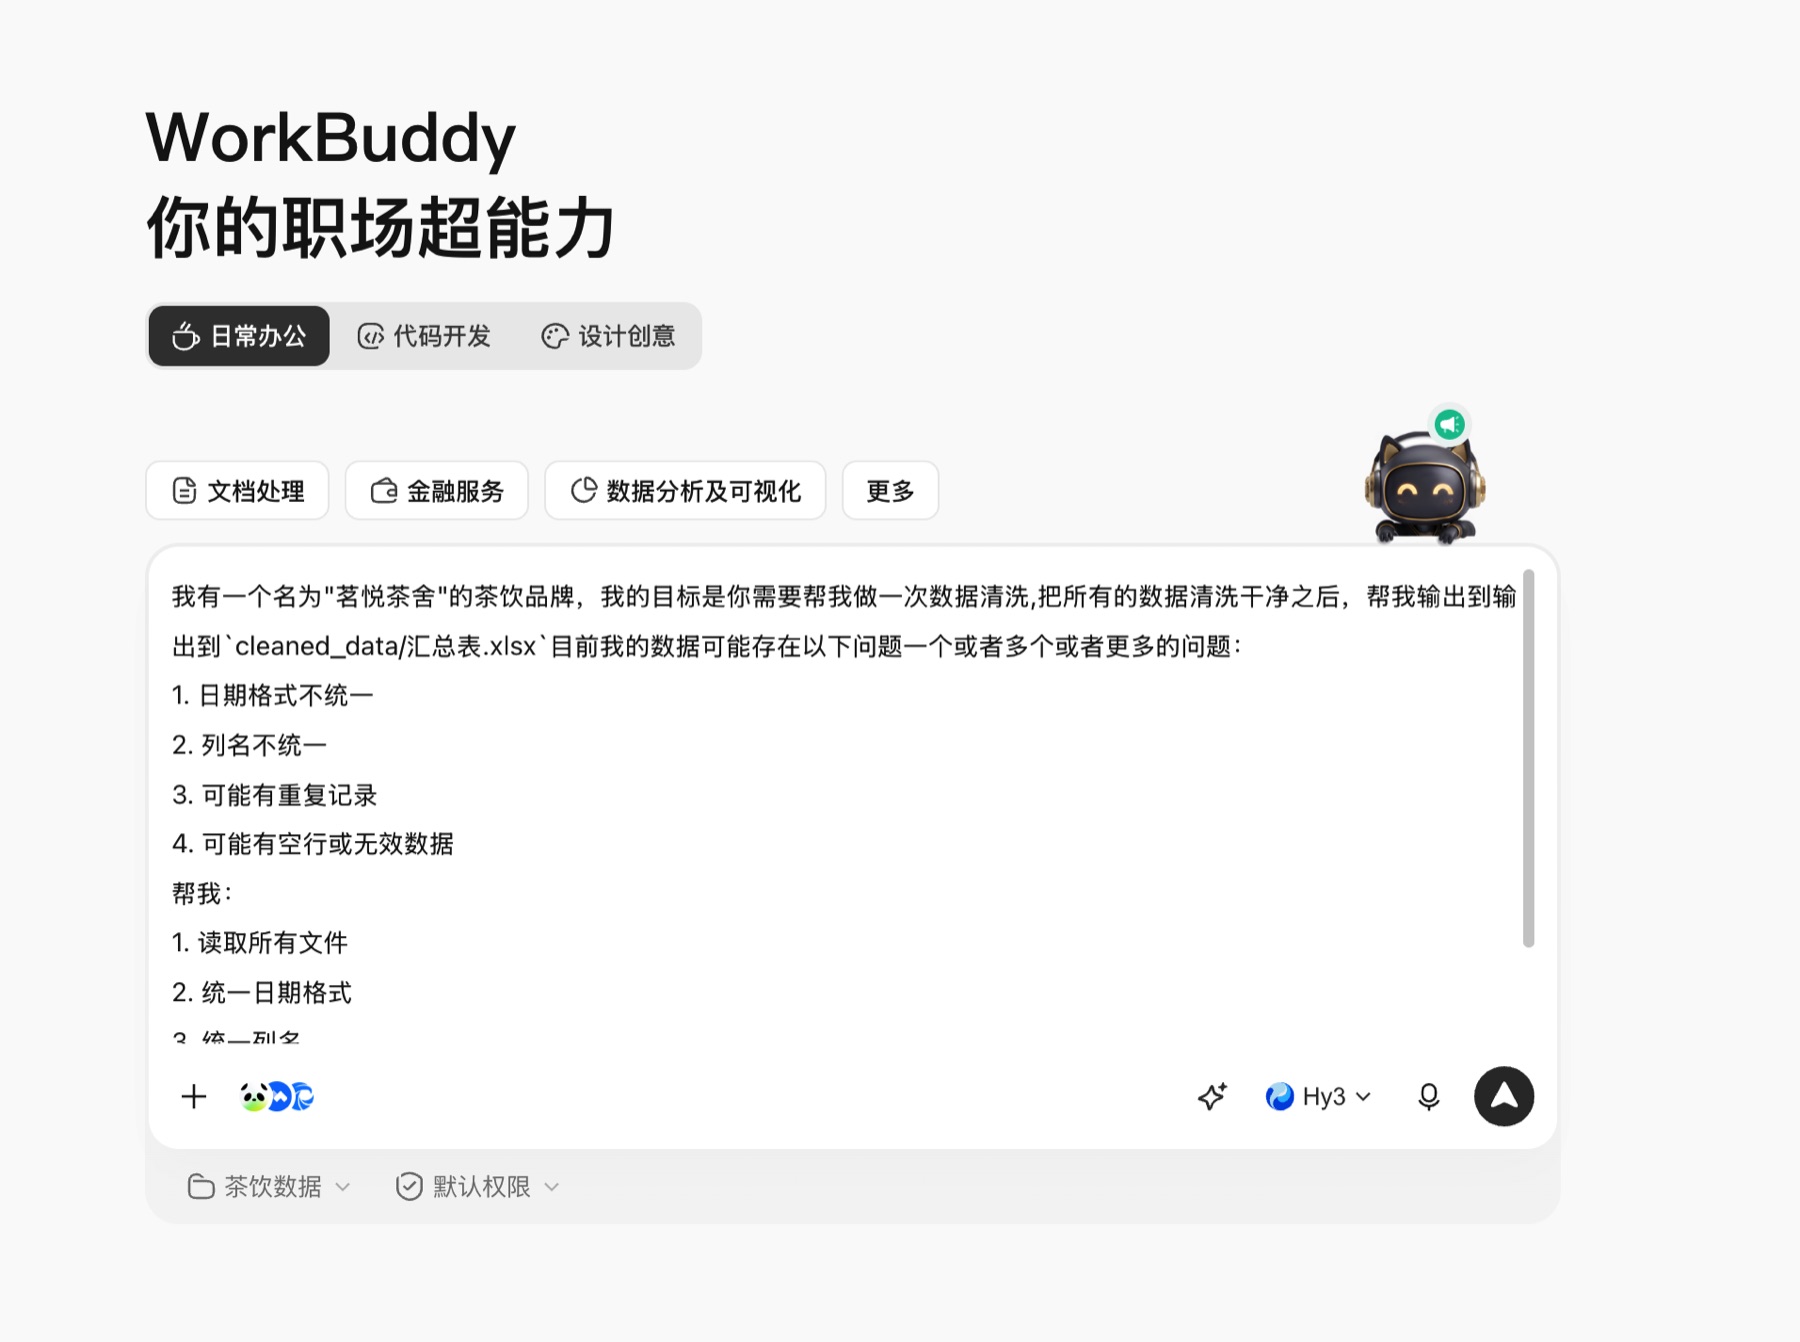
我有一个名为"茗悦茶舍"的茶饮品牌,我的目标是你需要帮我做一次数据清洗,把所有的数据清洗干净之后,帮我输出到`cleaned_data/汇总表.xlsx`目前我的数据可能存在以下问题一个或者多个或者更多的问题:
1. 日期格式不统一
2. 列名不统一
3. 可能有重复记录
4. 可能有空行或无效数据
帮我:
1. 读取所有文件
2. 统一日期格式
3. 统一列名
4. 去除重复记录和无效数据
5. 合并成一张干净的汇总表
第二轮(生成分析报告,优化版):
基于刚才清洗好的汇总表,生成一份用于门店运营分析和推广策略的Excel报告,
保存为 analysis/门店运营分析报告.xlsx,每个分析一张Sheet,至少包括:

1. 按区域汇总:七大地理分区销售额排名与占比(含柱状图)
2. 按城市汇总:城市销售额排名(含条形图)
3. 找出销售额TOP10的门店(含客单价与占比,含条形图)
4. 分析各品类的销售占比(含饼图)
5. 生成月度趋势分析:全年12个月销售额与客流量(双轴折线图)+ 环比

要求:所有占比、合计、客单价、环比用Excel活公式实现,源数据更新能自动重算;
最后加一张「洞察与建议」Sheet,基于数据给出可操作的运营和推广建议。优化点:明确了输出文件和格式(Excel、每项分析一张 Sheet、配图)、补上了活公式要求(源数据更新后报告自动重算),并把「做策略」的意图落成一张具体的「洞察与建议」Sheet——原指令只说"做一个报告",交付形态全靠模型猜。
第三轮(交互看板,优化版):
基于汇总表,用合适的可交互库(如ECharts)生成一个HTML看板。它不只是静态报告,
我可以随便点击一些维度,页面内容随之更新。具体要求:

1. 点击任意图表的柱体/扇区,就把该维度设为当前筛选,所有KPI、图表、明细表实时联动重算
2. 月度趋势图支持拖拽选择月份区间
3. 被点击的维度图保持完整显示(仅高亮选中项),其余维度收窄,避免"点完只剩一根柱"
4. 顶部提供全局状态条,可逐维取消筛选、一键重置
5. 依赖库下载到本地,双击即可离线打开
6. 视觉风格请仔细设计,要专业,像德勤这样的咨询机构输出的交付物优化点:把"随便点一些维度"翻译成明确的交互规则(点击即筛选、全局联动、拖拽选月、保留上下文、可重置),并补上离线可用的硬性要求——避免生成的 HTML 依赖在线 CDN,断网或分享后打不开。"像德勤"的风格描述保留原文,模型能听懂,但交互行为必须写清楚。
在 WorkBuddy 中的效果
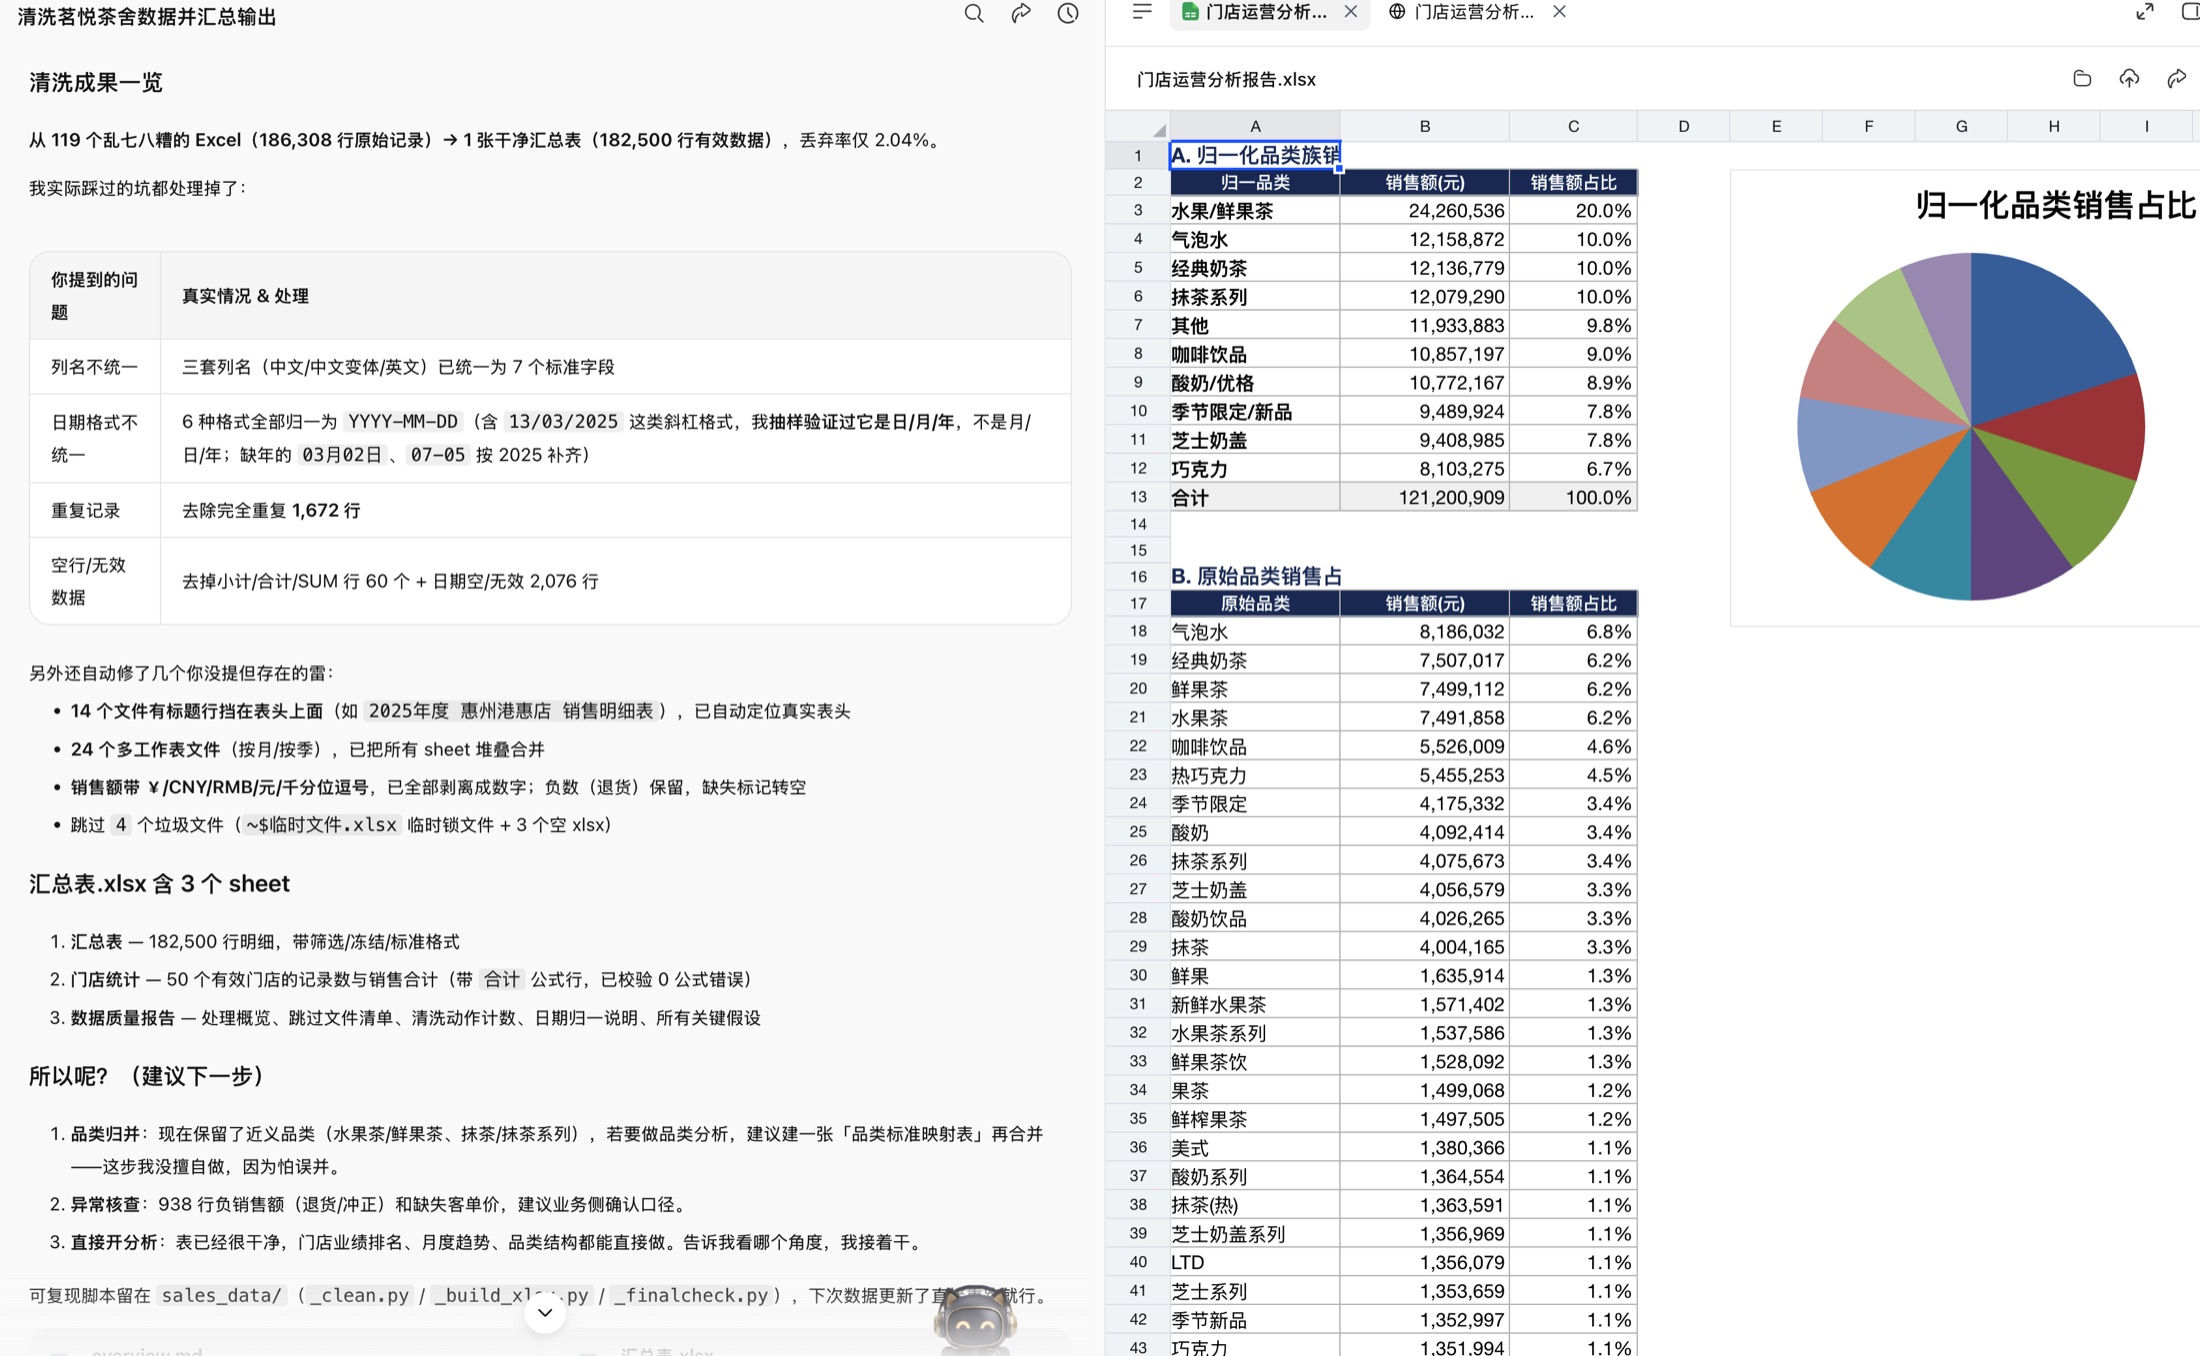
清洗结果:原始 186,308 行 → 有效 182,500 行(丢弃率 2.04%)。去除小计/合计行 60 条、无效日期 2,076 行、完全重复记录 1,672 行;53 个门店名被识别(50 个有有效数据),跨文件同名门店自动合并。所有口径假设写入了「数据质量报告」Sheet。
Excel 分析报告:8 个 Sheet(封面指标卡 / 区域汇总 / 城市汇总 / TOP10 门店 / 品类占比 / 月度趋势 / 洞察与策略建议 / 数据说明与假设),165 个活公式,recalc 校验 0 错误。核心发现:华南(28.8%)与华东(28.7%)双龙头合计过半;TOP10 门店占全盘 38.7%;水果/鲜果茶品类占 20.0%。
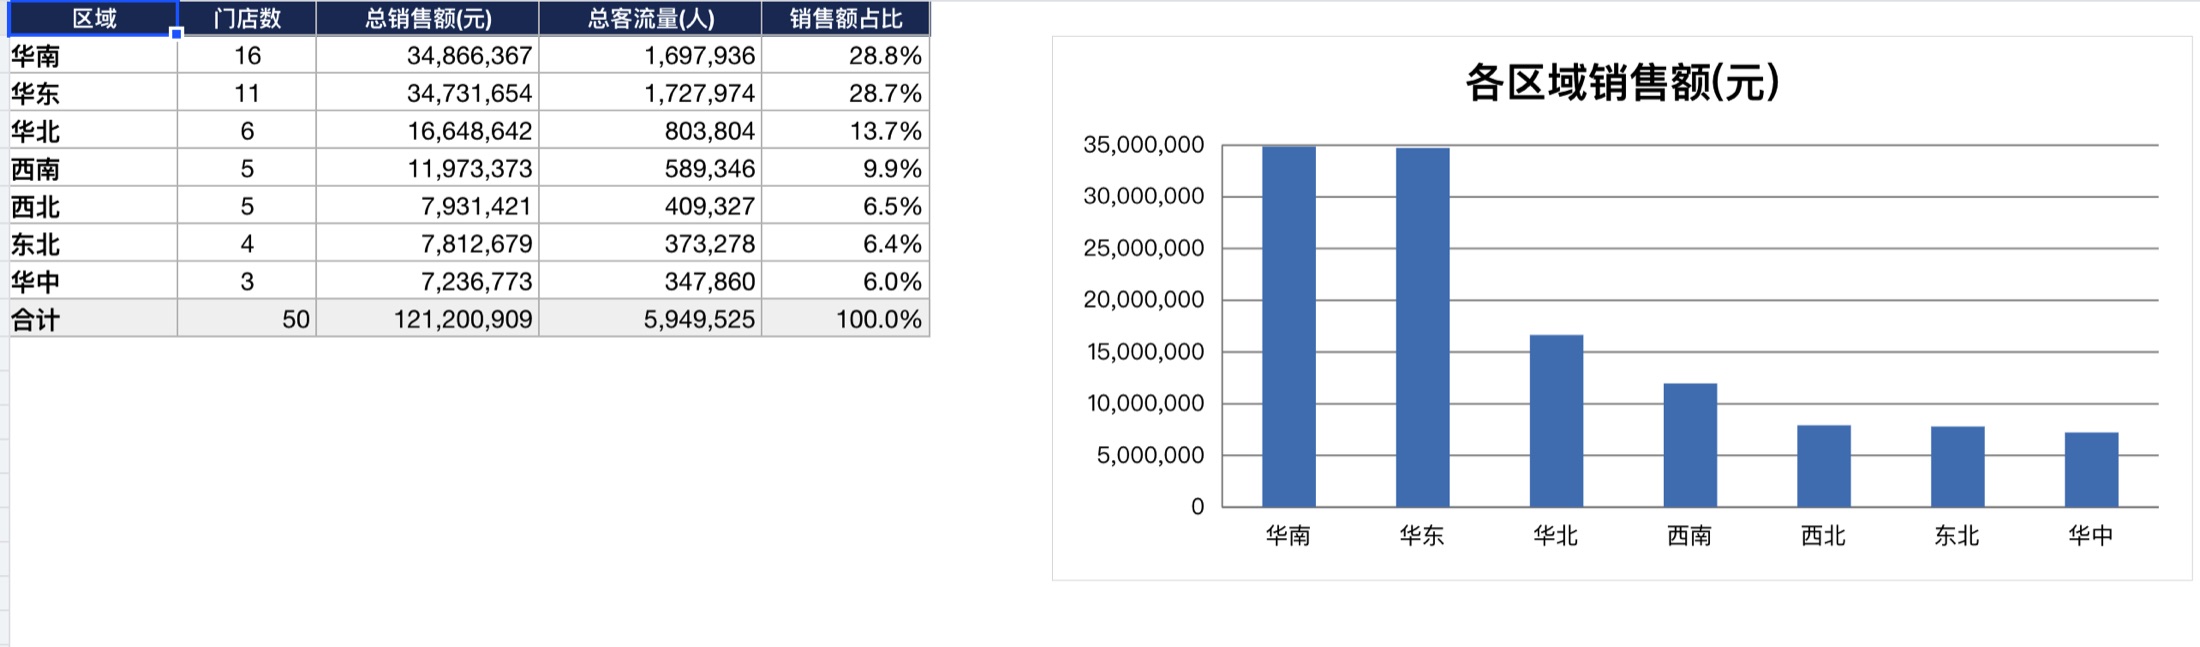
HTML 驾驶舱:深绿品牌色 + 金点缀的咨询所风格,KPI 卡、5 张图表、门店明细表全部全局联动;趋势图支持拖拽选月。聚合数值经 node 脚本多场景模拟校验,与 Excel 报告完全一致。
执行过程:WorkBuddy 接到任务指令后开始执行(左图);清洗完成后,它会先汇报发现了哪些脏数据问题、做了哪些处理假设,由人确认口径后再继续(右图)。
验收标准
- 清洗后汇总表的行数、门店数与源文件能对上(有效 182,500 行 / 50 门店,丢弃明细可追溯)
- 「数据质量报告」Sheet 明确列出每项处理假设(缺年日期默认 2025、负销售按净额计入等)
- Excel 报告用 recalc 重算校验:0 公式错误
- HTML 看板的聚合数字(总额、区域、TOP 店、品类、月度)与 Excel 报告逐一吻合
- 看板文件双击离线可打开,联动逻辑经多场景模拟验证(单区域 / 区域+城市 / 品类 / 单月)
遇到的问题
- 日期格式歧义:
03/03/2025这类格式无法直接判断是日/月/年还是月/日/年。WorkBuddy 通过抽样验证(同一文件内出现15/03/2025这类日期)确认为 day-first 后才批量解析。 - 缺年份的日期:
03月02日这类记录缺少年份,WorkBuddy 没有自行猜测,而是提出假设(所有源文件均为 2025 年度,默认补 2025)并写入数据质量报告,由人确认。 - 品类近义词:「水果茶」和「鲜果茶」是否算同一类?清洗阶段只去空格、不主观合并;归一规则放在分析阶段,原始 53 个品类明细完整保留在报告中供核对。
- 看板交互陷阱:初版交叉筛选会出现「点完只剩一根柱」的问题——被点维度自身也被收窄。改造为被点维度图忽略自身筛选、始终完整显示并高亮选中项。
安全与限制
- 本案例使用的是教学模拟数据(品牌与门店均为虚构),可公开;真实业务数据请勿在公开案例中原样贴出,截图需脱敏。
- 整个流程只读写本地目录,不访问外部网络、不需要账号授权。
- WorkBuddy 会在数据目录下生成中间产物(清洗脚本、中间 CSV、质量 JSON),提交或归档前注意区分交付物和过程文件。
- 清洗脚本会跳过 Excel 临时锁文件(
~$开头)和空文件,执行前建议关闭正在编辑的 Excel。
可以怎样复用
- 任何多 Excel 合并场景:连锁零售、经销商月报、分公司报销、问卷分卷回收——只要「多人各填各的表、格式对不上」,提示词框架照搬即可。
- 先摸底再动手:第一步要求 WorkBuddy 先扫描汇报问题再执行,这个习惯对一切数据任务都适用,能避免口径被默默猜错。
- 活公式交付:要求分析报告用活公式而非写死数值,后续月份数据追加后报告自动更新。
- 静态报告 → 交互看板:先拿 Excel 报告确认数字口径,再追加一句指令生成 HTML 看板,是低成本升级汇报体验的路径。
分类:职场效率难度:入门作者:KevinYoung-Kw日期:2026-07-13Skill:Vibe Resume Skill
把经历发给 WorkBuddy,直接生成一份好看的简历
这个案例解决什么问题
去年秋招时,我用 PPT 一点点排过一份简历。做出来很好看,修改起来却很麻烦。多加一段经历,后面的内容就要跟着移动;文字多了一行,字号、间距和分页也要重新调整。
后来我把这套简历做成 HTML,又整理成了 Vibe Resume Skill。把它安装到 WorkBuddy 以后,写简历就变成了一件很直接的事:发出自己的经历和照片,告诉 AI 想投什么岗位,它会生成完整简历。以后有新经历,继续发给它修改就行。
下面是我在 WorkBuddy 中完整跑过的一次过程。
开始前准备什么
我准备了三样内容:
- 一段个人经历,包括教育、实习和项目。
- 一张准备放进简历的照片。
- 想投递的岗位,例如“AI 产品经理实习”。
为了公开展示,这个案例使用的是虚构候选人和虚构经历。
第一步:安装 Vibe Resume Skill
在 WorkBuddy 中新建任务,把下面这句话发出去:
帮我安装这个简历 Skill:
https://github.com/KevinYoung-Kw/vibe-resume-skill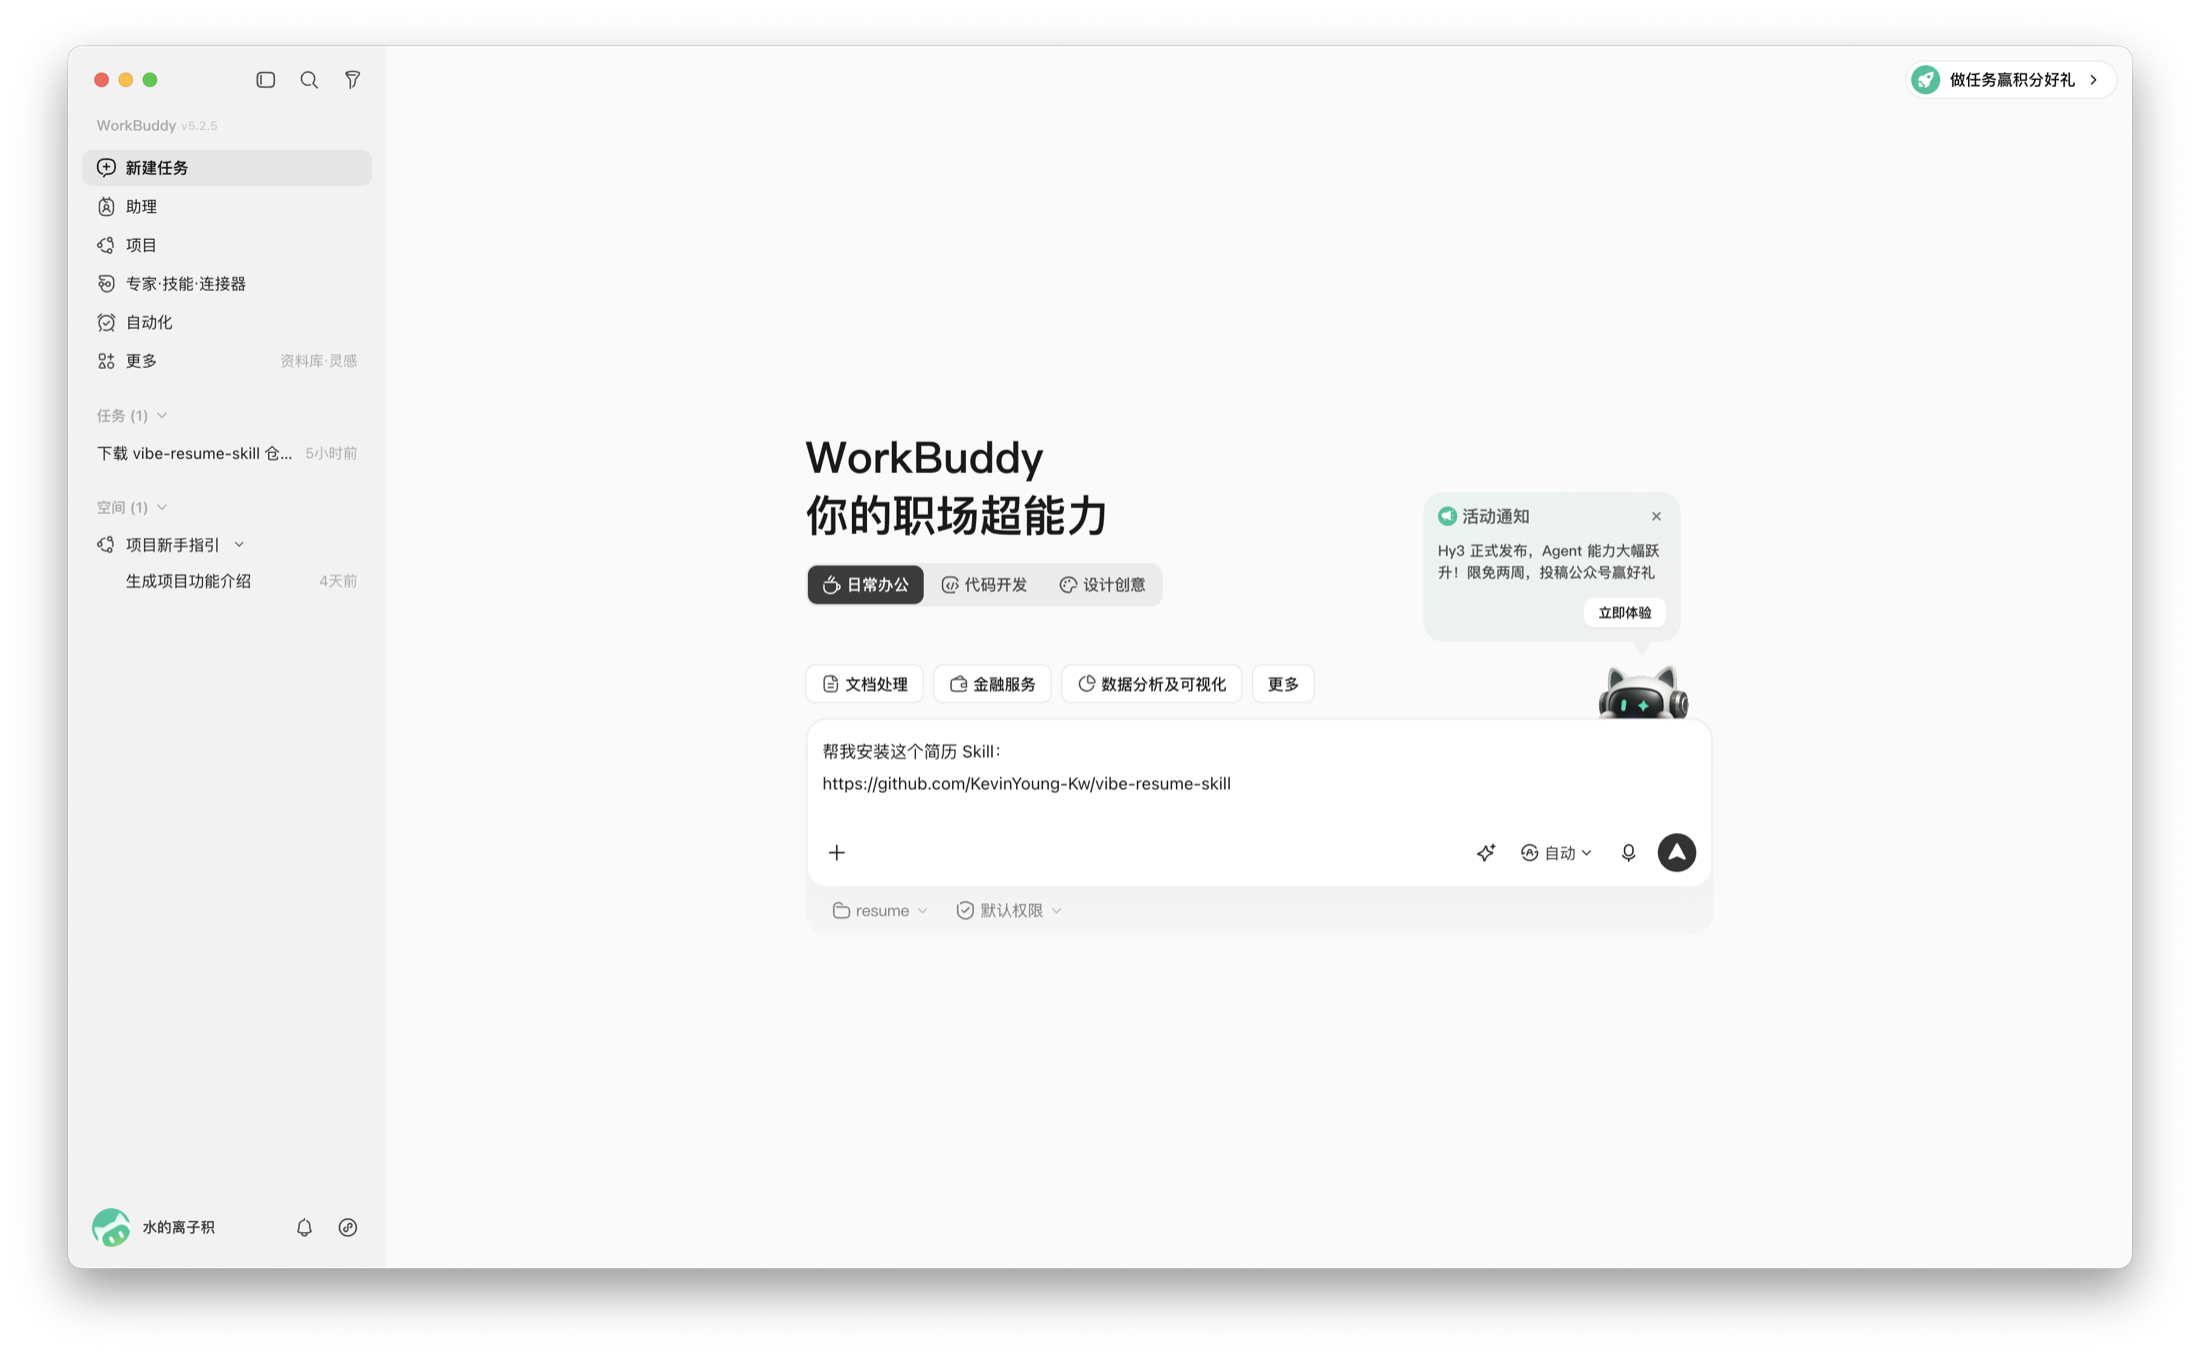
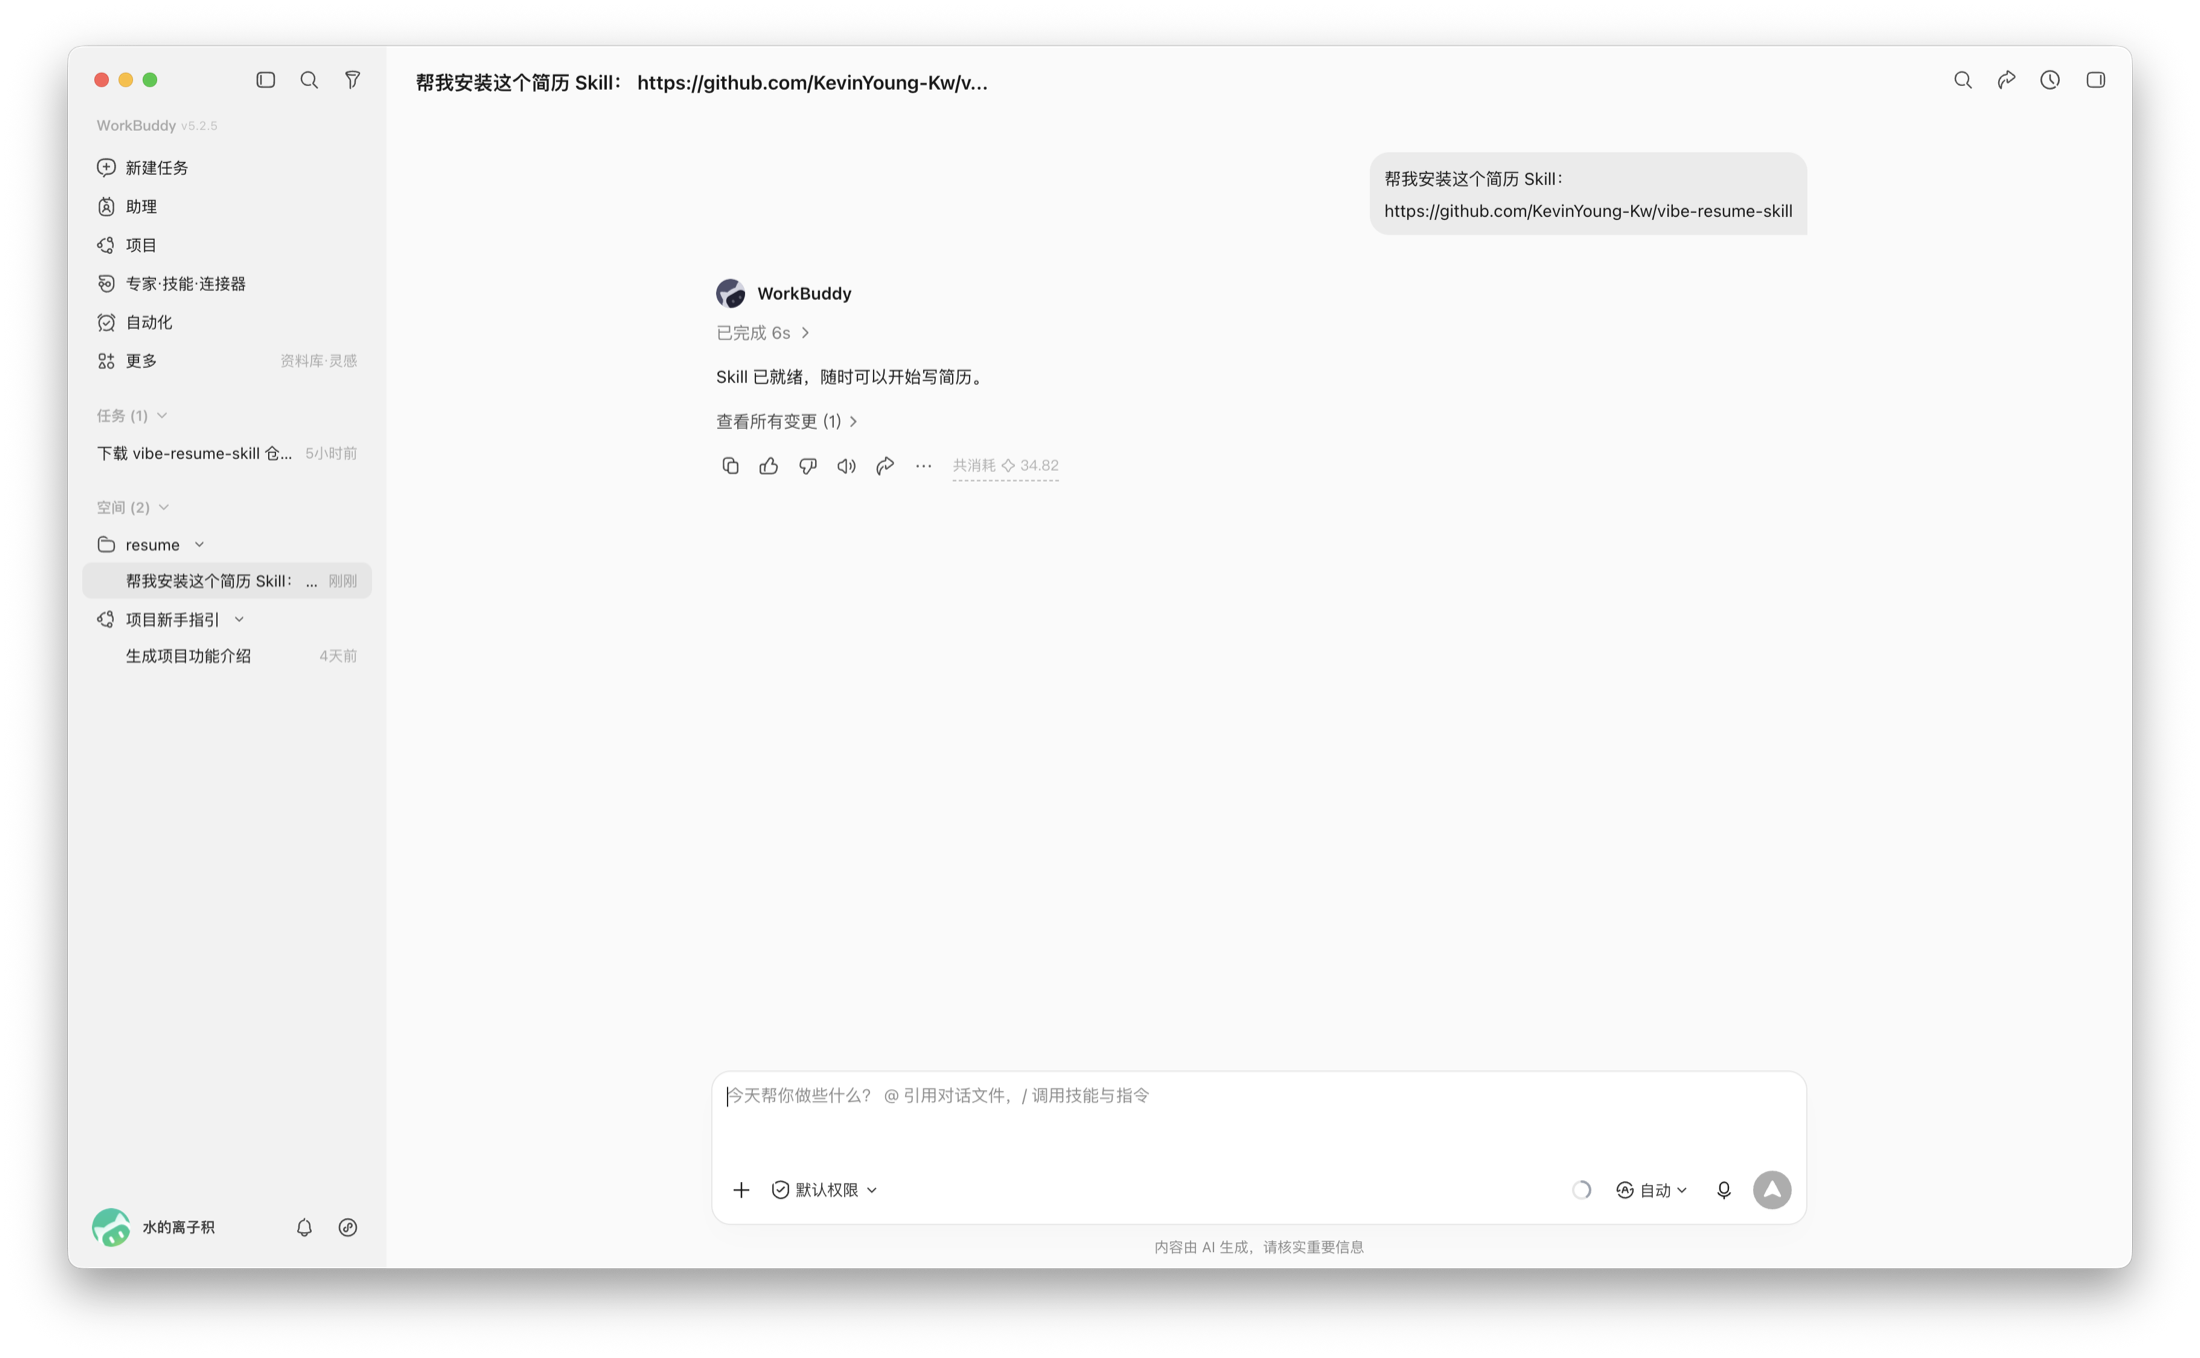
安装完成后,WorkBuddy 会提示 Skill 已经可以使用。
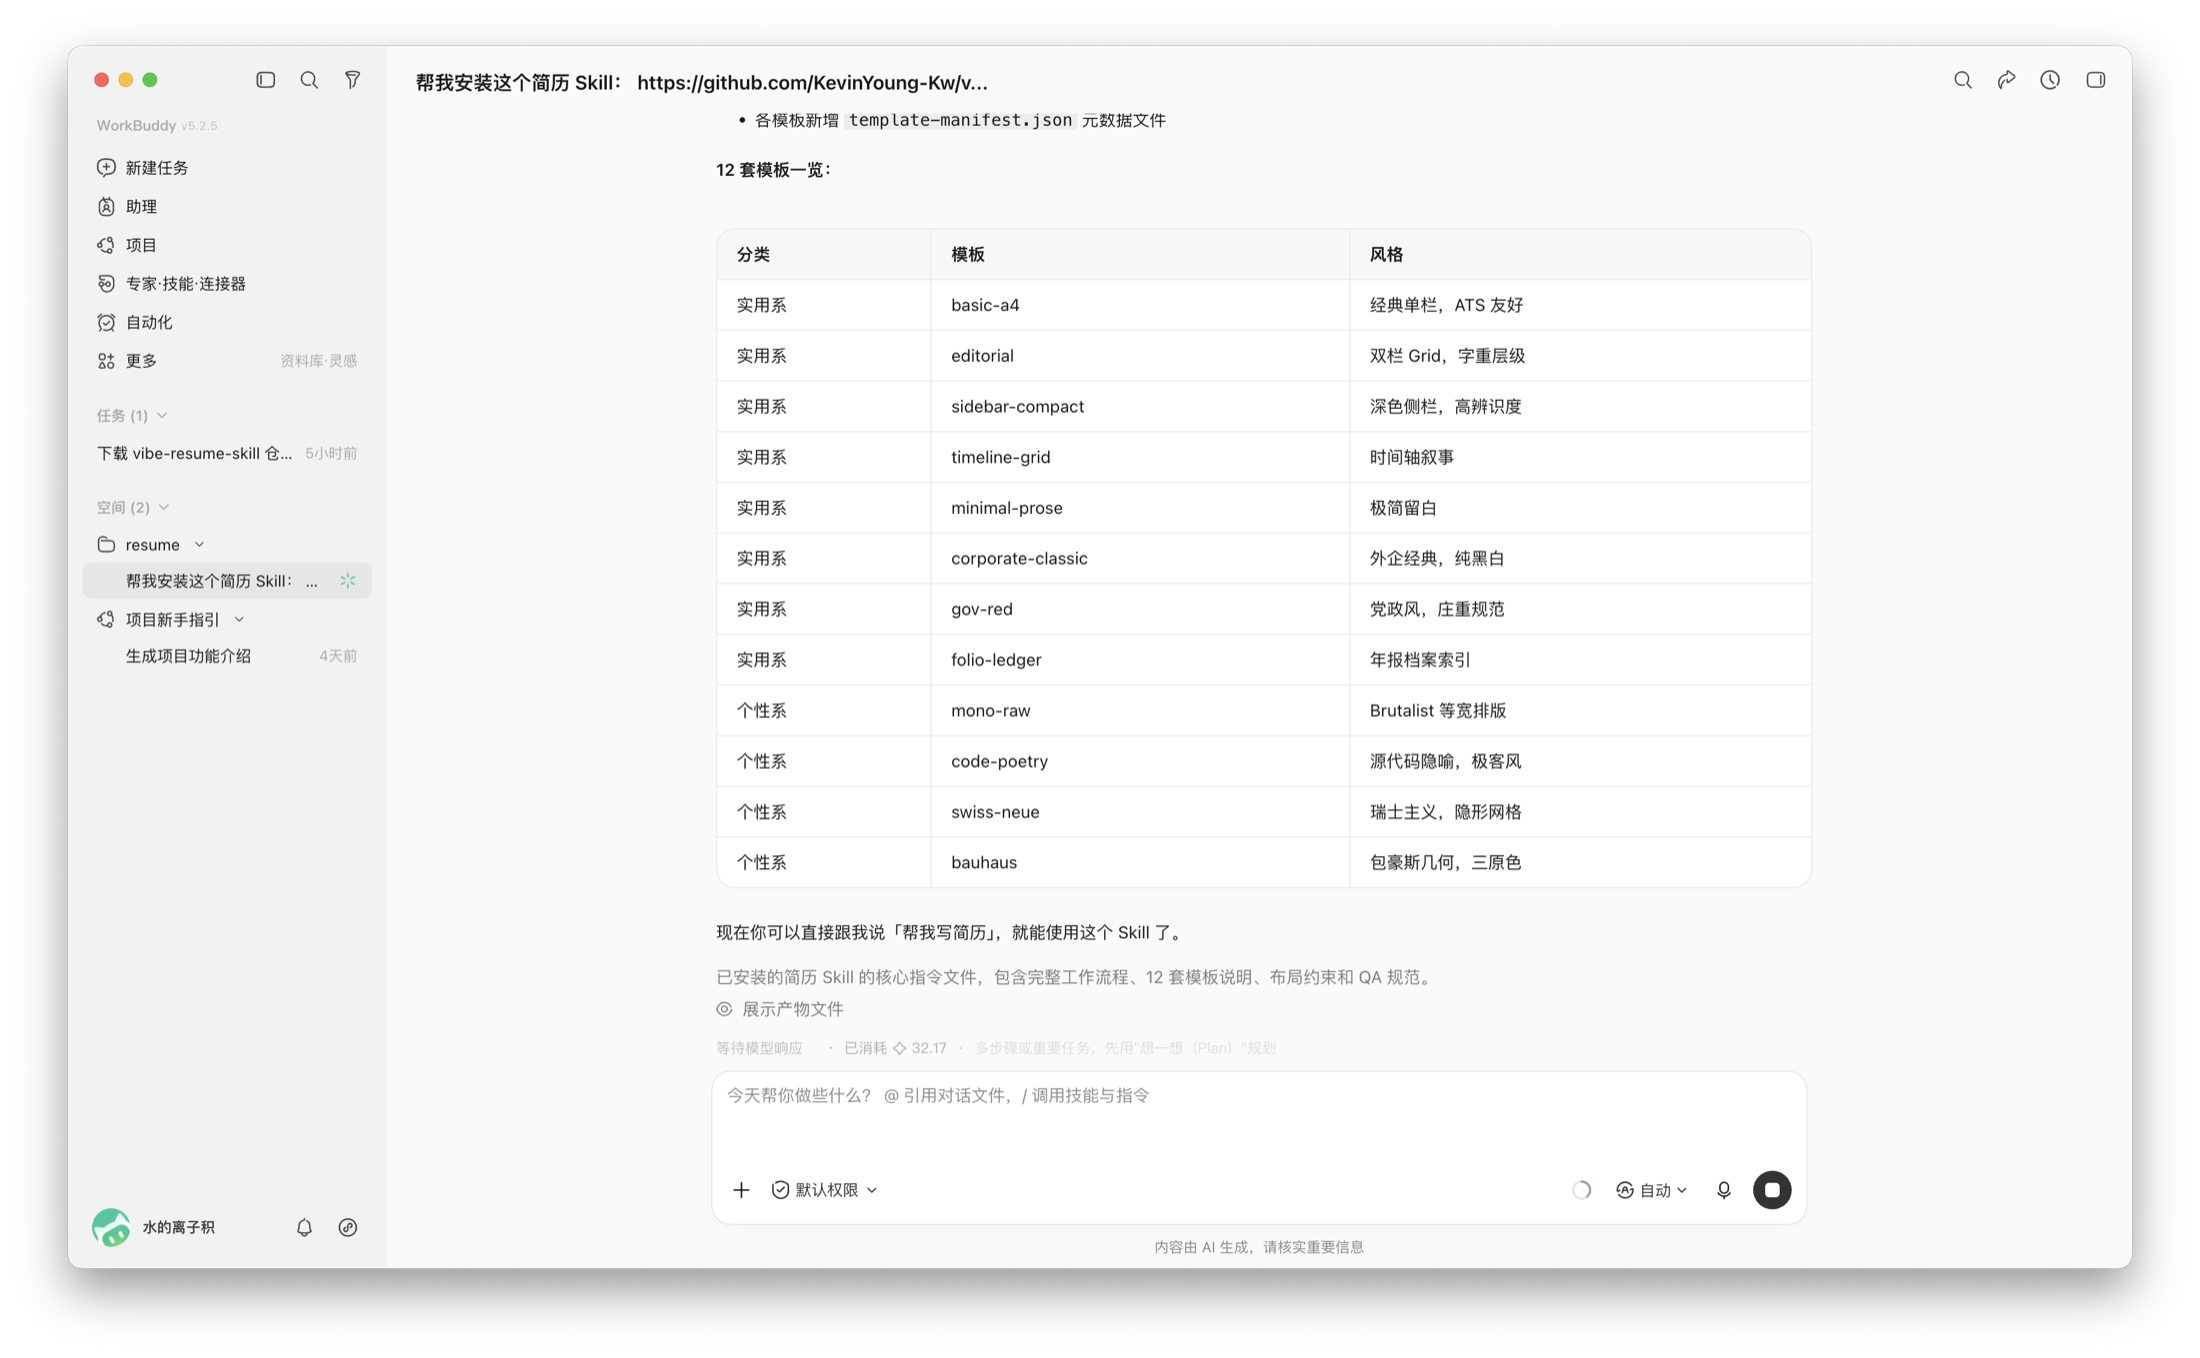
Skill 里有 12 套简历模板。可以让 WorkBuddy 把模板列出来,挑一套自己喜欢的;如果不想选,直接使用默认模板也可以。
第二步:发送经历和照片
我把个人经历粘贴进对话,附上照片,然后发送:
这是我的个人经历,我想投 AI 产品经理实习。

请使用 vibe-resume-skill 帮我生成一份简历。
不要编造没有的数据,尽量控制在一页。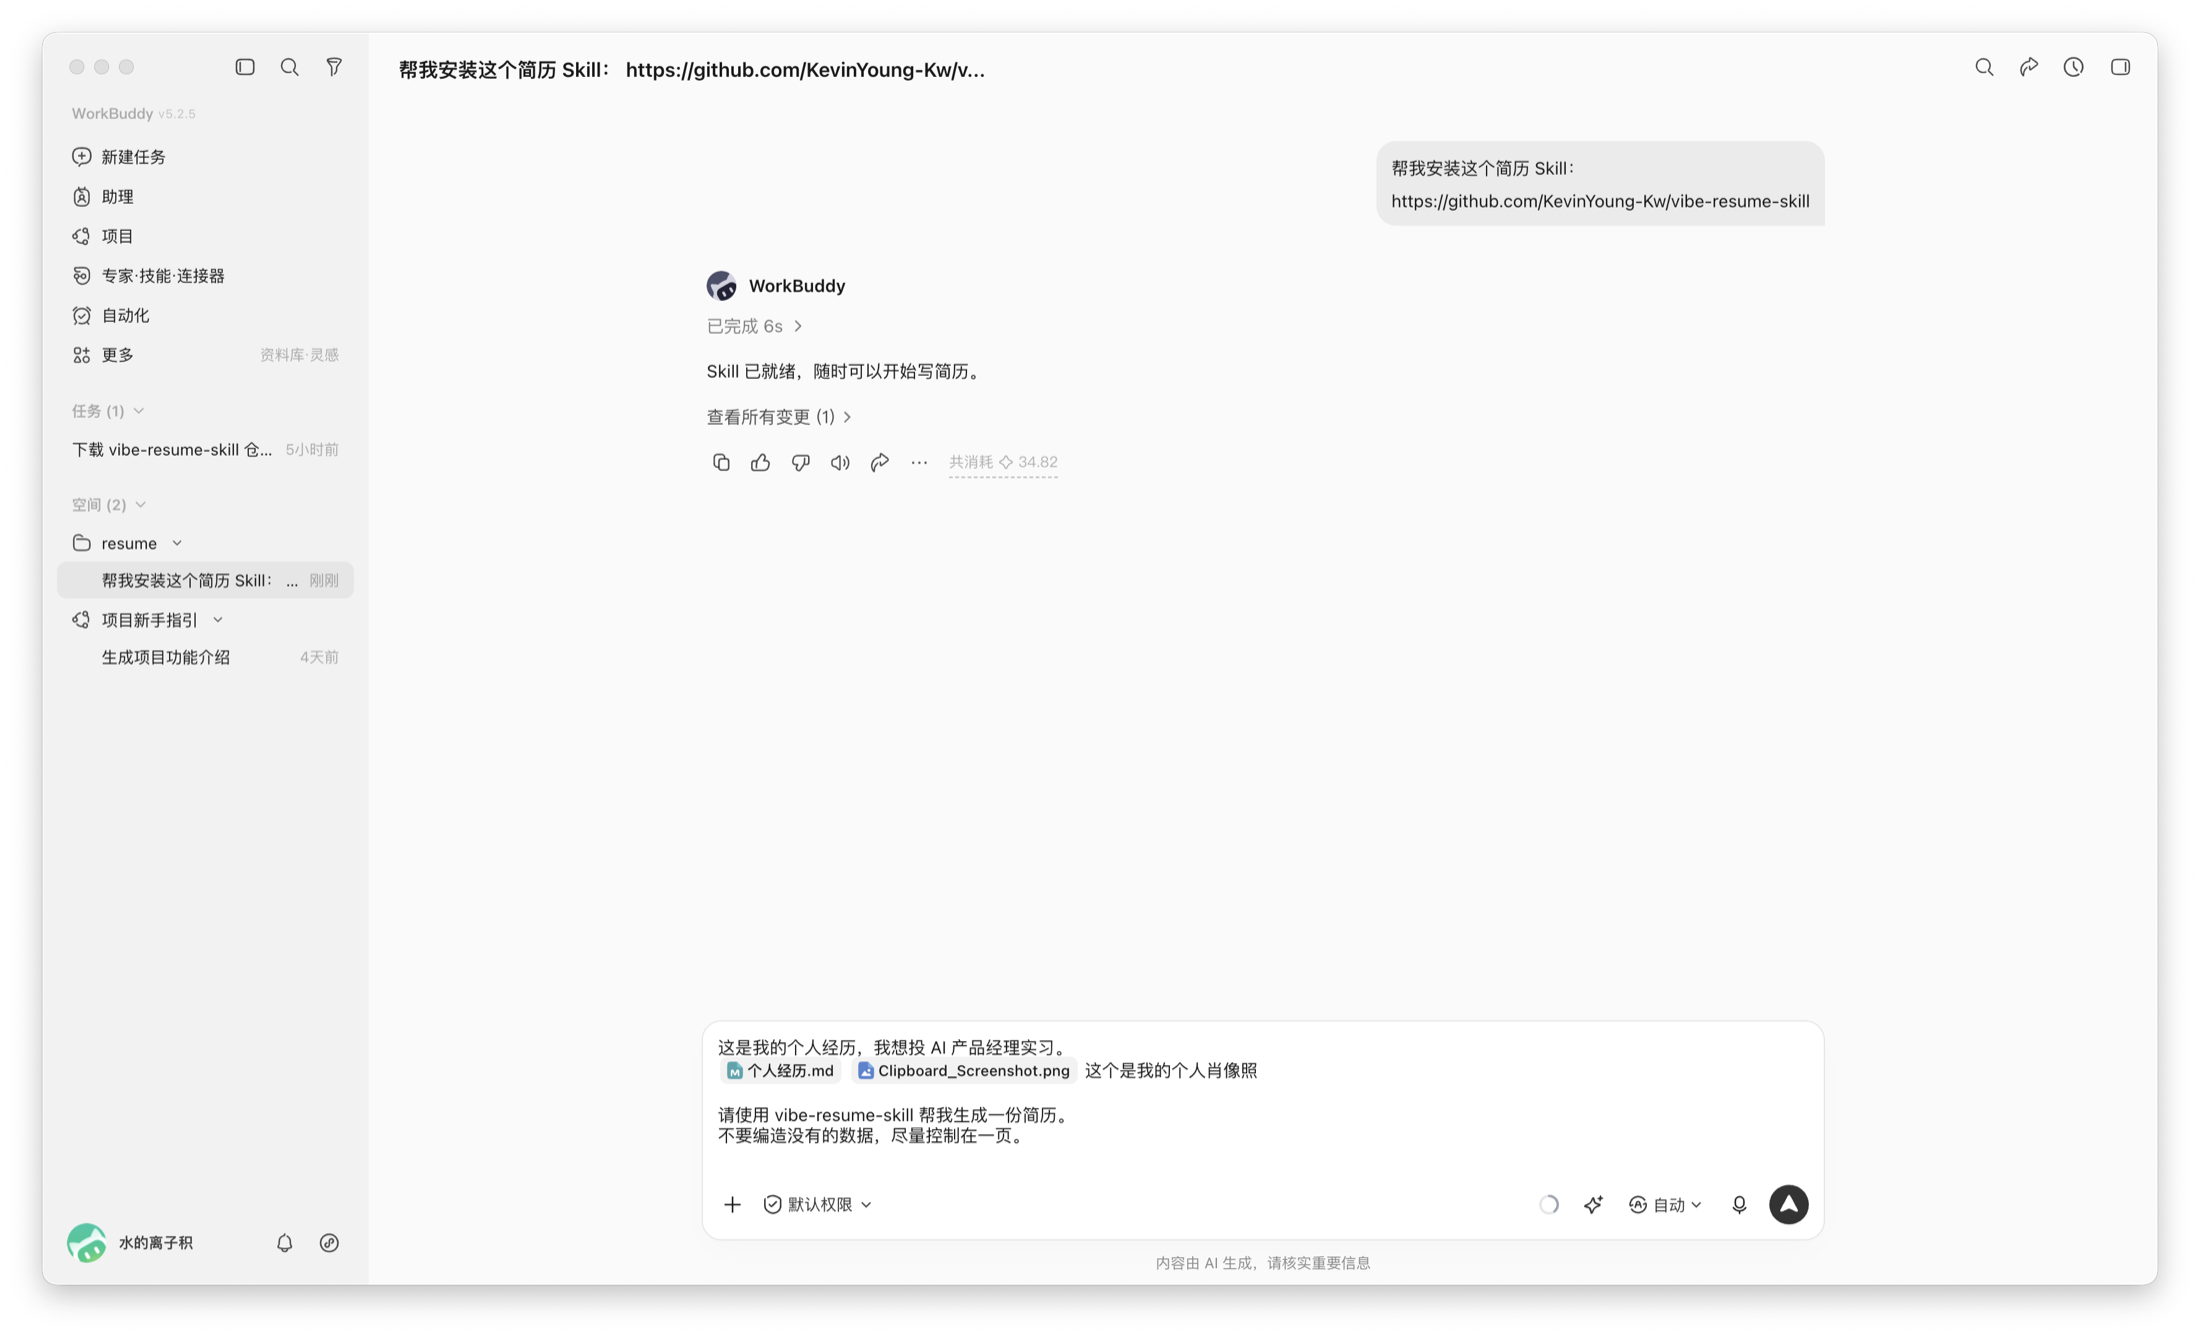
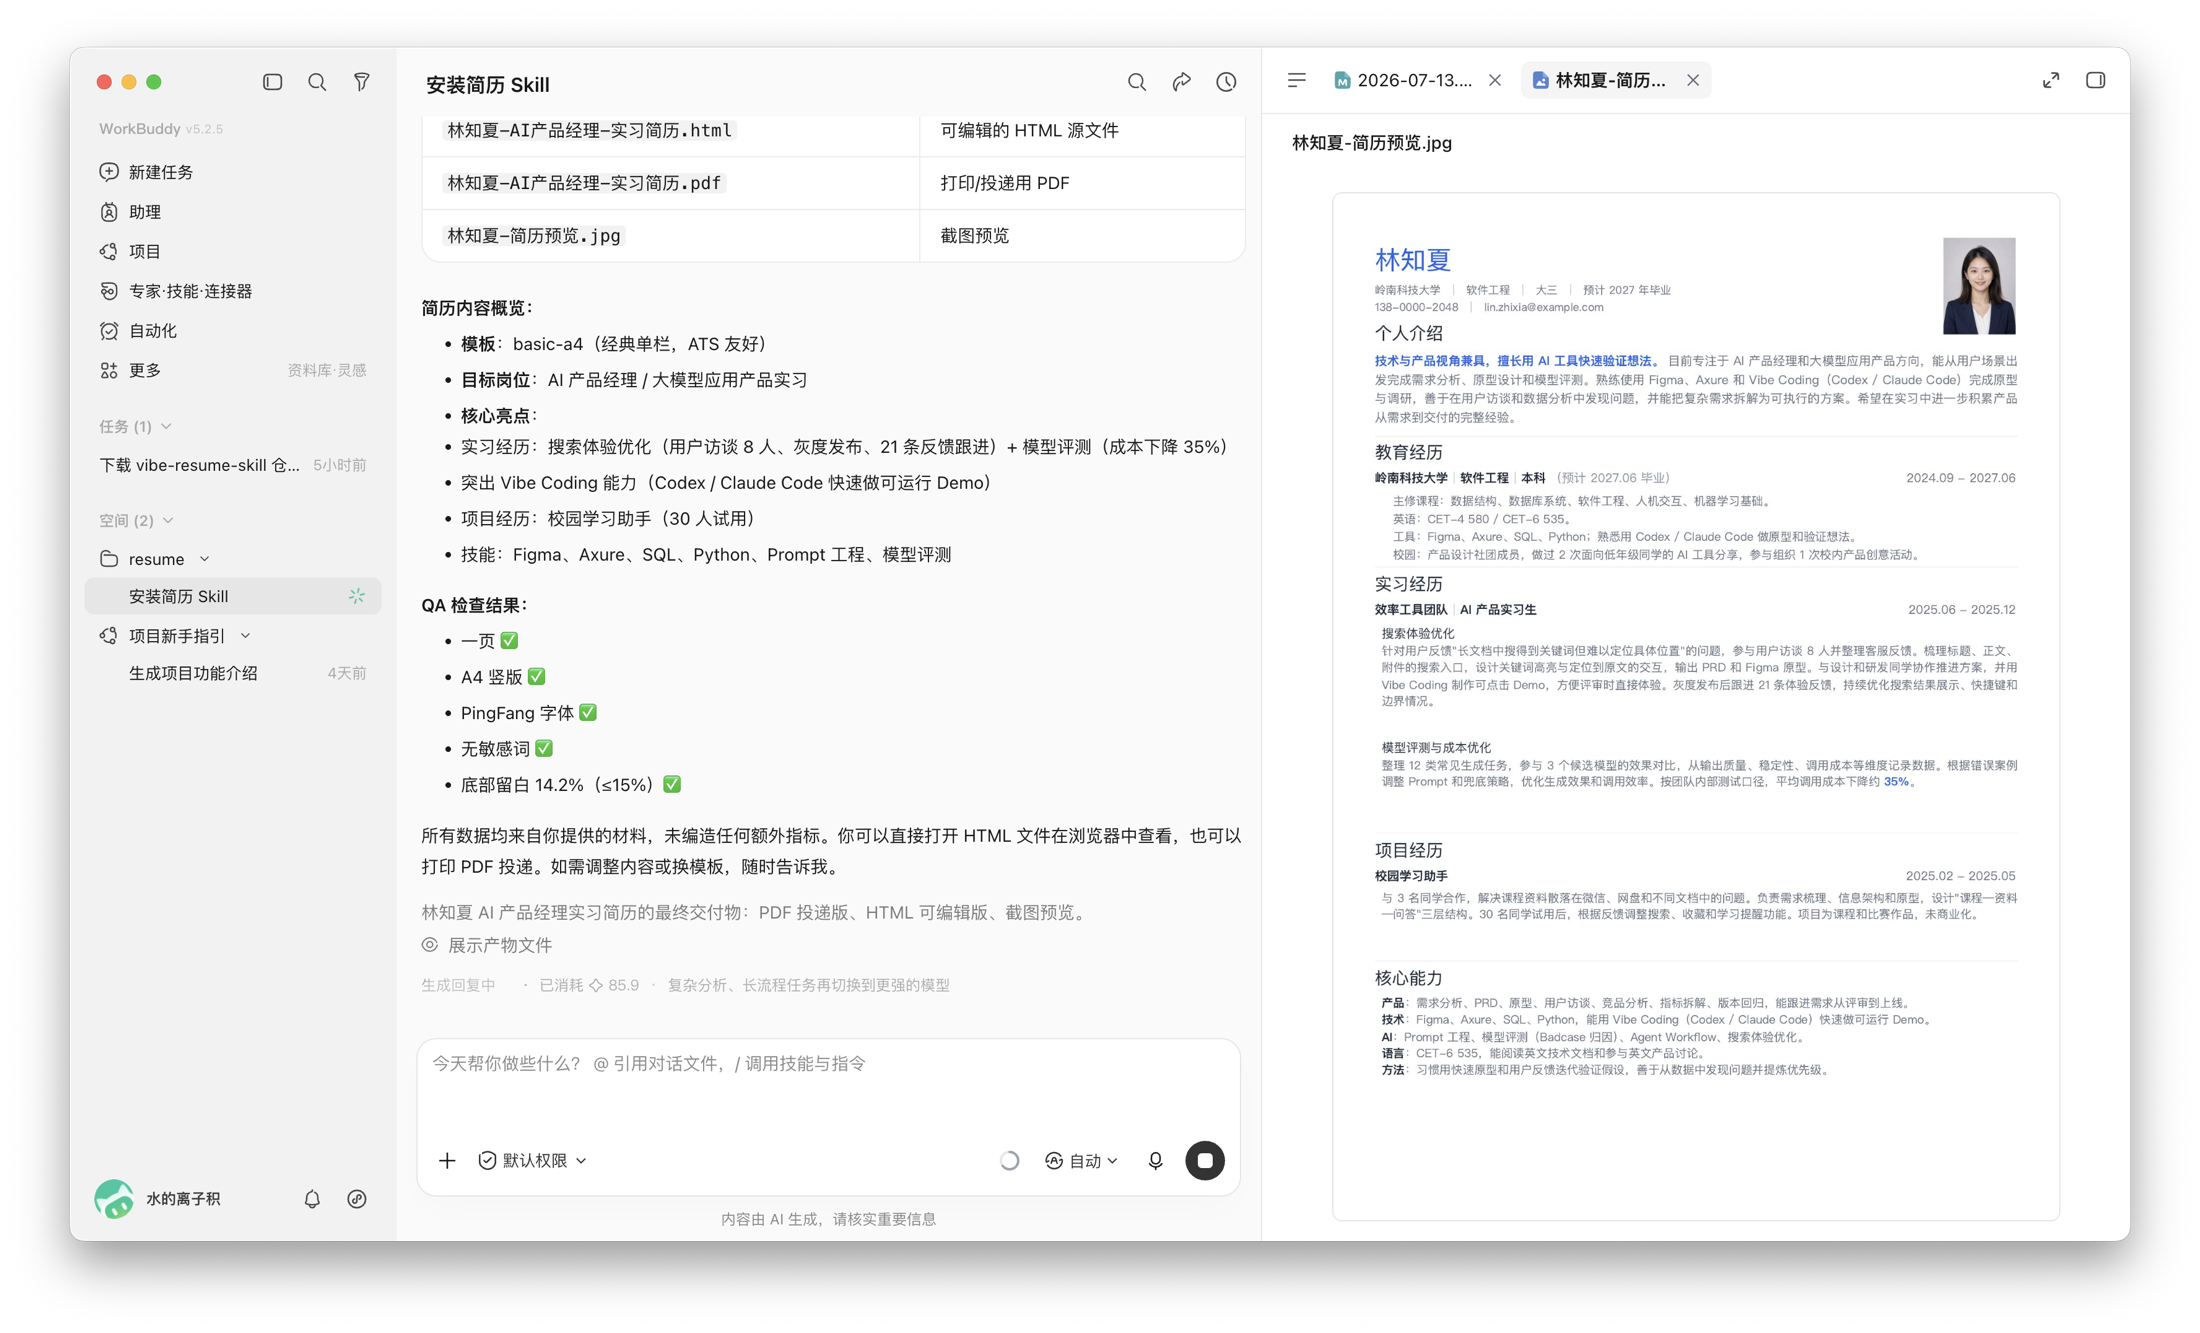
WorkBuddy 读完材料后,开始整理内容和排版。第一版生成完成时,右侧可以直接预览整份简历,同时还会得到 HTML、PDF 和预览图。
第三步:继续修改
第一版的内容已经完整,不过段落之间有些松。我直接告诉 WorkBuddy:
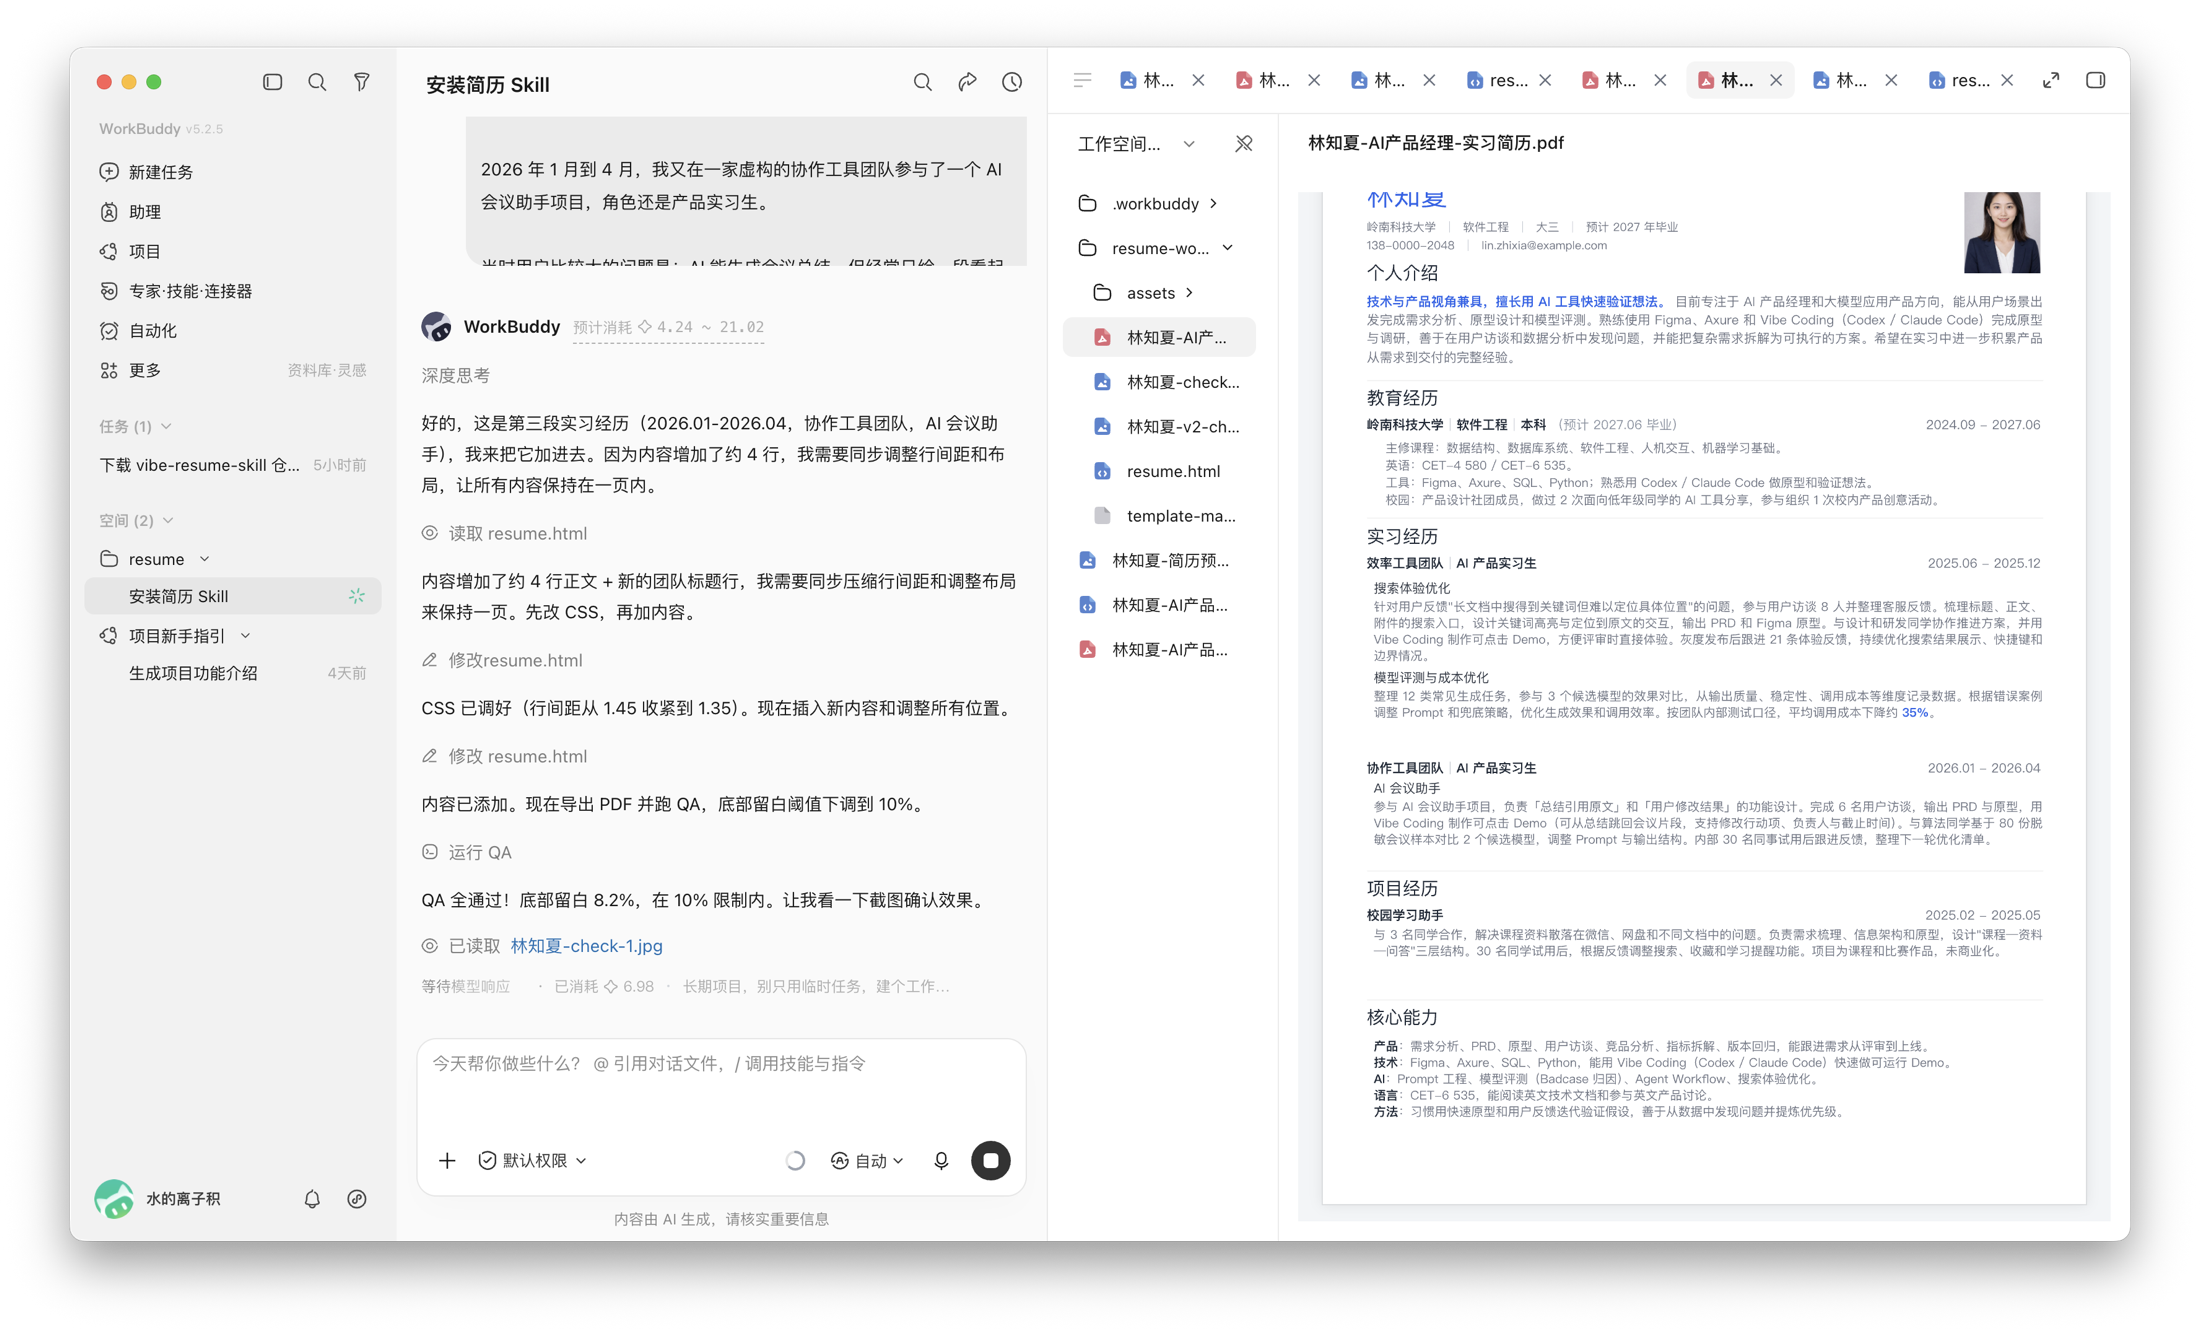
段落与段落之间有些稀疏,帮我适当收紧一点,不要删内容。后来又多了一段实习经历,我继续把内容贴进同一个对话:
这是我最近新增的一段经历,帮我加到已有简历里。
不要删掉原来的内容,仍然尽量保持一页。
WorkBuddy 在原来的简历上加入新经历,并重新调整了整页间距。修改前后的内容都保留在同一个任务里,不需要重新制作一份简历。
最后得到什么
这次一共生成了三份文件:
- HTML:可以继续编辑,之后增加经历时还能接着修改。
- PDF:保持一页,可以直接用于投递。
- 预览图:方便快速查看整页效果。
最终版本加入了新的实习经历,页面依然保持一页,文字和照片都能完整显示。经历、日期和数据也与提供的材料一致。
还可以怎么用
如果还没有简历,可以直接把零散经历发给 WorkBuddy,让它整理并生成第一版。
如果已经有 Word、PDF 或 HTML 简历,可以把旧简历和新增经历一起发过去,让它在原版上修改。
如果准备投递不同岗位,可以再附上岗位 JD,让 WorkBuddy 分别调整经历顺序和内容重点。
使用时注意
AI 生成完成后,记得核对姓名、联系方式、经历时间和数据。涉及公司内部信息的内容,发送前先做脱敏处理。
了解更多
- Skill 地址:KevinYoung-Kw/vibe-resume-skill
- 文章:《别花几千改简历了,我开源了个 Skill 给你》
分类:内容创作难度:入门作者:nikola日期:2026-07-13Skill:wechat-publisher
用 WorkBuddy 公众号 Skill 一键排版并发布到微信公众号草稿箱
场景描述
写公众号文章,最耗时的往往不是内容本身,而是排版。在微信后台编辑器里调整字号、行距、缩进、图片位置,经常要反复预览和修改。整篇文章从写完后到真正能发布,排版时间可能和写作时间一样长。用 WorkBuddy 把这件事变成两步:用 Markdown 写好内容,剩下的排版和发布交给 Skill 自动完成。
我自己平时写公众号最大的问题就是排版,真的对排版深恶痛绝,尤其是图片外链的处理。之前我的公众号排版流程是这样的:markdown写好内容->第三方编辑器美化->粘贴到微信公众号草稿中(最大的问题就在这,我的文章中会放很多图片,但是从编辑器中粘贴过来的图片经常挂掉,因为公众号不支持第三方图床)->逐一粘贴图片->预览、修改->发布。
而现在有了Wechat Publisher可以一键排版,自动上传图片到公众号草稿箱,真的是节省了我半个多小时的时间。
想要完成的任务
完成后,WorkBuddy 应当能够:
- 读取一篇 Markdown 格式的文章(标题、正文、图片、代码块)。
- 自动将 Markdown 转换为微信公众号兼容的排版格式,包括代码高亮、主题样式和 Mac 风格代码块。
- 自动将文章中的本地图片和网络图片上传至微信图床。
- 一键将排版后的文章推送到公众号草稿箱。
- 在公众号后台预览或微调后即可群发。
使用的 Skill
| Skill | 用途 | 来源或安装方式 |
|---|---|---|
| wechat-publisher | Markdown 转公众号排版,一键上传图片并推送到草稿箱 | WorkBuddy 内置推荐市场,直接安装 |
wechat-publisher 基于开源项目 wenyan-cli,内置多套排版主题和代码高亮方案,支持自动图片上传和草稿箱推送。
前置条件
- WorkBuddy 可以正常使用。
- 已经拥有微信公众号(订阅号或服务号),并具备开发者权限。
- 已获取微信公众号的 AppID 和 AppSecret(在公众号后台「设置 → 开发 → 基本配置」中查看)。
- 本机公网 IP 已添加到公众号后台的 IP 白名单中(最好用WiFi而非手机热点,因为热点IP每次都会变,那么每次就要重复添加白名单IP)。
- 有一篇用 Markdown 写好的文章(含标题和封面图)。
在 WorkBuddy 中的操作
第一步:安装 wechat-publisher Skill
在 WorkBuddy 中新建任务,输入:
帮我安装公众号排版 Skill:wechat-publisher
**或者直接去技能搜索框搜索:wechat-publisher** 这个简单直接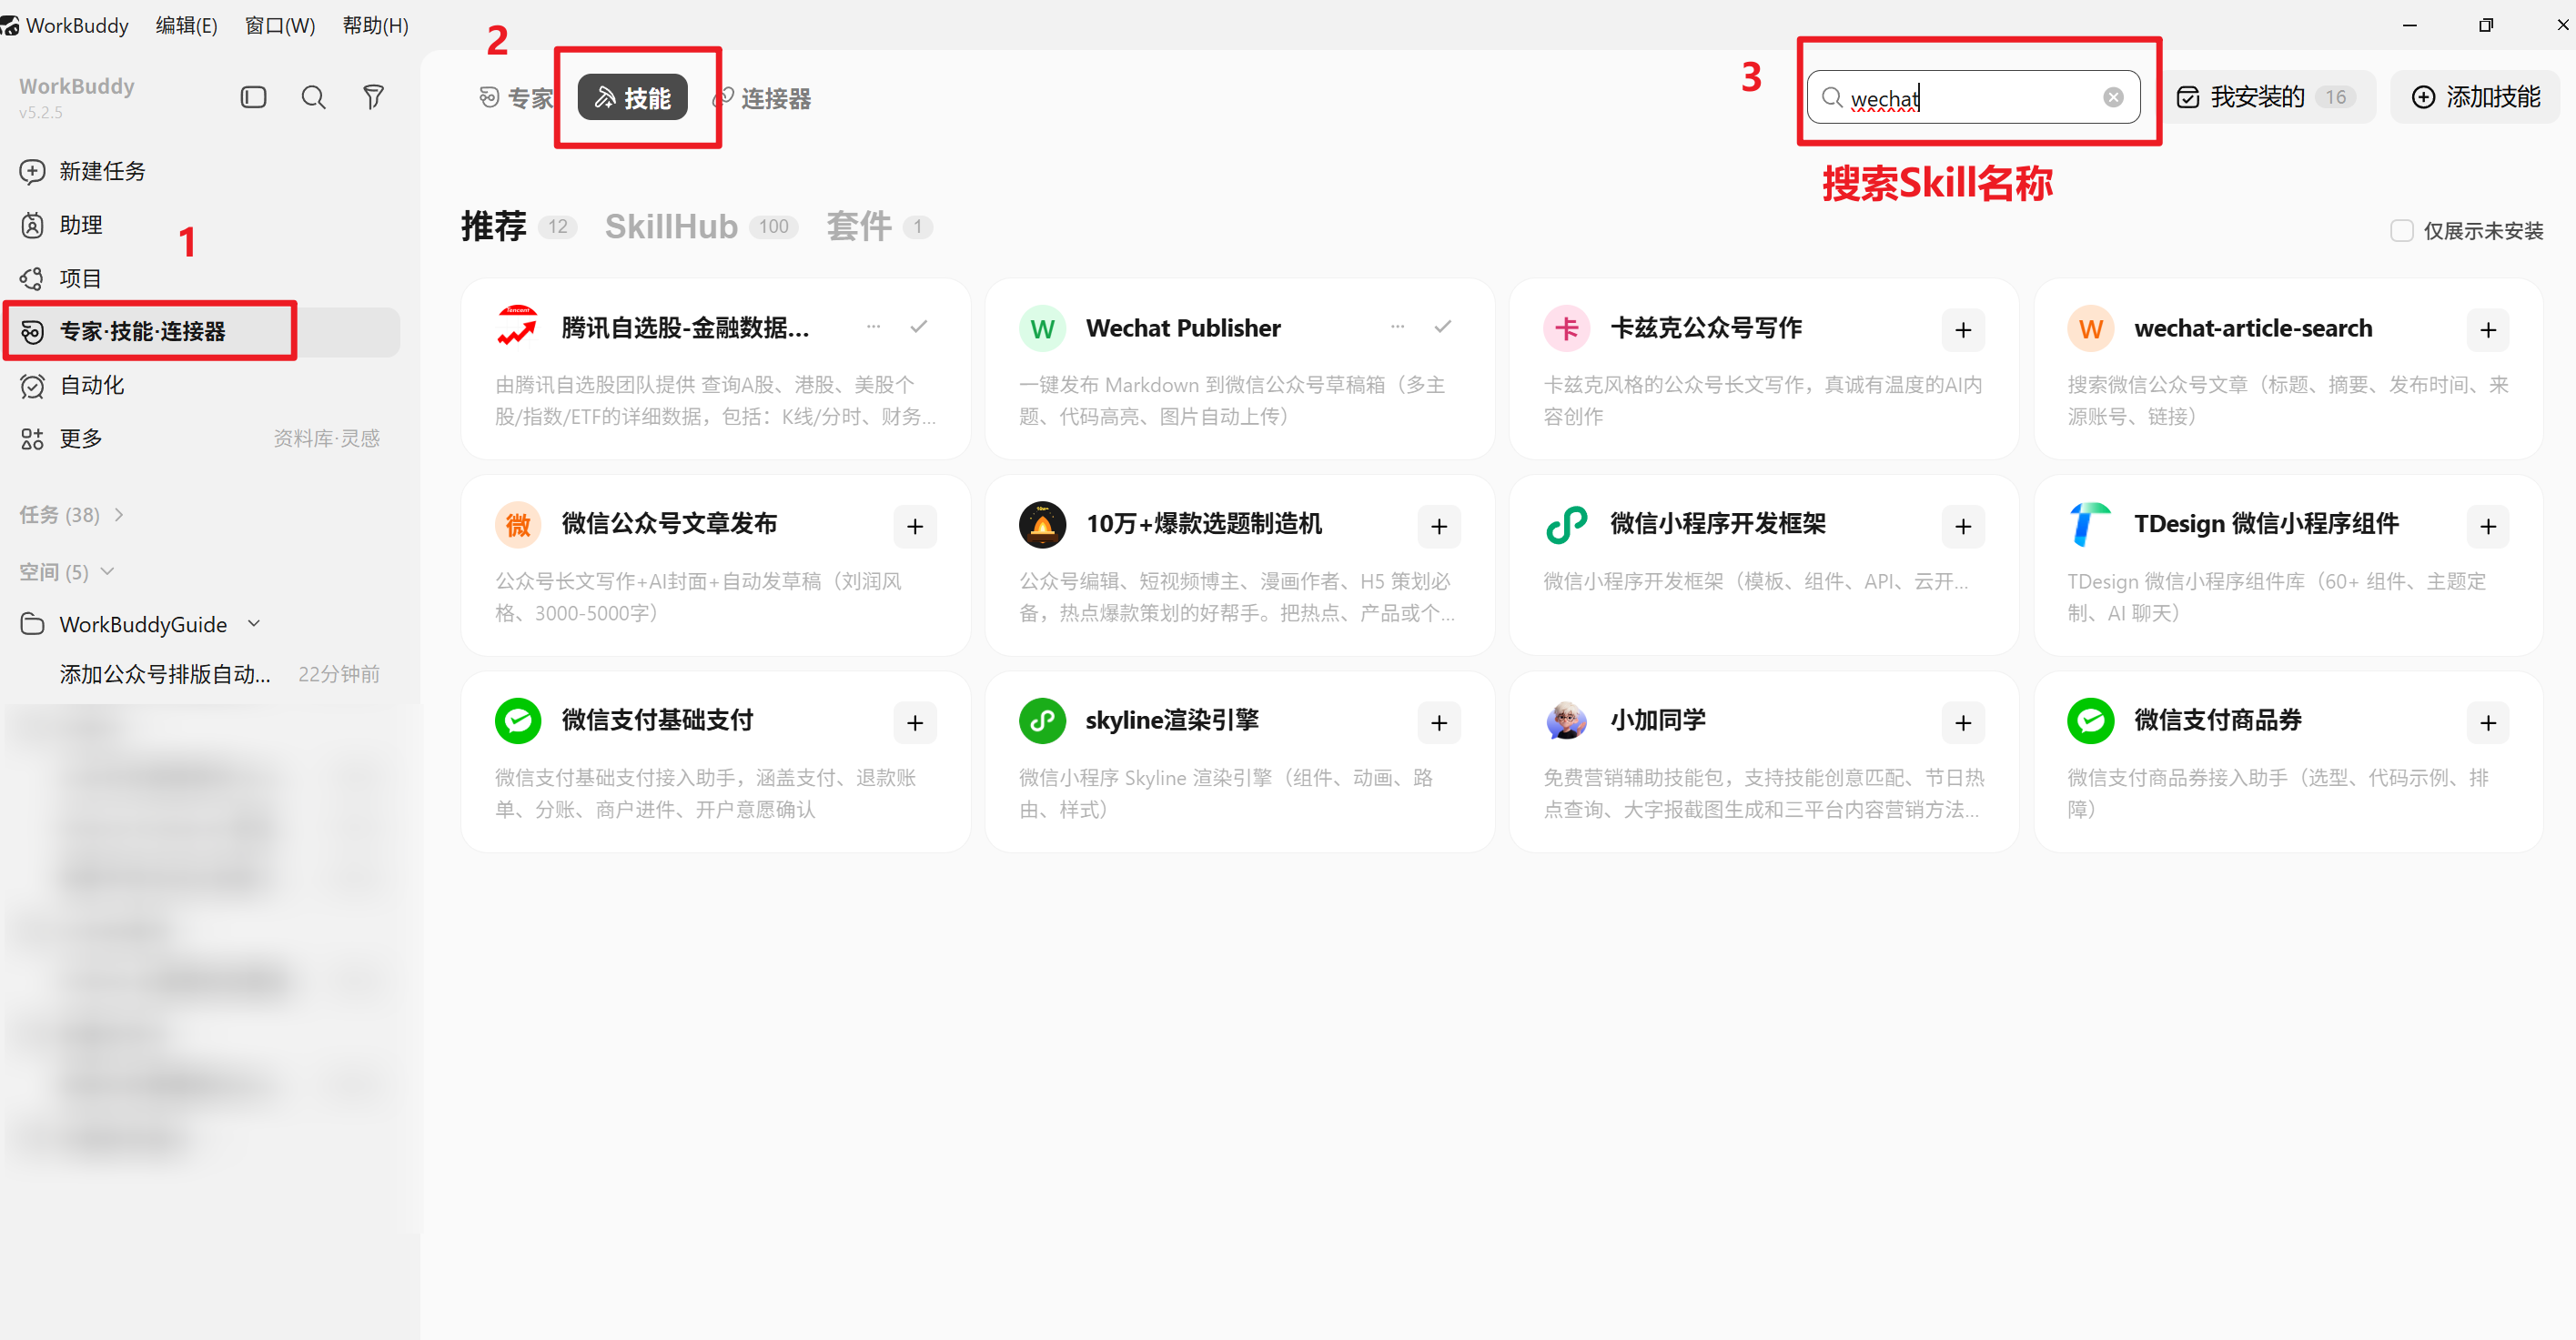 WorkBuddy 会从推荐市场中搜索并安装这个 Skill。安装完成后,可以确认一下 Skill 是否就位:
wechat-publisher Skill 已经安装好了吗?告诉我它能做什么。第二步:配置公众号凭证
wechat-publisher 需要公众号的 AppID 和 AppSecret 才能调用微信 API。推荐使用 wenyan 自带的凭证管理工具进行配置,凭证会持久化保存到本地配置文件:
帮我执行 wenyan credential -s,我需要配置公众号的 AppID 和 AppSecret。WorkBuddy 会引导你逐步输入 AppID 和 AppSecret,配置完成后对话框确认查看凭证文件是否已经保存成功。
注意:在配置凭证之前,务必先登录公众号后台(设置 → 开发 → 基本配置 → IP 白名单),将本机的公网 IP 添加到白名单中。可以用
curl ifconfig.me查看当前公网 IP。
第三步:准备 Markdown 文章
文章的 Markdown 文件需要包含 frontmatter,至少要有 title(标题)和 cover(封面图路径)。封面图可以是本地文件或网络 URL。
---
title: 我的技术文章
cover: case_assets/wechat-format-publish/cover.jpg
---

# 正文开始

这是文章内容...
可以直接在 WorkBuddy 中让 AI 帮你写好文章,也可以把自己写好的 Markdown 文件拖进对话。如果还没有封面图,还可以让 WorkBuddy 帮你生成一张:
帮我生成一张适用于公众号技术文章封面的图片,主题是关于 AI 辅助写作的。第四步:执行排版与发布
文章准备好后,告诉 WorkBuddy 执行发布:
使用 wechat-publisher Skill,把这篇文章发布到公众号草稿箱。

要求:
- 使用 lapis 主题
- 代码高亮用 solarized-light
- 启用 Mac 风格代码块
- AppID 用我之前配置的那个
WorkBuddy 会自动完成以下步骤:
- 检查 Markdown 文件的 frontmatter 是否完整
- 将文章中的图片上传到微信图床
- 应用所选主题和代码高亮样式进行排版转换
- 调用微信 API 将排版后的文章推送到草稿箱
第五步:在公众号后台预览与群发
发布到草稿箱后,登录微信公众号后台,在「内容管理 → 草稿箱」中就能看到排版好的文章。在后台预览确认无误后,即可群发。
提示词或任务指令
下面是经过脱敏、可以直接复用的任务指令:
使用 wechat-publisher Skill,把我写好的 Markdown 文章发布到公众号草稿箱。

具体要求:
1. 文章文件路径:D:/articles/my-post.md
2. 使用 lapis 主题和 solarized-light 代码高亮
3. 启用 Mac 风格代码块装饰
4. 文章中的图片(本地路径和网络 URL)全部自动上传到微信图床
5. 发布前确认 frontmatter 包含 title 和 cover
6. AppID 使用我之前通过 wenyan credential -s 配置的那个

发布成功后,告诉我如何到公众号后台预览这篇文章。
在 WorkBuddy 中的效果
这一套流程走完后,你得到的是:
- 一篇已经排版完成的公众号草稿,不需要在微信后台编辑器中手动调整字号、间距、图片位置。
- 文章中的代码块带有语法高亮和 Mac 风格装饰,比微信原生编辑器效果好得多。
- 所有图片已自动上传到微信图床,不会出现图片丢失或外链失效的问题。
- 在公众号后台稍作预览即可直接群发。
验收标准
- wechat-publisher Skill 安装成功,并能在任务中被调用。
- 公众号凭证配置成功,能看到已保存的 AppID。
- Markdown 文章成功推送到公众号草稿箱,后台可以看到排版后的文章。
- 文章中的代码块带有正确的语法高亮和主题样式。
- 文章中的所有图片(包括本地图片和网络图片)都能正常显示。
- 在公众号后台预览时,排版效果与预期一致。
常见问题
发布时报 "IP 不在白名单"
这是最常见的问题。登录公众号后台,在「设置 → 开发 → 基本配置 → IP 白名单」中添加当前机器的公网 IP。用 curl ifconfig.me 可以查看公网 IP。
报错 "未能找到文章封面"
检查 Markdown 文件的 frontmatter 中是否包含了 cover 字段。wenyan-cli 强制要求 title 和 cover 两个字段缺一不可。封面图路径建议使用绝对路径(Windows 下如 D:/photos/cover.jpg)。
图片上传失败
确保图片路径正确。如果 Markdown 中的图片使用相对路径,需要在 Markdown 文件所在目录执行发布命令。或者改用绝对路径引用图片。
想换一种排版风格
wechat-publisher 支持多种内置主题。可以在发布命令中更换 -t 参数,例如:
-t lapis:青金石主题(推荐)-t phycat:物理猫主题-t default:默认主题
代码高亮也可以通过 -h 参数切换,如 -h github、-h monokai、-h dracula 等。
当然,这些指令记记不住都没有关系,直接用自然语言描述,告诉AI你想做的事情,它可以帮你切换主题。
安全与限制
- AppID 和 AppSecret 是公众号的核心凭证,不要分享给他人,也不要在公开场合暴露。
- 推荐使用
wenyan credential -s配置凭证(凭证保存在本地加密文件中),避免将密钥写在命令或环境变量里。 - 公众号 IP 白名单建议只添加必要的 IP,并定期检查。
- 文章推送到的是草稿箱而非直接群发,发布前仍需人工审核内容。
- 如果文章包含公司内部或敏感信息,发布前先做脱敏处理。
可以怎样复用
这个 Case 的核心能力是「Markdown 写作 + 自动排版发布」。替换文章内容,就能适配不同的公众号创作场景:
- 技术博客:Markdown 写技术教程,代码块自动高亮,推送到草稿箱审核后群发。
- 团队周报:用模板和 Markdown 整理周报内容,自动排版后分享到团队公众号。
- 多号管理:通过
--app-id参数切换不同公众号,一个 Skill 管理多个号的草稿发布。 - 定期专栏:结合 WorkBuddy 自动化任务,把固定格式的文章模板设为每日或每周重复执行,实现定期更新。
分类:资讯整合难度:入门作者:WorkBuddy Guide 编辑组日期:2026-07-13Skill:AIHot
用 WorkBuddy 自动整理每日 AI 资讯
场景描述
AI 资讯更新很快,同一事件经常出现在多个媒体和信息源中。逐个网站浏览不仅耗时,也容易错过模型发布、产品更新、开源项目和行业变化。
这个案例适合需要持续关注 AI 行业的产品、研发、运营、投资和内容团队。我们希望把“到处找新闻”变成一次可以重复执行的 WorkBuddy 任务。
想要完成的任务
完成后,WorkBuddy 应当能够:
- 查询指定时间范围内的 AI 行业动态。
- 按公司、模型、产品或主题筛选内容。
- 为每条信息保留标题、摘要、发布时间和来源链接。
- 把大量候选信息整理成更容易阅读的热点报告。
- 根据任务要求重点关注大模型、产品、开源项目或论文等方向。
AIHot Skill 能做什么
AIHot 是面向 AI 动态的信息类 Skill,适合查询和整理模型、产品、行业、论文与开源项目等方向的近期内容。它可以作为 WorkBuddy 的现成信息源,根据你的任务描述返回相关资讯和原始链接。
| 用法 | 任务示例 | 适合谁 |
|---|---|---|
| 公司动态追踪 | 最近 7 天 OpenAI 发布了什么 | 产品、研发、投资 |
| 每日热点整理 | 总结今日 AI 大模型热点 | AI 团队、内容团队 |
| 专题检索 | 查找最近一周多模态模型相关动态 | 研究、产品规划 |
| 来源补充 | 给每条结论保留原始报道链接 | 需要进一步核查的读者 |
AIHot 负责提供和检索候选资讯;哪些内容值得重点关注、怎样分类和以什么格式输出,由你写给 WorkBuddy 的任务描述决定。
安装前准备
- 已经可以正常使用 WorkBuddy。
- WorkBuddy 可以访问外部网页。
- AIHot Skill 地址:
https://aihot.virxact.com/aihot-skill/
AIHot 来自外部地址。安装前应查看来源域名和 Skill 内容,并让 WorkBuddy 先执行安全检查。不要安装来源不明、要求异常权限或包含可疑脚本的 Skill。
在 WorkBuddy 中安装 AIHot Skill
打开一个新的 WorkBuddy 任务,直接输入:
帮我安装这个 skill:https://aihot.virxact.com/aihot-skill/WorkBuddy 会先获取 Skill 内容,并调用 Skill 安全检查流程。确认来源、权限和将要执行的内容没有异常后,再继续安装。
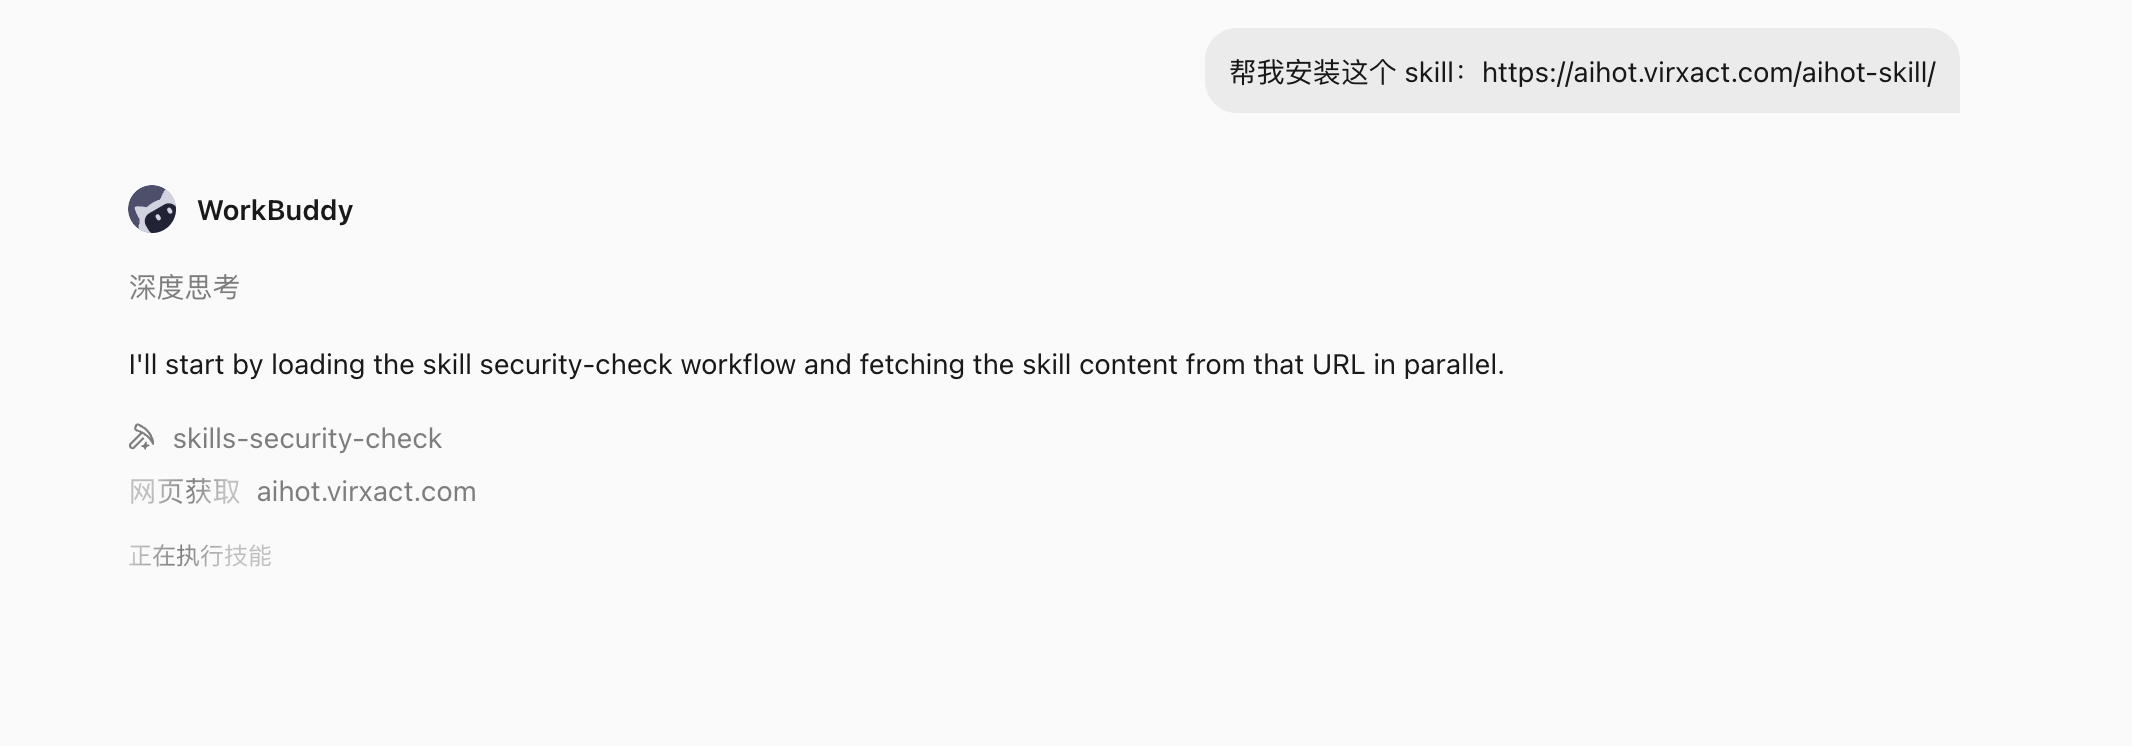
安装完成后,可以继续问:
请告诉我 AIHot Skill 已经安装到哪里、它能完成哪些任务,以及调用时是否需要额外账号或权限。这一步可以帮助你确认 Skill 是否真的可用,而不是只看到安装任务结束。
任务一:查询最近 OpenAI 动态
最简单的任务描述是:
请看一下最近 OpenAI 发布了什么新东西。为了让结果更稳定、方便核查,推荐写得更明确:
使用 AIHot Skill 查询最近 7 天与 OpenAI 相关的动态。

要求:
1. 优先整理 OpenAI 官方发布、模型与产品更新、API 变化和重要行业动态;
2. 合并明显重复的同一事件;
3. 每条内容包含标题、发布时间、两句话摘要和原始来源链接;
4. 按“官方动态、产品与模型、行业影响”分类;
5. 不确定的信息请明确标记,不要补写没有来源支持的结论。
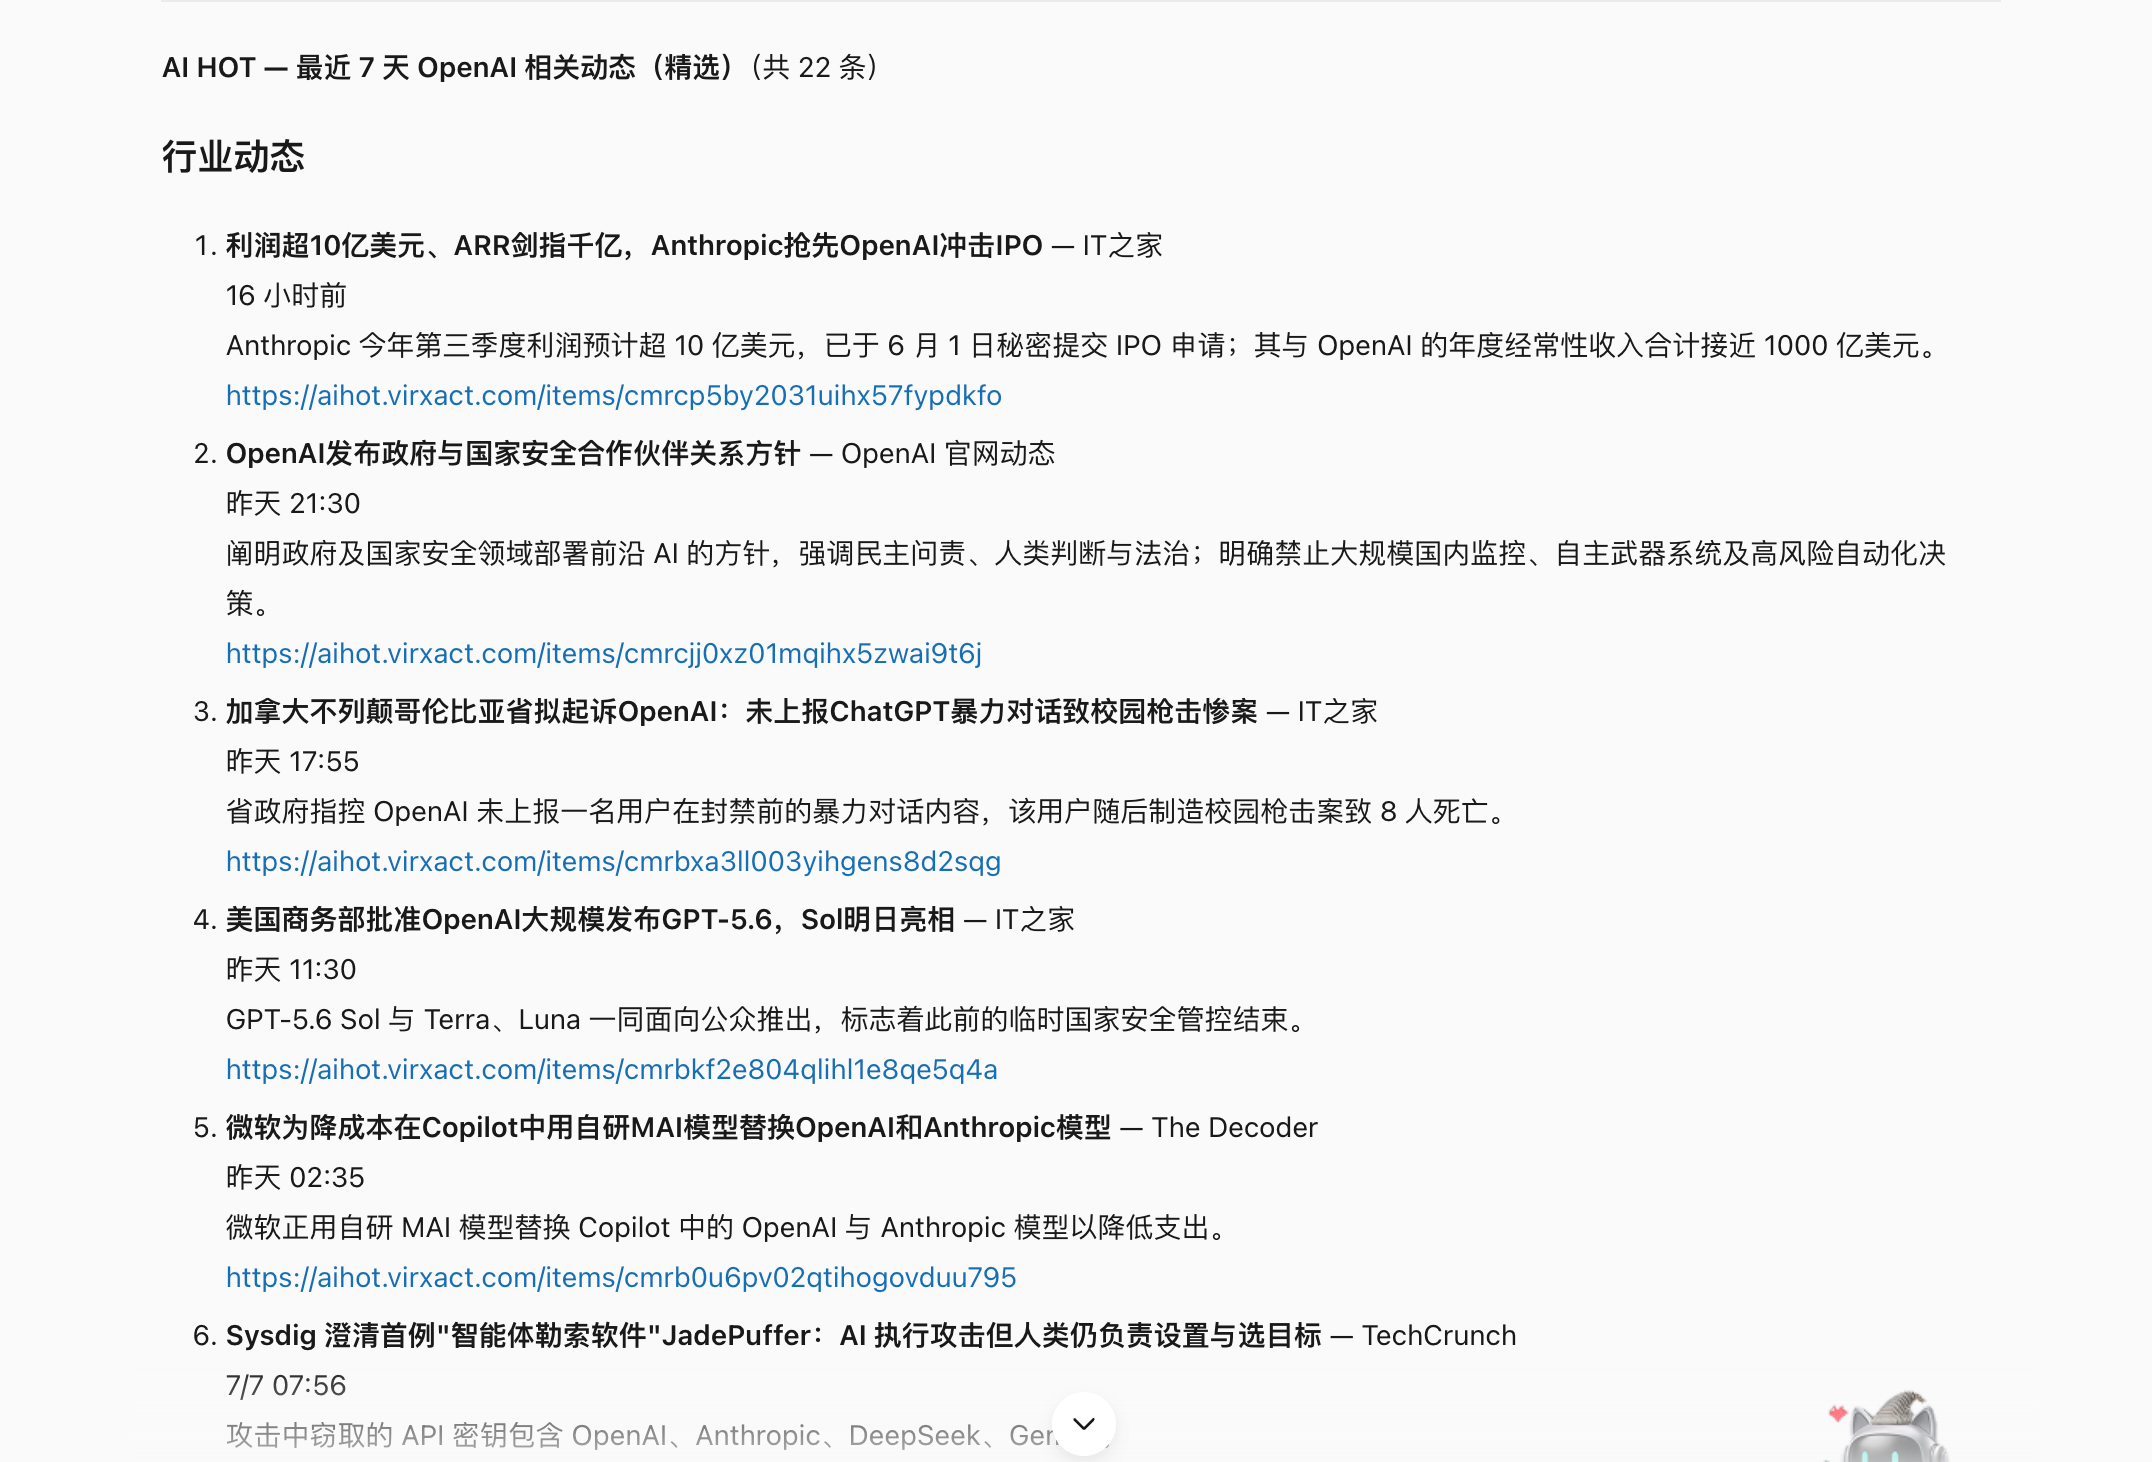
实际运行后,WorkBuddy 返回了最近 7 天的 OpenAI 相关内容,并为每条资讯保留标题、时间、摘要和 AIHot 原始链接:
任务二:生成今日 AI 大模型热点总结
如果希望得到一份更接近日报的结果,可以输入:
使用 AIHot Skill 总结今天的 AI 热点新闻,重点关注 AI 大模型方向。

请按下面结构输出:
1. 今日最热:列出最值得关注的 3 条动态;
2. 大模型新发布:整理最近 7 天值得关注的模型、产品和开源项目;
3. 每条包含一句话摘要、为什么值得关注和来源链接;
4. 合并重复报道,并注明有多少个信息源在报道同一事件;
5. 最后用一句话总结今天的大模型行业主线。
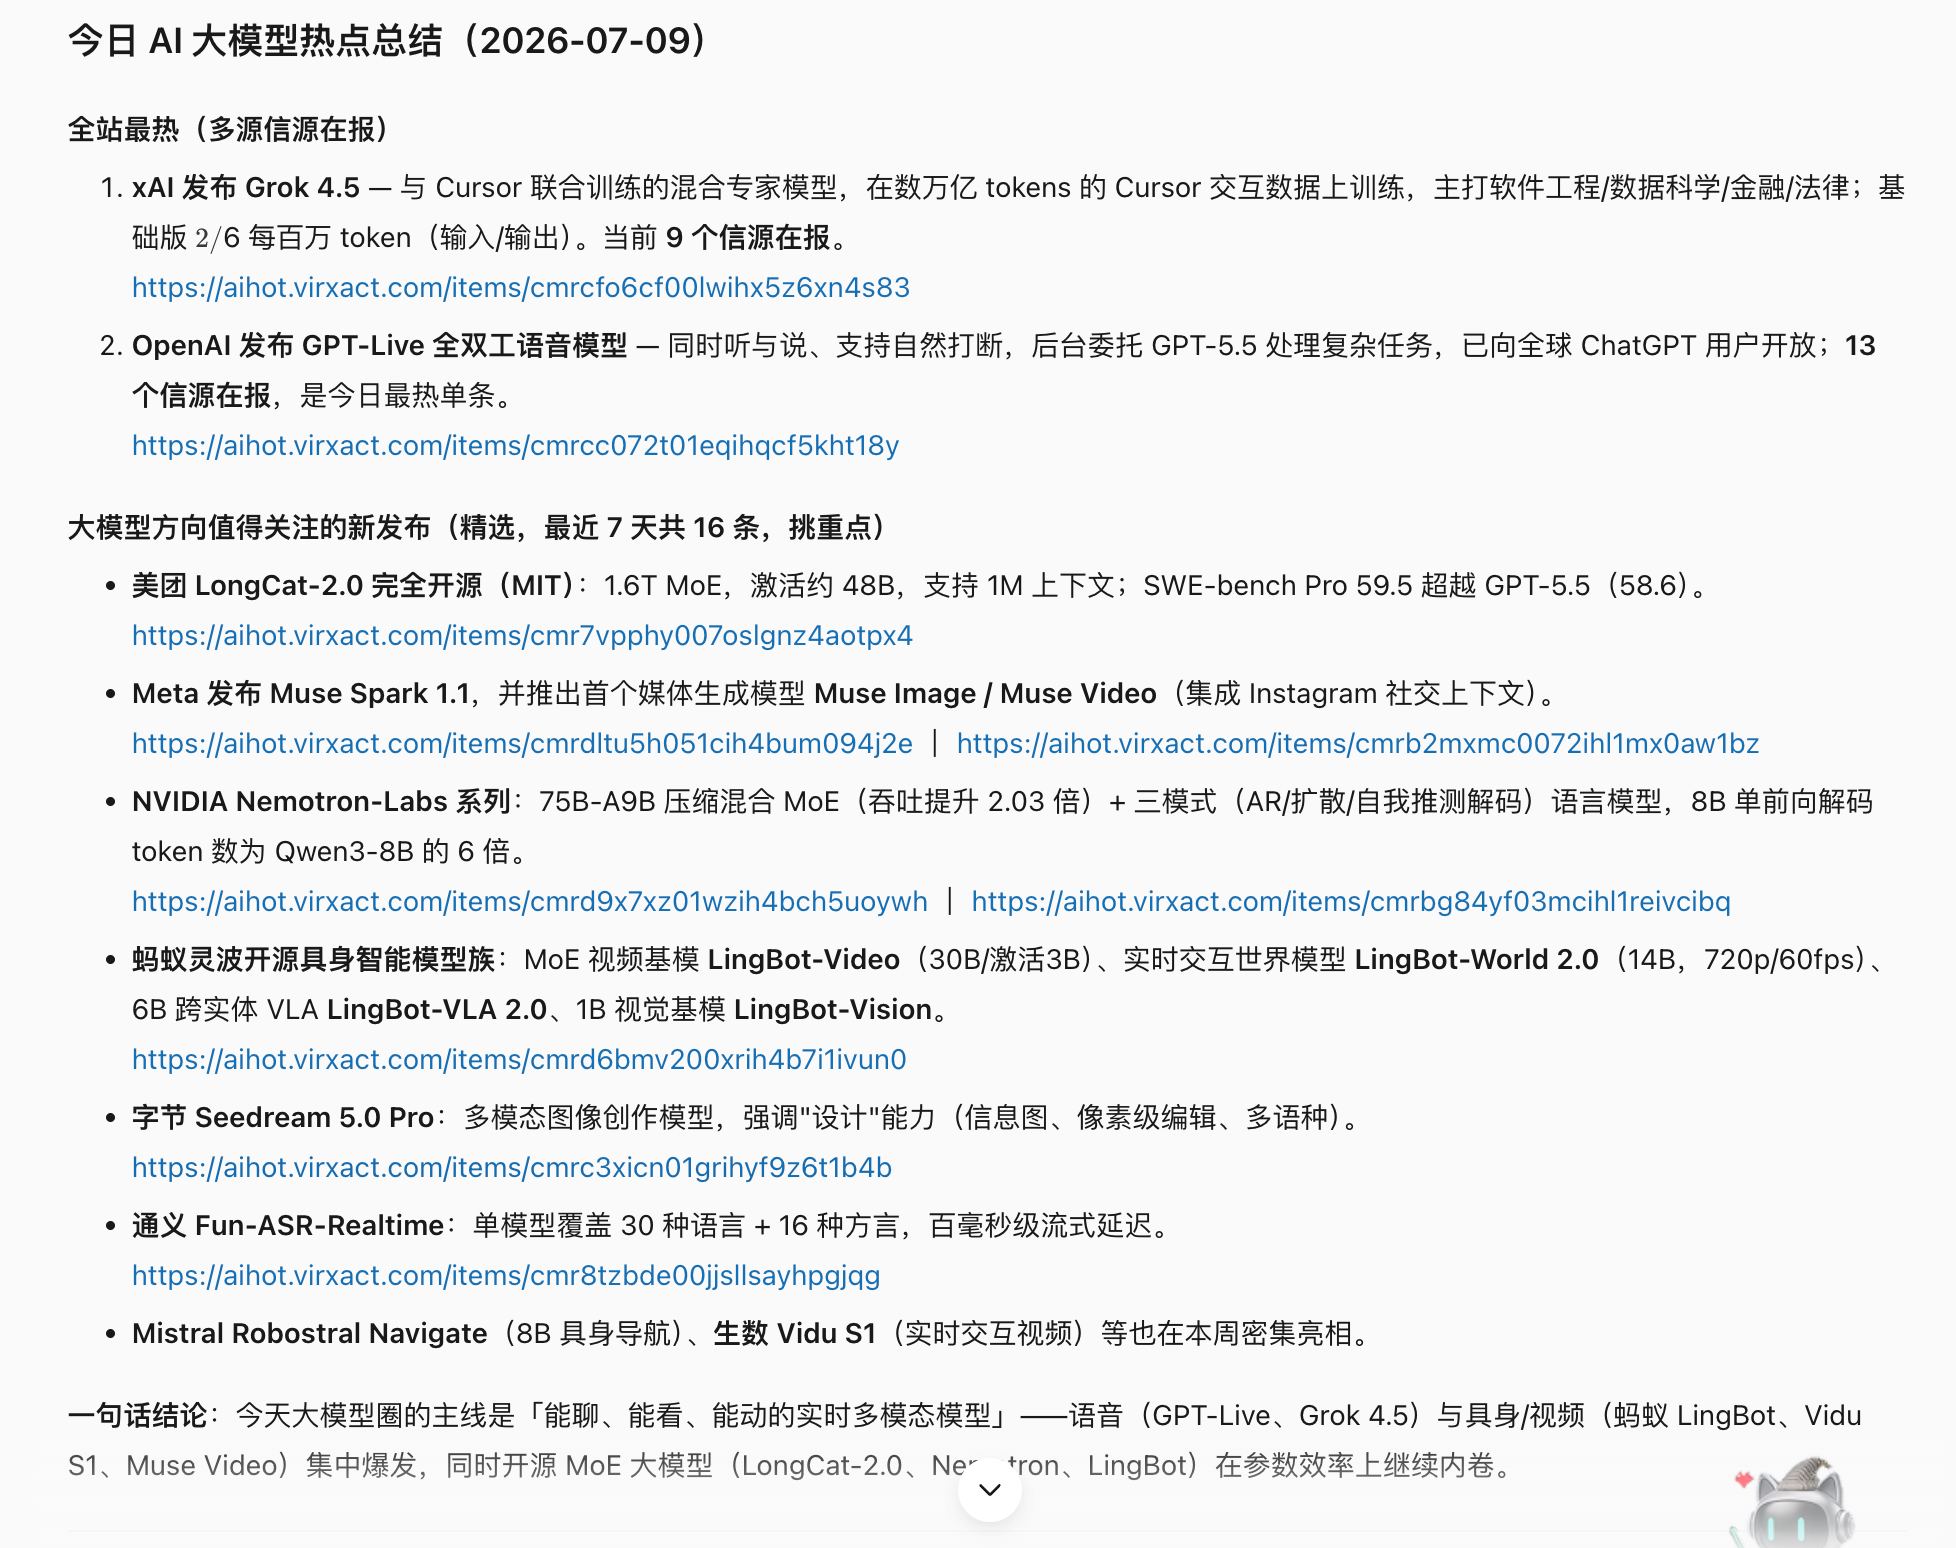
实际结果按照热点和大模型方向进行了整理,保留了具体来源链接,并给出一句话结论:
怎样把任务描述写得更好
一个稳定的 AIHot 任务描述,至少应该明确四件事:
| 要素 | 写法示例 |
|---|---|
| 时间范围 | 今天、最近 24 小时、最近 7 天 |
| 关注主题 | OpenAI、大模型、多模态、AI Agent、开源项目 |
| 筛选标准 | 只保留重要更新、合并重复事件、优先官方来源 |
| 输出格式 | 标题、摘要、时间、影响判断、来源链接 |
如果只说“总结 AI 新闻”,WorkBuddy 仍然可以执行,但结果的数量、范围和格式不够稳定。任务描述越明确,输出越容易复用和验收。
最终效果
通过 AIHot Skill,WorkBuddy 把分散的 AI 资讯整理成了两类可以直接阅读的结果:
- 围绕特定公司或主题的近期动态列表。
- 经过筛选、分类和去重的 AI 热点总结。
每条信息都保留来源链接,读者可以继续打开原文核查,而不是只依赖模型生成的摘要。
验收标准
- AIHot Skill 已成功安装,并能在新任务中被调用。
- 查询结果符合任务指定的时间范围和主题。
- 每条重要资讯都保留了可以继续访问的来源链接。
- 相同事件不会被当作多条重点新闻重复呈现。
- 摘要没有加入来源无法支持的数字和结论。
- 热点报告的分类与任务描述一致。
常见问题
安装后没有调用 AIHot
在任务中明确写出“使用 AIHot Skill”,并让 WorkBuddy 说明它实际调用了哪个 Skill。如果仍然不可用,检查 Skill 是否安装成功以及当前工作区是否能看到它。
返回的信息太多
缩短时间范围,限定公司或主题,并明确只保留 5~8 条最重要内容。
结果看起来像普通摘要
要求保留发布时间、来源名称和原始链接,并明确写出分类、去重和影响判断规则。
安全与限制
- AIHot 是资讯来源,不代表所有内容都已经完成事实核查。
- 对重要结论,应继续打开原始链接,优先核对官方来源。
- 新闻内容会随时间变化,相同任务在不同日期得到的结果也会不同。
- 安装外部 Skill 前应检查来源、权限和脚本内容。
- 不要把未经核实的热点摘要直接用于正式对外发布。
可以怎样复用
把任务中的主题替换掉,就可以快速得到不同方向的资讯报告,例如:
使用 AIHot Skill 查询最近 7 天 AI Agent 相关动态,重点关注新产品、开源框架和企业落地案例。每条保留来源链接,最后总结 3 个值得团队继续研究的方向。也可以在确认单次任务稳定后,再结合 WorkBuddy 自动化任务,把相同提示词设置为每日或每周重复执行。自动化属于后续扩展,这个 Case 首先确保 AIHot 的安装、调用和输出可以独立跑通。
分类:数据分析难度:进阶作者:stephenlzc日期:2026-07-25Skill:浏览器Skill:本地文件读写Skill:Python 代码执行
用 WorkBuddy 专家团吃透十年年报:一套可复用的上市公司深度研究方法
场景描述
商业分析人员(MBA 学员、咨询顾问、行业研究员、投资与战略岗)面对一家陌生上市公司时,核心问题不是「缺信息」,而是如何在短时间内建立对这家公司完整、可信、可检验的认知。最权威、最完整的公开素材是历年年度报告,但一年一份的年报动辄两三百页,十年就是数千页,人工通读并交叉核对叙事口径与财务数据通常需要数周,且很难做到逐年可比、口径一致。
这个案例的价值不在于「产出了一份数字化转型分析报告」这个交付物本身,而在于它完整演示了一套通用的「上市公司深度研究」方法论:以一手信源为底座、文本与数据双线交叉验证、理论框架作分析骨架、全流程可复现——并把这套方法一次性交给 WorkBuddy 的「智数分析专家团」(Agent Swarm 多智能体团队)执行:从巨潮资讯网下载十年年报原文,到 PDF 解析、文本语义分析、财务量化、理论框架整合、图表制作,再到最终 HTML 咨询报告,全链路自动完成,所有中间计算以 Python 脚本保存、可复现复算。
本案例选中的分析主题是「数字化转型叙事」,但它只是这套方法论的一个「镜头」。研究管线本身(年报获取 → 结构化解析 → 文本+财务双线量化 → 理论框架整合 → 咨询报告交付)与分析主题无关,可以直接迁移到上市公司运营分析、销售与营销分析、人力资源分析、财务质量分析、ESG 分析等各类工商管理研究场景,只需替换提示词模板中的占位符(见下文「提示词或任务指令」)。
想要完成的任务
输入:一家工业自动化领域的 A 股上市公司的名称与股票代码(本案例已对具体公司做匿名化处理),以及分析区间(2015–2025,共 11 个年度)。
目标和交付物:
- 从巨潮资讯网自动下载分析区间内的全部年报原文 PDF(11 份)
- 解析年报,聚焦「管理层讨论与分析」(MD&A)章节,做文本语义分析:关键词词频、主题模型(LDA)、叙事强度轨迹
- 提取财务数据,做财务指标与数字化投入的量化分析(增长、盈利、研发强度、人均效能等)
- 引入 MBA 战略与数字化转型理论作为分析框架,理论与实践结合
- 生成一份专业咨询报告风格、可离线打开的 HTML 报告:目录导航、公司现状概述、核心问题分析、改善措施与战略举措建议、图表(趋势图、对比柱状图、雷达图等)、小结与结论
- 所有中间计算以 Python 脚本保存,保证全流程可复现
这套任务定义背后,是一套可以迁移到任何一家公司的研究方法论,也是商业分析人员系统研究一家上市公司的标准思路:
- 以一手信源为底座:不依赖二手研报和新闻拼凑印象,直接从官方披露渠道获取十年年报原文,确保分析起点是未经转述的一手材料。
- 文本 + 数据双线交叉验证:管理层叙事(文本语义)说了什么,与财务数据实际呈现什么,两条线对照才能识别「叙事与现实的偏离」——本案例的「叙事解耦」发现正是由此而来。
- 理论框架作为分析骨架:用成熟的工商管理理论组织发现、解释数据,而不是把指标堆砌在一起;理论是骨架,数据是证据。
- 全流程可复现:中间计算以脚本保存,任何结论都可被复查、复算——这是「研究」区别于「一次性生成」的关键,也是结论敢拿去答辩、汇报、尽调的前提。
- 专家团分工与研究流程同构:资料检索 → 数据工程 → 分析 → 可视化 → 成稿,智能体的角色分工与人的研究团队一一对应,方法论不需要为工具做任何妥协。
使用的 Skill
| Skill | 用途 | 来源或安装方式 |
|---|---|---|
| 浏览器 | 访问巨潮资讯网,检索并下载指定公司分析区间内的年度报告 PDF | WorkBuddy 内置 |
| 本地文件读写 | 组织年报、中间数据、脚本与交付物的目录结构 | WorkBuddy 内置 |
| Python 代码执行 | 运行 PDF 解析、文本语义分析、财务分析、图表生成等可复现脚本 | WorkBuddy 内置 |
多智能体协同由 WorkBuddy 的「智数分析专家团」(Agent Swarm)完成:下达总指令后,专家团自动拆解任务、生成 to-do list,并由团队负责人按角色分派给知识检索、数据科学、报告撰写、可视化设计等成员并行执行。无需额外安装 Skill。
前置条件
- WorkBuddy 可正常使用,能读写本地文件、能联网(用于从巨潮资讯网下载年报)
- WorkBuddy 自带的 Python 环境(由 WorkBuddy 自动管理,无需手工安装依赖)
- 可使用「智数分析专家团」(Agent Swarm 多智能体团队)
- 不需要任何付费账号或 API Key(年报为公开披露文件)
- 分析对象为公开上市公司,分析区间内的年报在巨潮资讯网上均可获取
在 WorkBuddy 中的操作
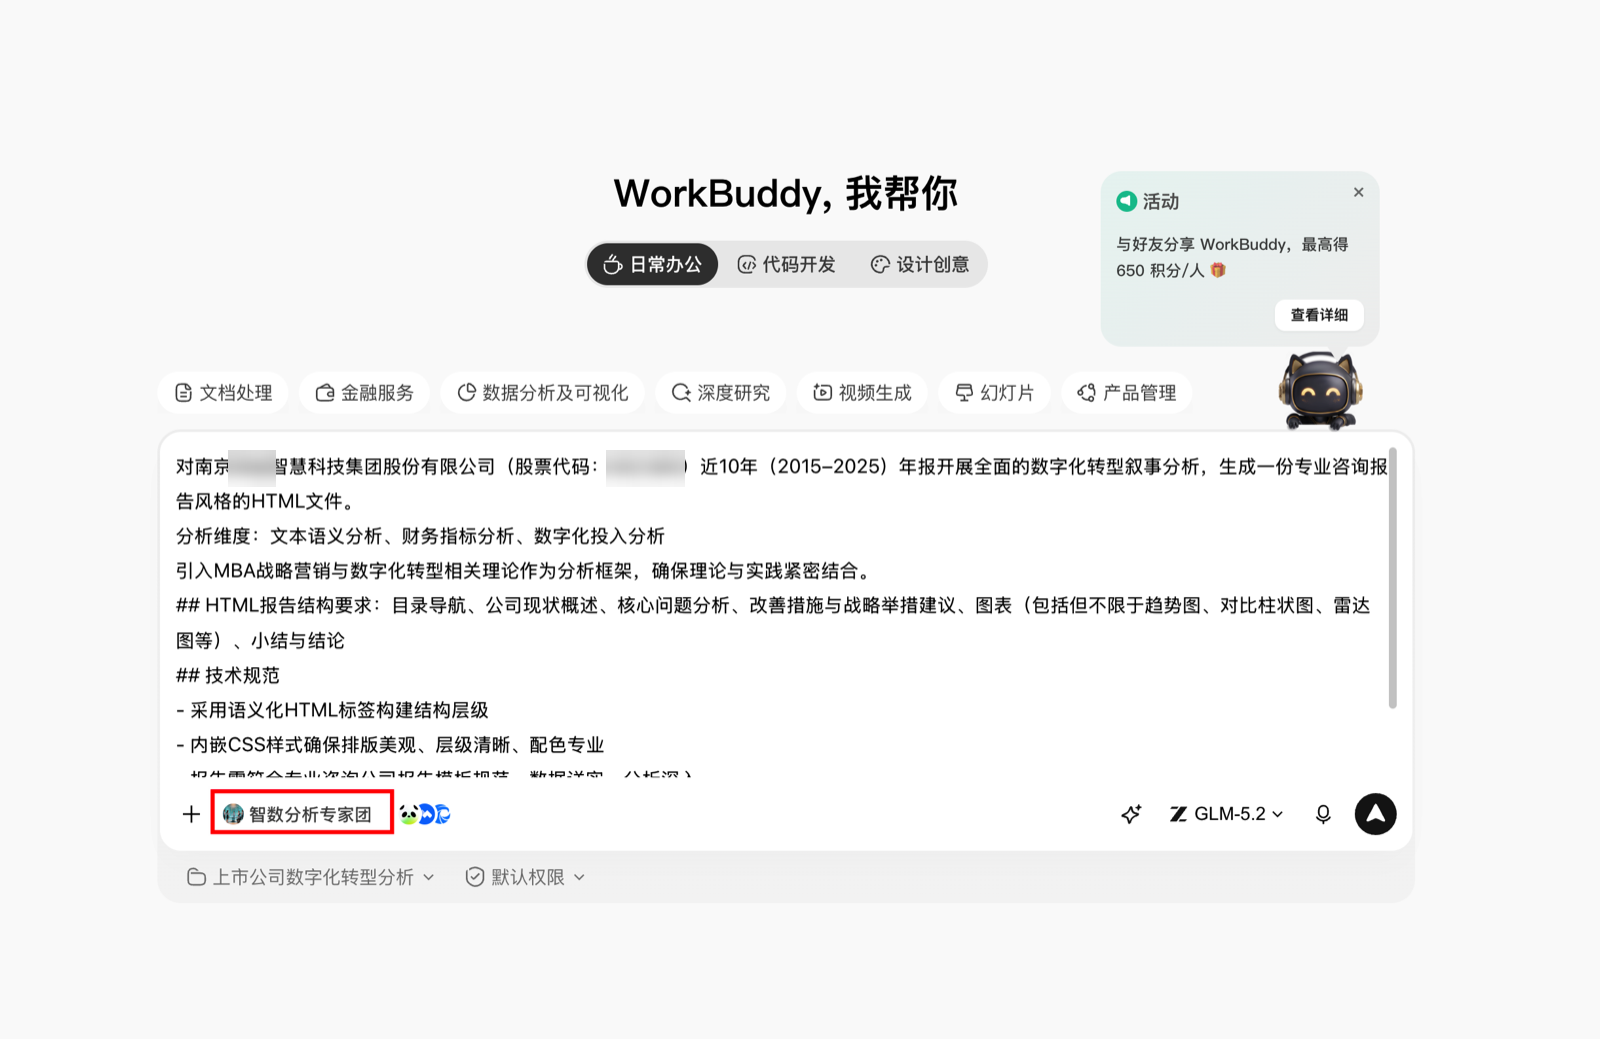
- 下达总指令:在 WorkBuddy 首页输入任务指令,并在输入框左侧选中「智数分析专家团」。指令只需说清公司、区间、分析维度、理论框架、交付物和技术规范(泛化模板见下一节)。
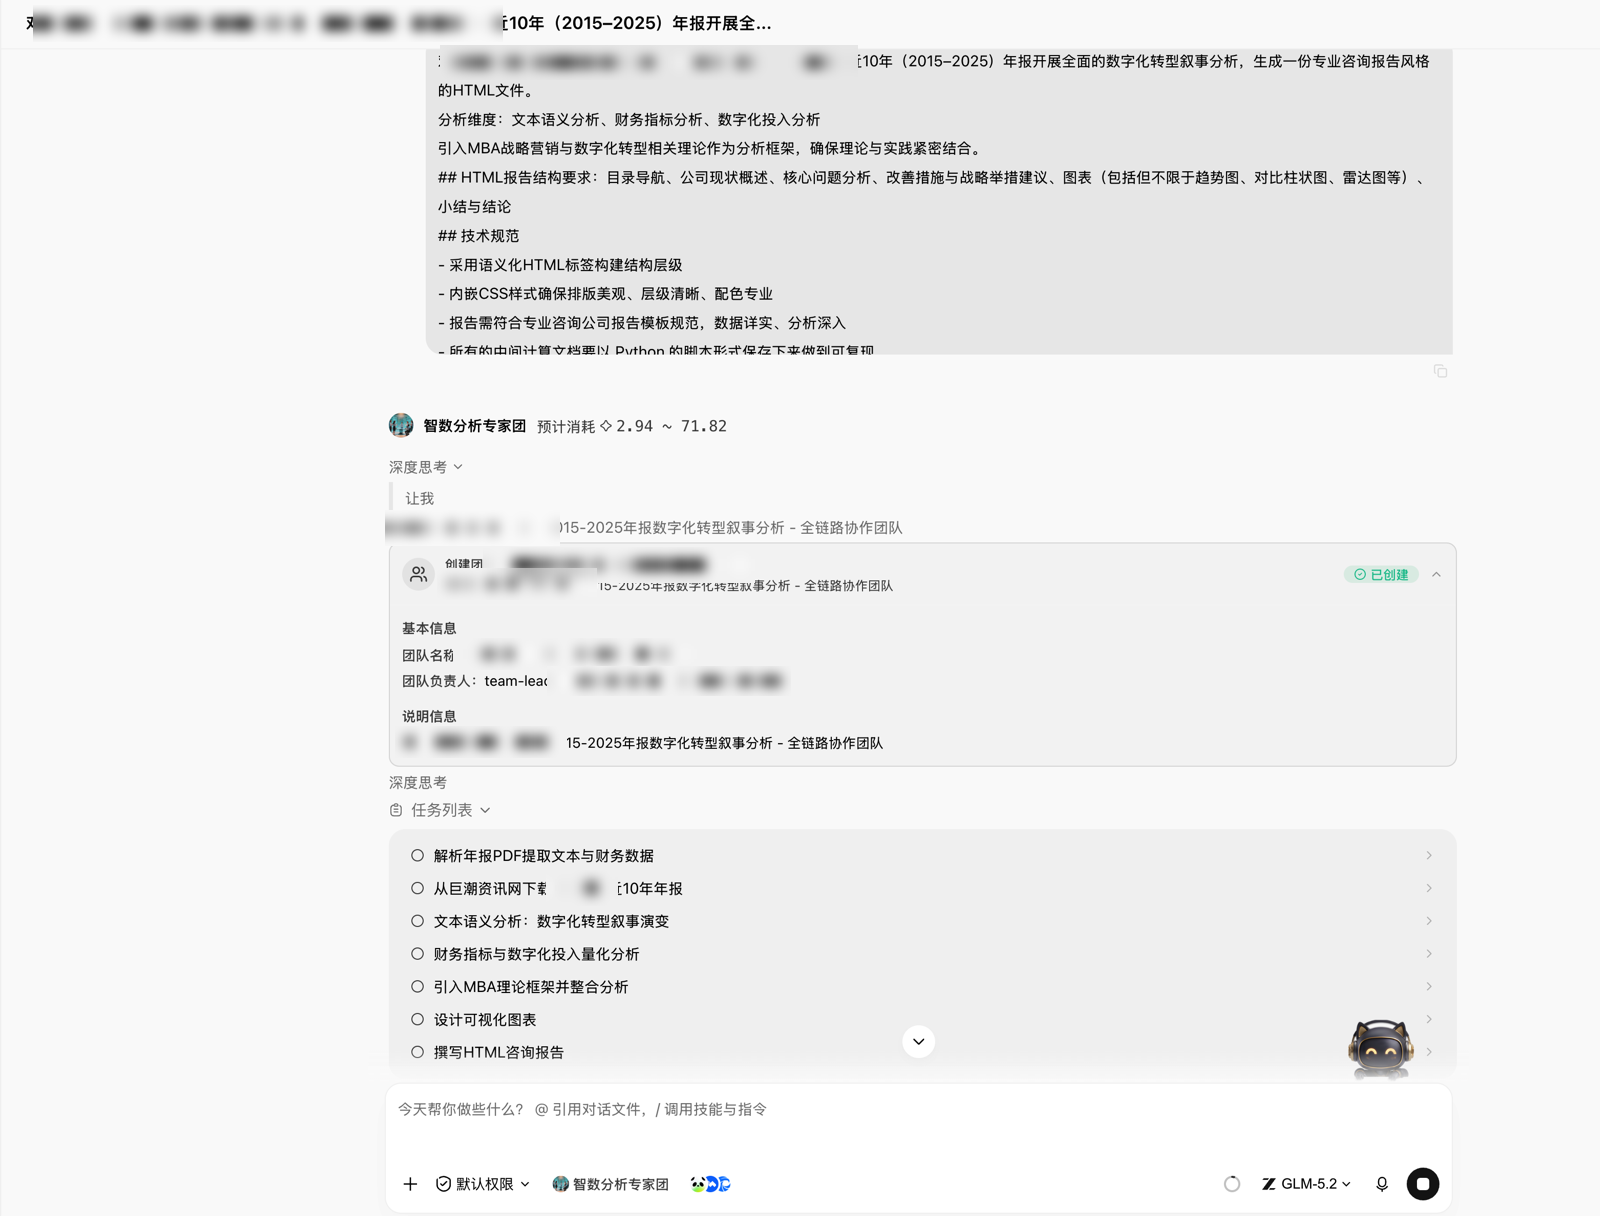
- 专家团拆解任务:专家团接到指令后自动创建协作团队(团队名按「公司-分析主题」自动命名),并生成任务清单 to-do list:下载年报 → 解析 PDF 提取文本与财务数据 → 文本语义分析 → 财务指标与数字化投入量化分析 → 引入 MBA 理论框架并整合 → 设计可视化图表 → 撰写 HTML 咨询报告 → 汇编综合交付。
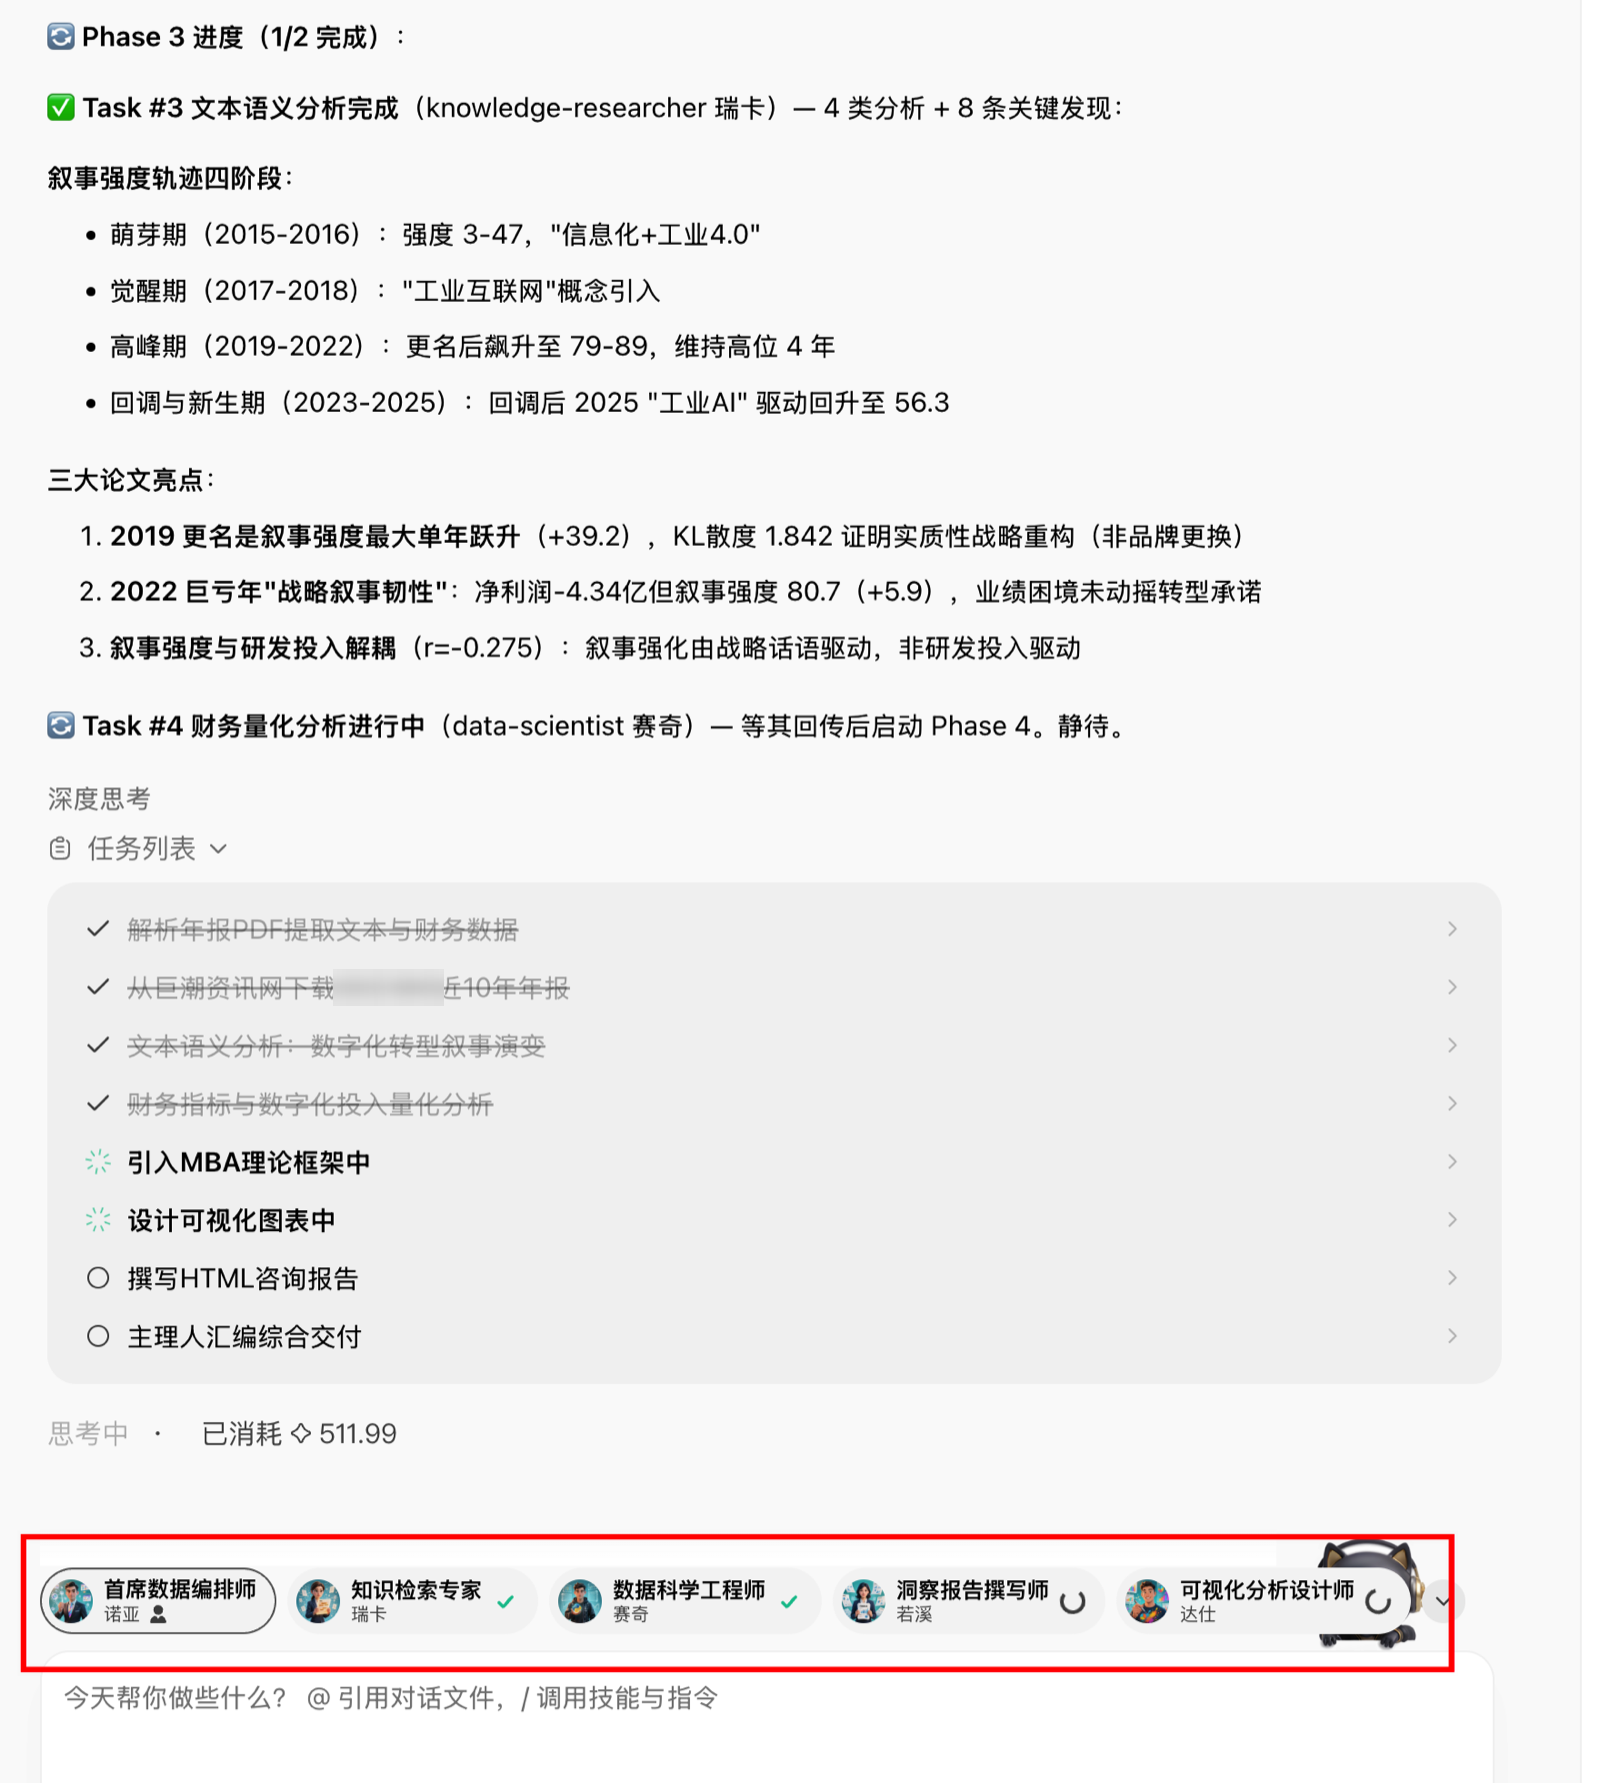
- 分工并行执行:团队负责人按阶段(Phase)调度 5 位成员——首席数据编排师、知识检索专家、数据科学工程师、洞察报告撰写师、可视化分析设计师。底部成员头像实时显示各自进度(✓ 已完成 / 转圈中为执行中),每完成一项任务,负责人会汇报关键发现,例如「叙事强度轨迹四阶段」这类中间结论。
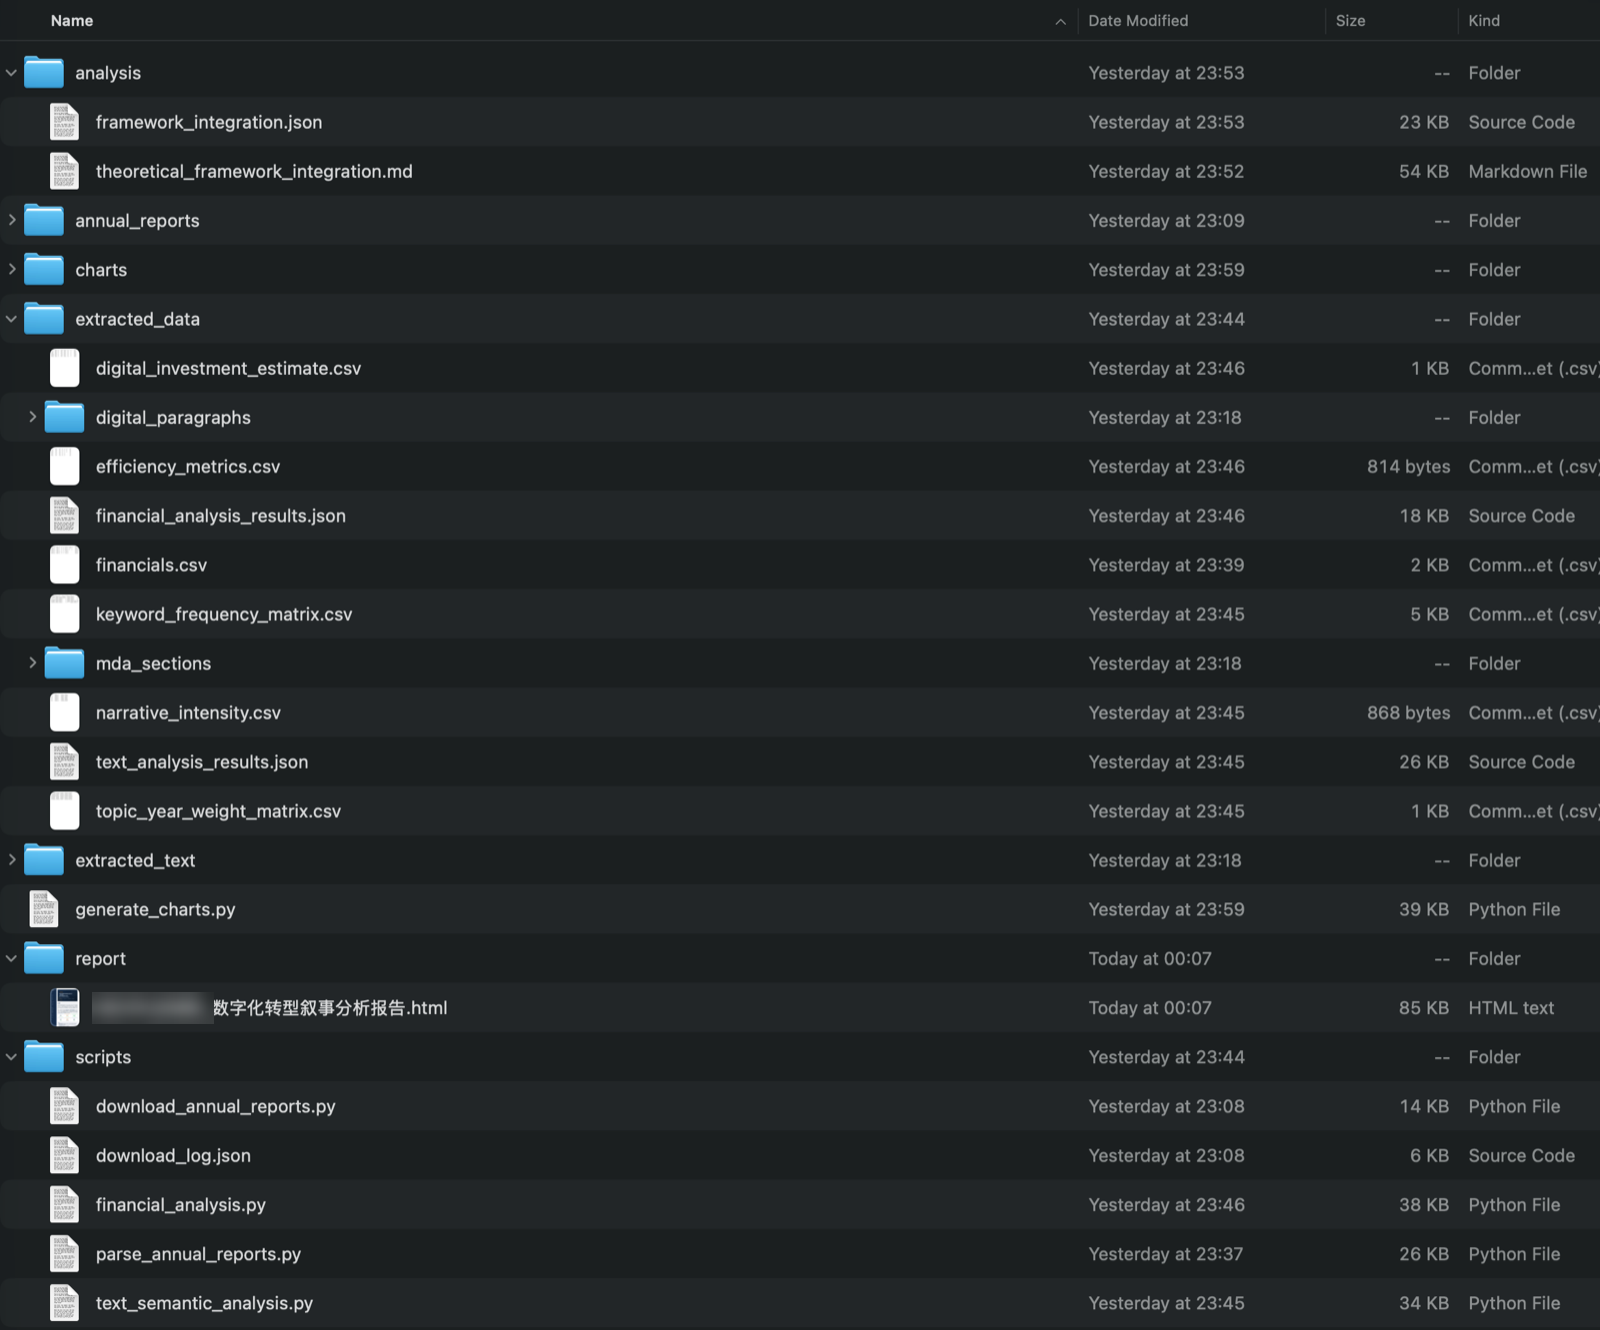
- 过程产物落盘:执行过程中,年报原文、解析后的文本与结构化数据、可复现脚本、中间分析结果分别写入
annual_reports/、extracted_text/、extracted_data/、scripts/等目录,全程可追溯。
- 交付汇总:全部任务完成后,专家团给出交付总结(本案例耗时约 1 小时),列出每项交付物的路径和说明,人只需打开最终 HTML 报告审阅。
提示词或任务指令
以下为本案例提示词的泛化模板版。将 {占位符} 替换为具体内容,即可复用到任何一家上市公司、任何一种工商管理分析主题:
对 {公司名称}(股票代码:{股票代码})在 {分析区间,如 2015–2025} 的 {数据来源,如历年年报}
开展全面的 {分析主题,如数字化转型叙事分析},生成一份专业咨询报告风格的 {交付物格式,如 HTML 文件}。

## 分析维度
{分析维度,如:文本语义分析、财务指标分析、数字化投入分析;
 换主题可替换为:运营效率、销售结构、人力资源效能、财务质量、ESG 表现等}

## 理论框架
引入 {理论框架,如 MBA 战略营销与数字化转型相关理论} 作为分析框架,
确保理论与实践紧密结合。

## 交付物结构要求
{交付物结构,如:目录导航、公司现状概述、核心问题分析、改善措施与战略举措建议、
 图表(趋势图、对比柱状图、雷达图等)、小结与结论}

## 技术规范
- 采用语义化 HTML 标签构建结构层级,内嵌 CSS 样式,排版美观、层级清晰、配色专业
- 报告需符合专业咨询公司报告模板规范,数据详实、分析深入
- 所有的中间计算以 Python 脚本形式保存下来,做到可复现
- 原始数据从 {数据来源渠道,如巨潮资讯网} 获取原文
各占位符填写说明(括号内为本案例的填写示例):
{公司名称}/{股票代码}:分析对象(示意写法:某智能制造企业 / 6 位股票代码;本案例填写的是一家工业自动化领域的 A 股上市公司)。换公司时只需替换这两项。{分析区间}:建议覆盖 5–10 个完整年度,保证趋势可比(2015–2025,共 11 份年报)。{数据来源}:原始素材类型与获取渠道(巨潮资讯网公开披露的年度报告)。也可换成招股说明书、ESG 报告、业绩说明会纪要等。{分析维度}:决定专家团拆解出的分析任务(文本语义分析、财务指标分析、数字化投入分析)。{理论框架}:希望引入的理论体系(MBA 战略营销与数字化转型理论——实际执行中专家团落到了动态能力、资源基础观/VRIO、波特价值链、数字化成熟度、平台战略与网络效应、技术接受模型 TAM 六大框架)。{交付物结构}与{技术规范}:把「报告长什么样」写死,避免交付形态靠模型猜;「中间计算以 Python 脚本保存」这一条务必保留,它是可复查、可复算的关键。
这套模板适用于工商管理领域的各类上市公司分析:战略与数字化转型、运营效率、销售与营销、人力资源、财务质量、ESG 等,换主题时只改 {分析维度} 和 {理论框架} 两处即可。
在 WorkBuddy 中的效果
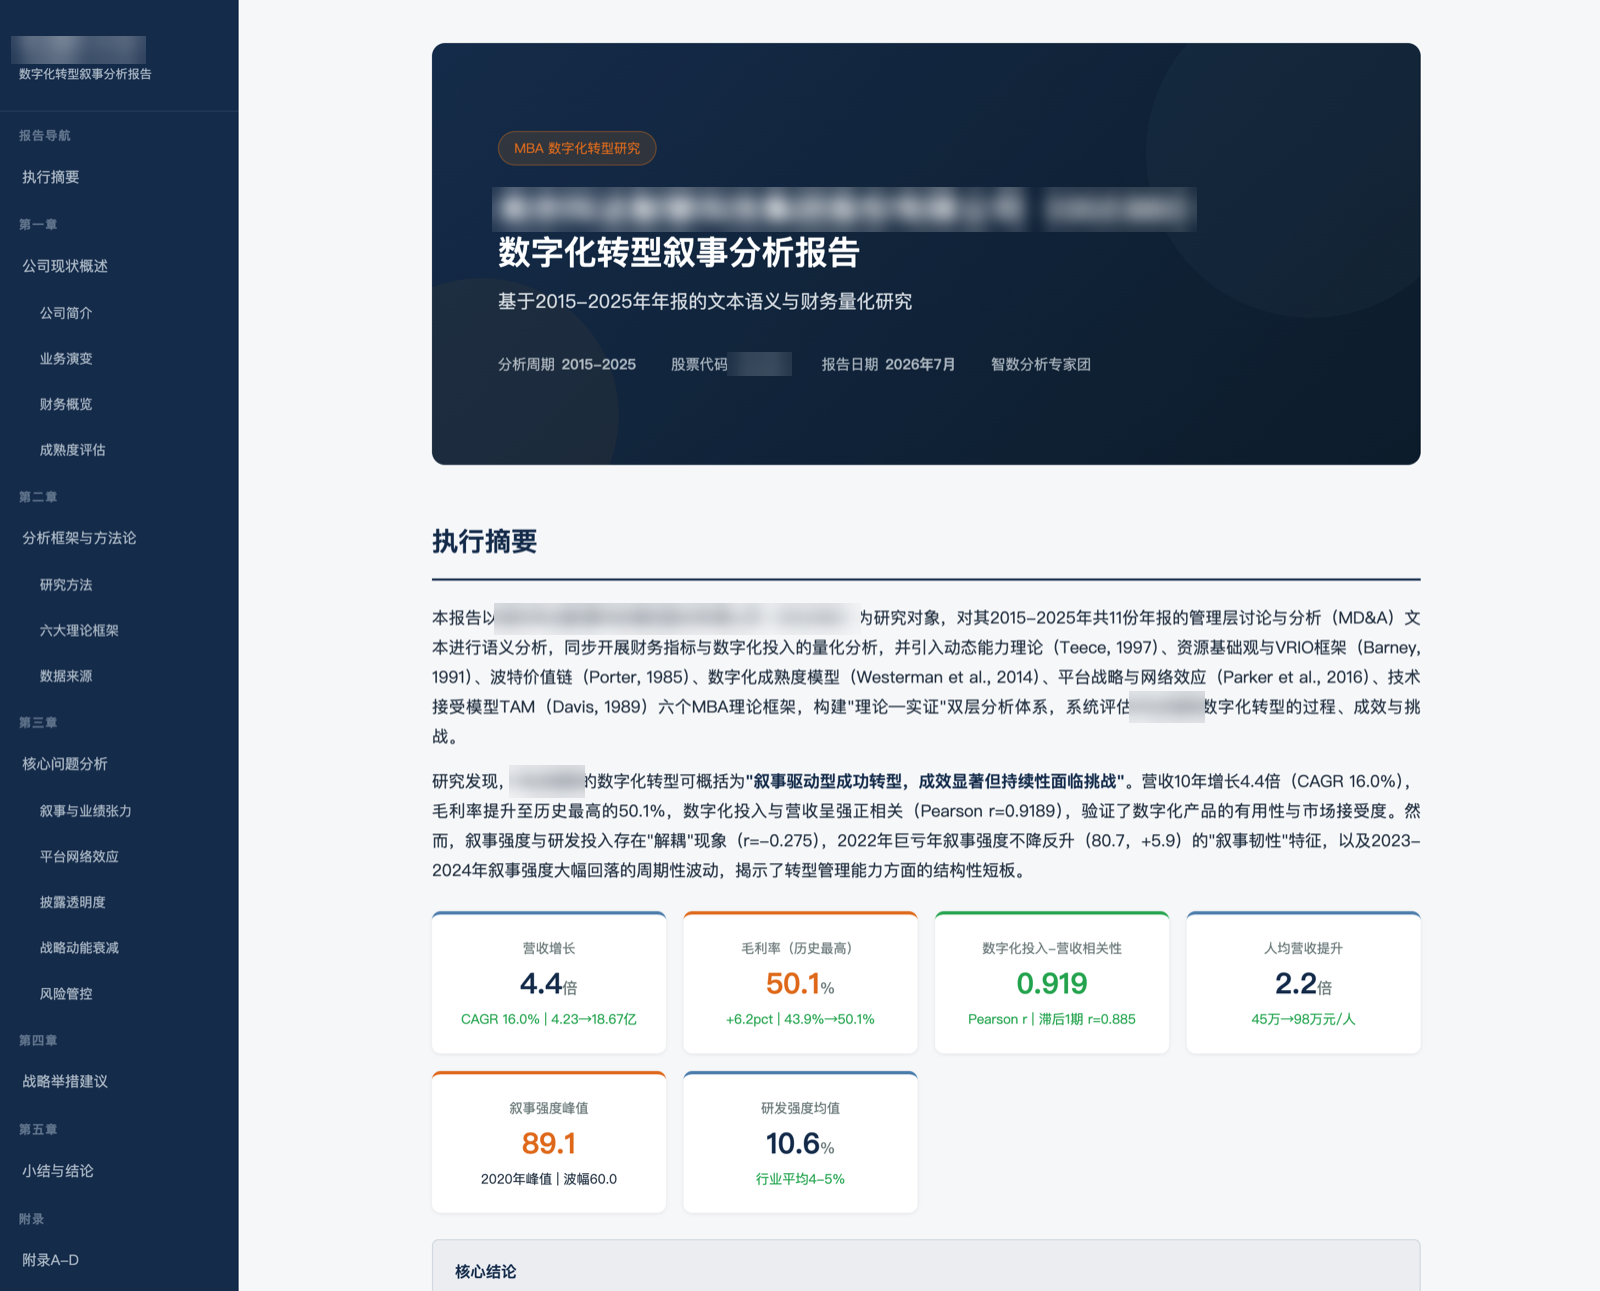
最终交付物:一份 85 KB 自包含的 HTML 咨询报告(双击离线可打开),左侧为目录导航,正文含执行摘要、五章正文与附录 A–D,内嵌 10 张图表。报告首页即给出执行摘要与六张核心指标卡:营收十年增长 4.4 倍(CAGR 16.0%)、毛利率升至历史最高的 50.1%、数字化投入与营收强相关(Pearson r=0.919)、人均营收提升 2.2 倍、叙事强度峰值 89.1、研发强度均值 10.6%。
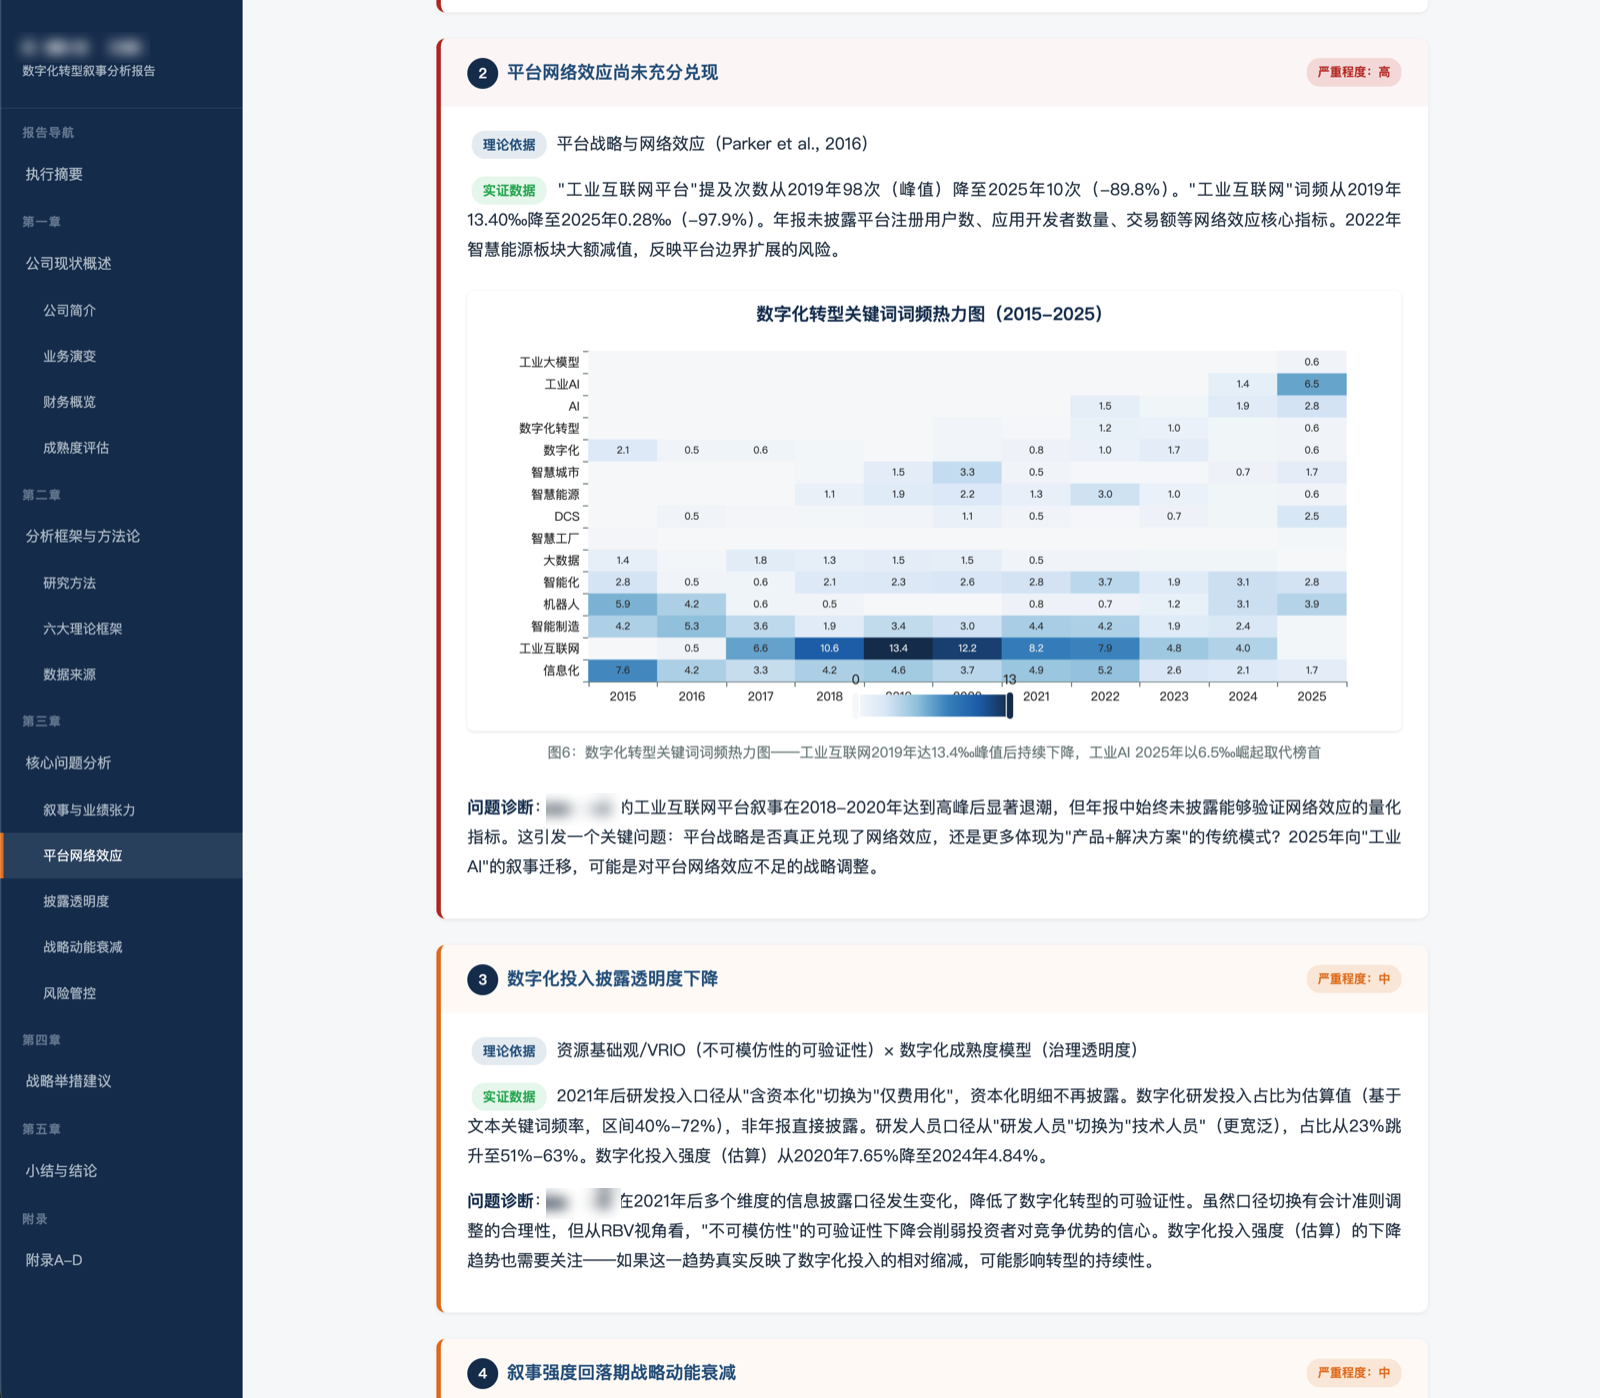
核心问题分析:第三章以「问题卡片」形式呈现五大核心问题,每张卡片标注严重程度、理论依据与实证数据。例如「平台网络效应尚未充分兑现」:以平台战略与网络效应理论(Parker et al., 2016)为依据,用「数字化转型关键词词频热力图(2015–2025)」佐证——「工业互联网」词频从 2019 年峰值持续回落,「工业 AI」于 2025 年崛起取代榜首。
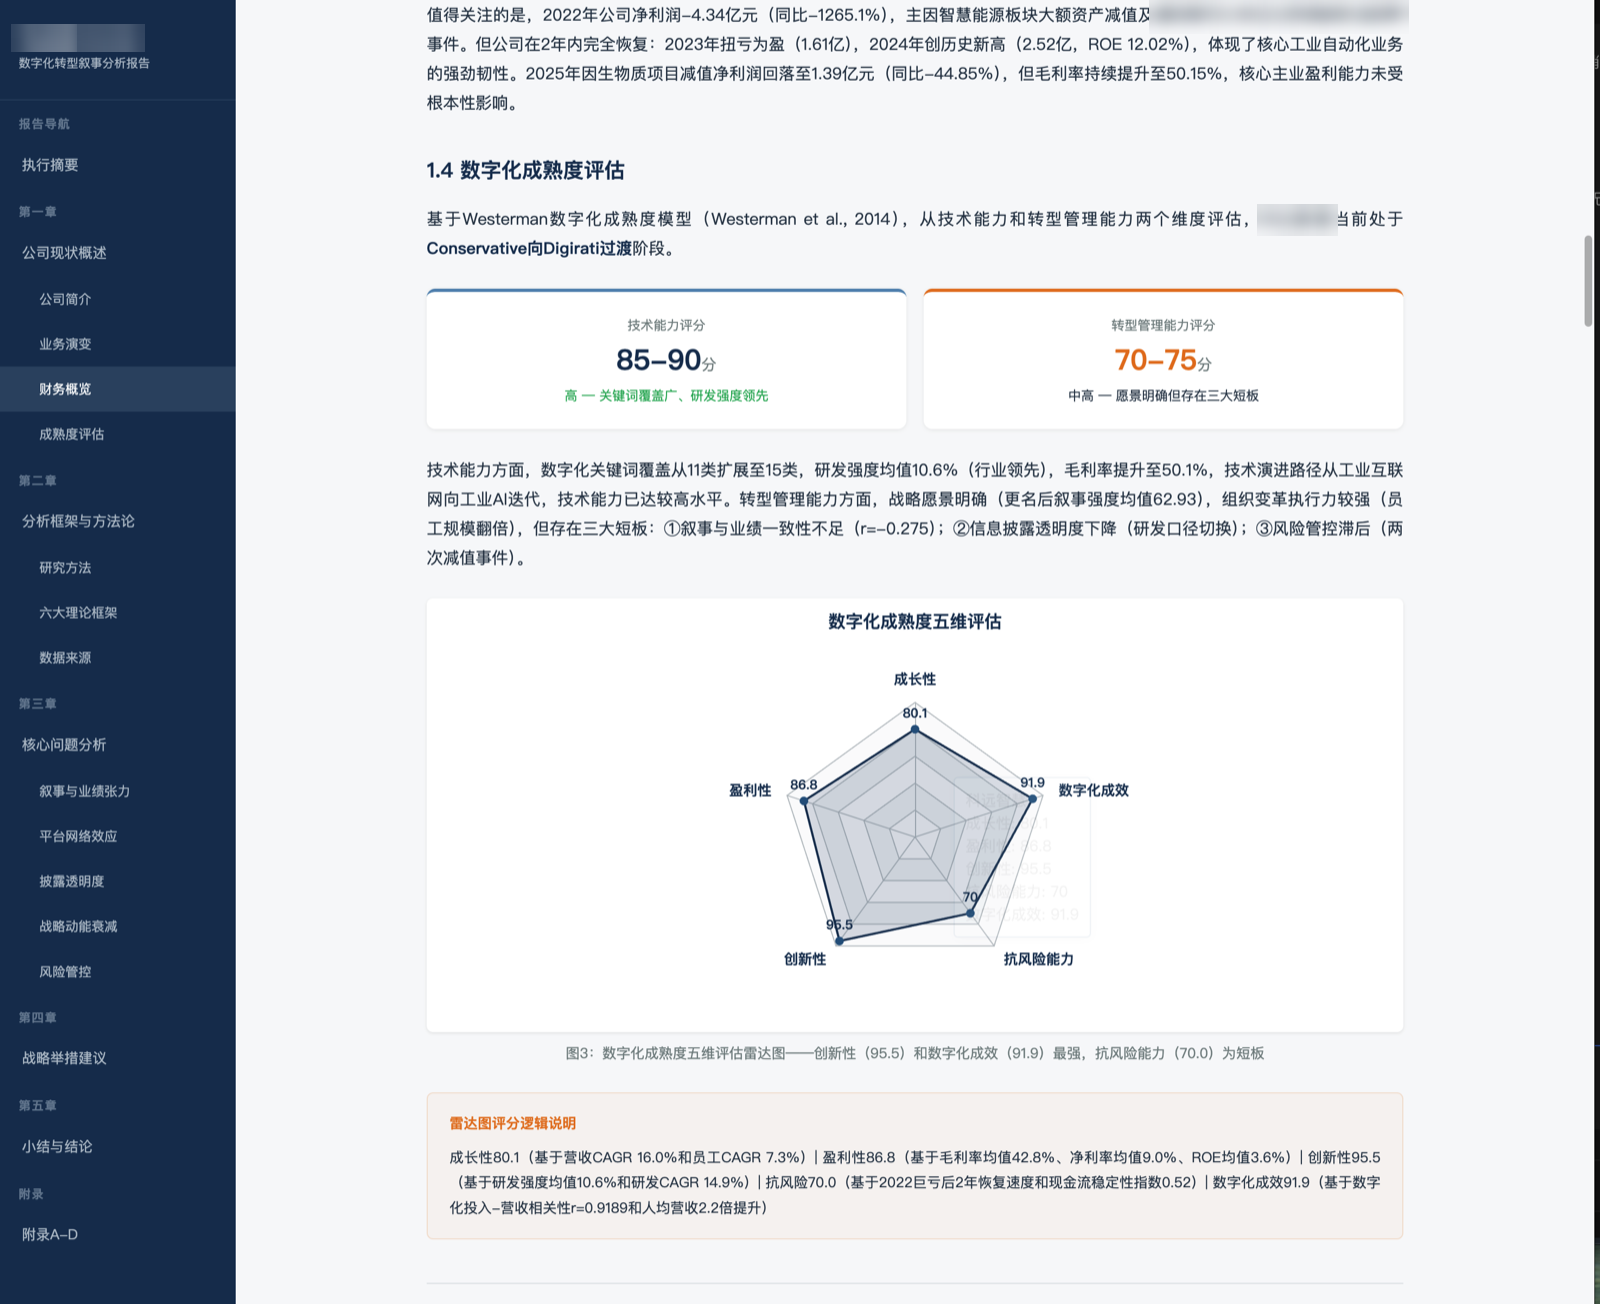
理论框架与数据结合:基于 Westerman 数字化成熟度模型,从技术能力与转型管理能力两个维度给出评分(85–90 分 / 70–75 分),并配「数字化成熟度五维评估」雷达图(成长性、数字化成效、抗风险能力、创新性、盈利性),图下附评分逻辑说明,每个分值都能对应到具体财务或文本指标。
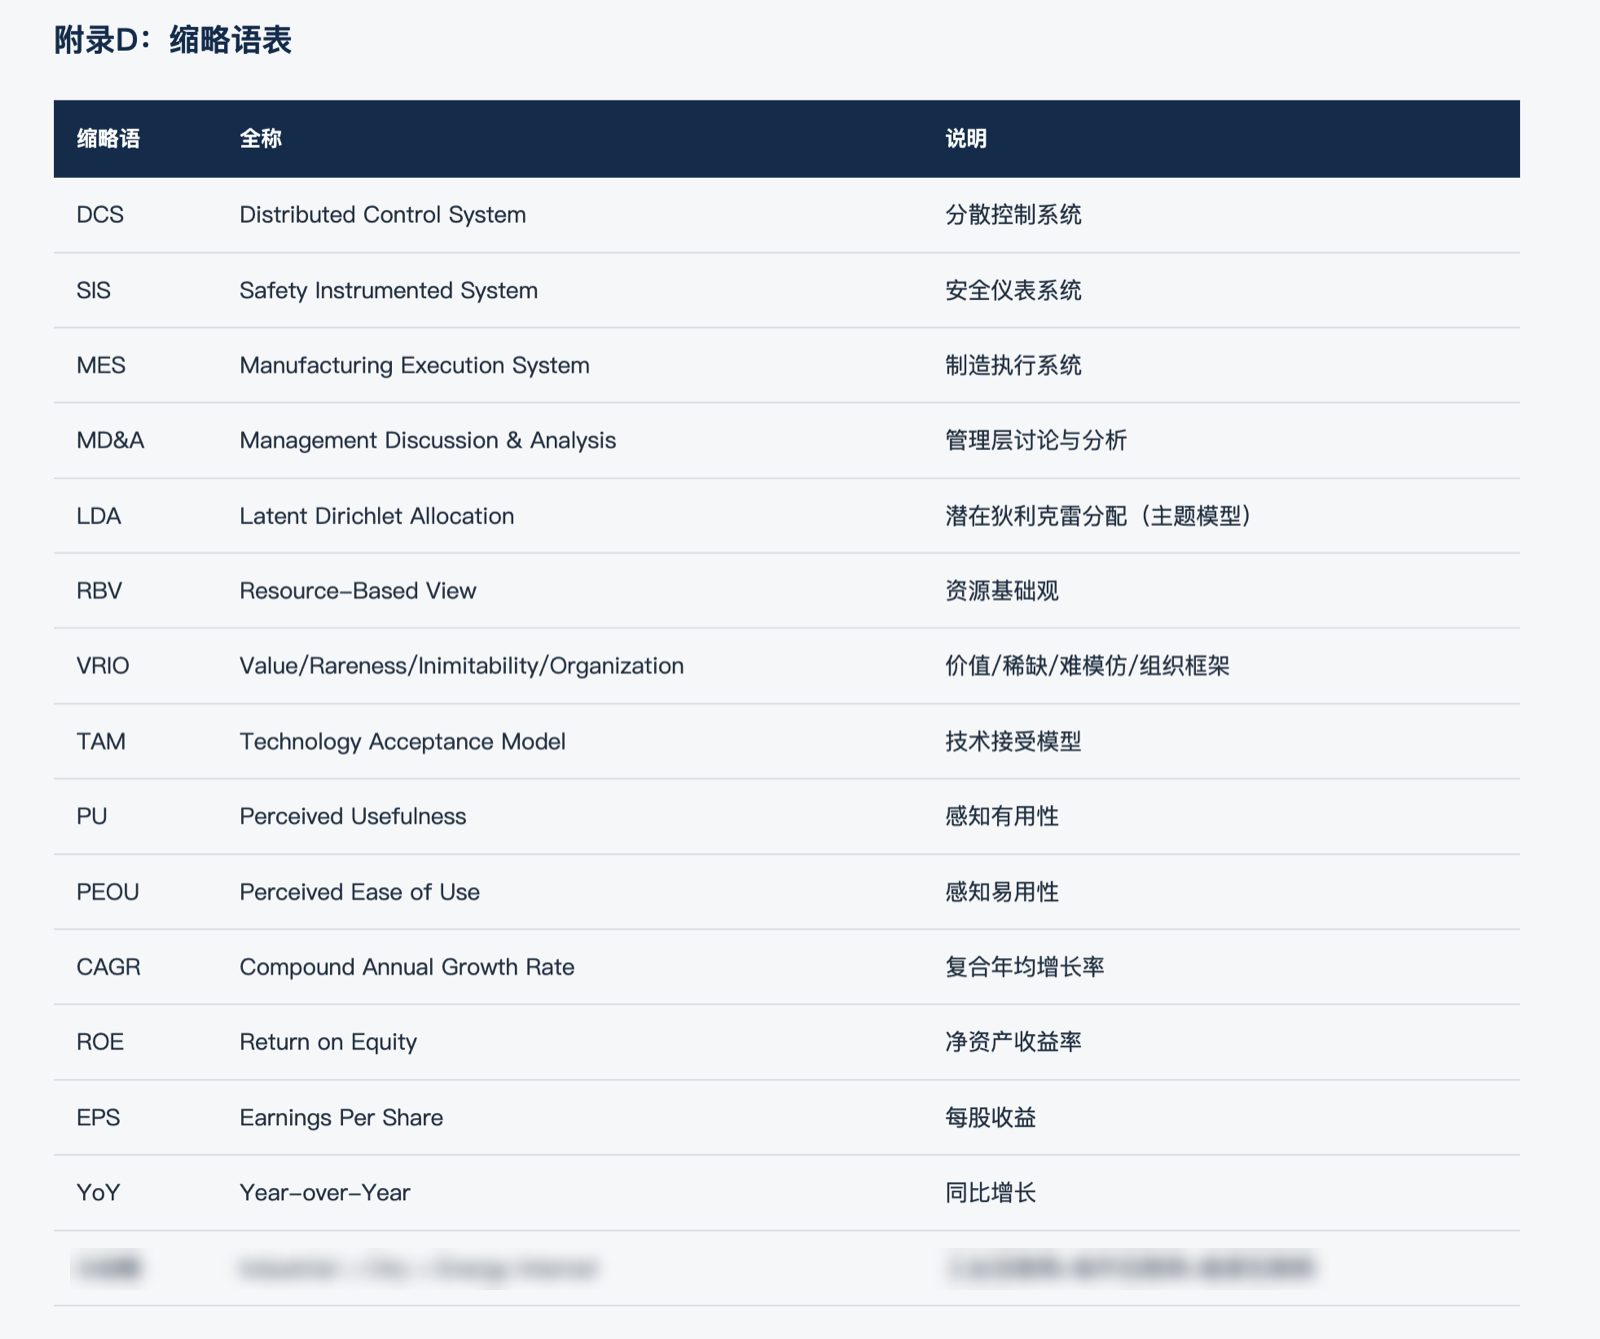
附录的专业度:报告末尾附缩略语表(DCS、MD&A、LDA、RBV、VRIO、TAM、CAGR、ROE 等逐一给出全称与释义),连同数据来源、脚本说明、口径说明共四个附录,符合咨询交付物规范。
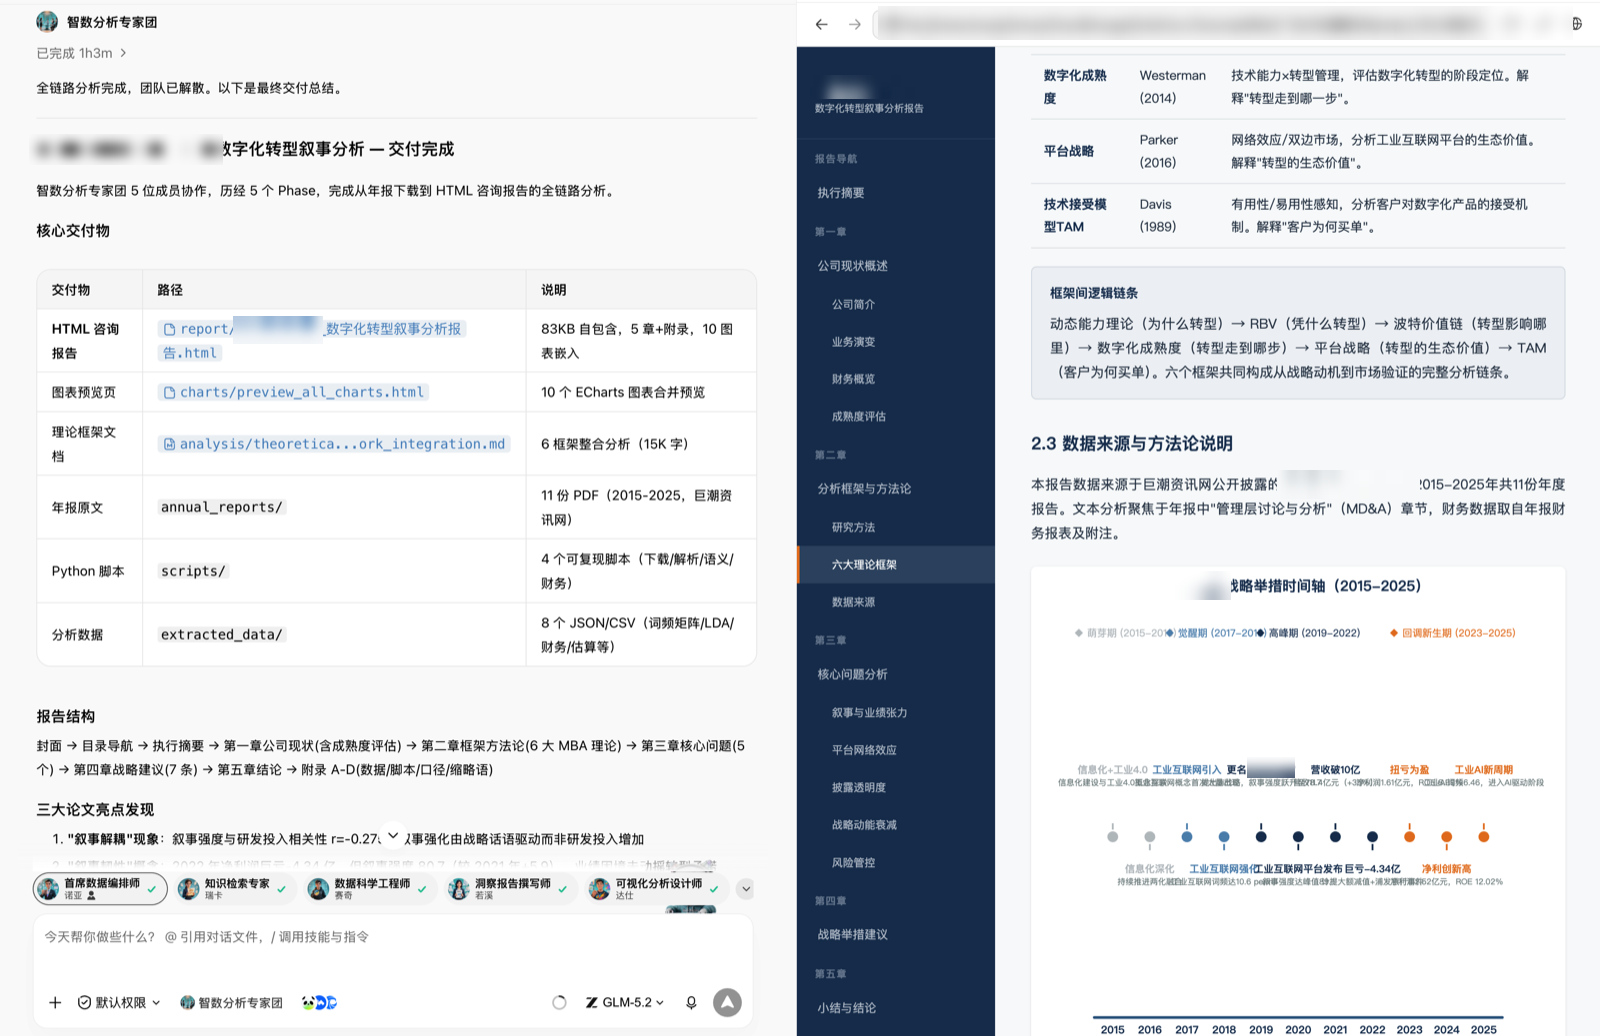
WorkBuddy 中的交付总结:专家团完成后给出交付清单——HTML 咨询报告、10 个 ECharts 图表合并预览页、六大理论框架整合分析文档(约 1.5 万字)、11 份年报原文、4 个可复现 Python 脚本、8 个中间分析数据文件(JSON/CSV),并提炼出三大论文级亮点发现,如「叙事解耦」现象(叙事强度与研发投入相关性 r=-0.275)、某亏损年度的「战略叙事韧性」(业绩大幅亏损当年叙事强度不降反升)。
📎 报告原文(已匿名化,可在线打开):company-deep-research-report.html
验收标准
- 年报齐全:
annual_reports/目录下 11 份 PDF 齐全,覆盖 2015–2025 每个年度,均来自巨潮资讯网,与该公司实际披露一一对应(注意剔除年报摘要、英文版、更正公告等干扰文件) - 脚本可复现:
scripts/下 4 个脚本(下载、解析、文本语义分析、财务分析)可独立重跑,重跑结果与extracted_data/下 8 个中间数据文件(词频矩阵、LDA 主题权重、叙事强度、财务指标等 JSON/CSV)一致 - 报告可打开:最终 HTML 报告自包含(CSS 内嵌、图表已嵌入),断网双击可打开;左侧目录导航可跳转;公司现状、分析框架与方法论、核心问题分析、战略举措建议、小结与结论五章及附录 A–D 齐全
- 数字可核对:报告中的关键数字(营收 4.23 亿→18.67 亿、CAGR 16.0%、毛利率 50.1%、Pearson r=0.9189 等)能与年报原文和
extracted_data/中间结果对账,建议人工抽查 3–5 个 - 理论落地:每个理论框架都有对应的实证数据支撑,且理论整合逻辑在
analysis/theoretical_framework_integration.md中有完整文档说明,不是报告里的一句空话
遇到的问题
- 年报 PDF 解析难度大:年报版式复杂(多栏排版、扫描件、复杂表格),直接全文抽取容易出现乱码、断行和表格错位。解决方式是按章节切分、聚焦 MD&A 等文本密集型章节做语义分析,财务数据单独走结构化提取,解析脚本中保留容错与日志。
- 巨潮资讯网下载需筛选:同一公司同一年度可能同时存在年报全文、摘要、英文版、取消/更正版等多份公告,下载脚本需要按公告类别过滤并去重;同时需控制访问频率,避免触发网站限制。
- 披露口径中途变化:2021 年后该公司研发投入口径从「含资本化」切换为「仅费用化」,资本化明细不再披露,导致部分数字化投入指标只能给出估算区间。报告中对这类口径切换做了显式标注,而不是把口径不同的数字直接连成趋势线——这一点在换公司复用时几乎必然遇到。
- 语义分析的计算量:11 年 MD&A 全文做分词、词频统计和 LDA 主题建模耗时较长,专家团将其拆为独立阶段执行,中间结果落盘(词频矩阵、主题权重矩阵 CSV),失败可断点重跑。
安全与限制
- 年报属于公开披露信息,数据来源合法合规,本案例不含任何个人隐私或企业敏感数据,可公开分享。
- 下载年报需联网访问巨潮资讯网,请控制抓取频率、仅下载分析所需文件,遵守目标网站的使用条款,不要批量爬取无关公告。
- 报告由 AI 生成,不构成投资建议;叙事强度、数字化投入估算等属于文本挖掘推导指标,并非公司官方披露口径,引用前需与年报原文核对。
- PDF 自动解析可能漏抽个别表格或数字,关键财务指标正式使用前务必人工抽查复核。
- 整套流程只读写本地工作目录;执行会在目录下生成较多中间产物(脚本、CSV、日志),归档时注意区分交付物与过程文件。
可以怎样复用
这套案例最值得带走的是研究范式,而不是某一个分析主题。商业分析人员拿到任何一家上市公司——尽职调查、竞品分析、行业研究、求职前了解目标公司、课程案例作业——凡是需要「快速建立对一家公司完整、可信、可检验认知」的场景,都可以直接套用同一条研究管线:一手信源 → 结构化解析 → 文本+数据双线交叉验证 → 理论框架组织发现 → 可复现交付。
- 换分析主题只是换「镜头」:运营分析(产能、供应链、成本结构)、销售与营销分析(渠道、客户结构、区域分布)、人力资源分析(员工结构、人均效能、薪酬与激励)、财务质量分析(现金流、偿债、减值风险)、ESG 分析——只需改写
{分析维度}和{理论框架}两处占位符,研究管线原样不动。 - 换一家公司:把泛化模板中的
{公司名称}、{股票代码}、{分析区间}换掉即可,下载脚本和分析流程原样复用;先确认目标公司在巨潮资讯网上年报齐全。 - 换一类原始素材:同模板也适用于招股说明书、ESG/可持续发展报告、业绩说明会纪要、券商研报合集,把
{数据来源}换成对应渠道即可。 - 保留「可复现」这条硬性要求:「所有中间计算以 Python 脚本保存」是全案例最有复用价值的一句提示词——它让任何结论都能被复查、被复算,是把 AI 分析从「看起来专业」变成「经得起检验」的关键,也是这套方法能被称为「研究」的原因。
- 多智能体团队适合长链路任务:凡是要「下载 → 清洗 → 分析 → 可视化 → 成稿」一气呵成的任务,交给专家团拆解执行比自己逐轮下指令更稳;其分工(检索、数据工程、分析、可视化、成稿)与人的研究团队同构,中间汇报也便于在关键节点人工确认口径。
分类:创意开发难度:入门作者:0769-zhaoxia日期:2026-08-29Skill:网站设计
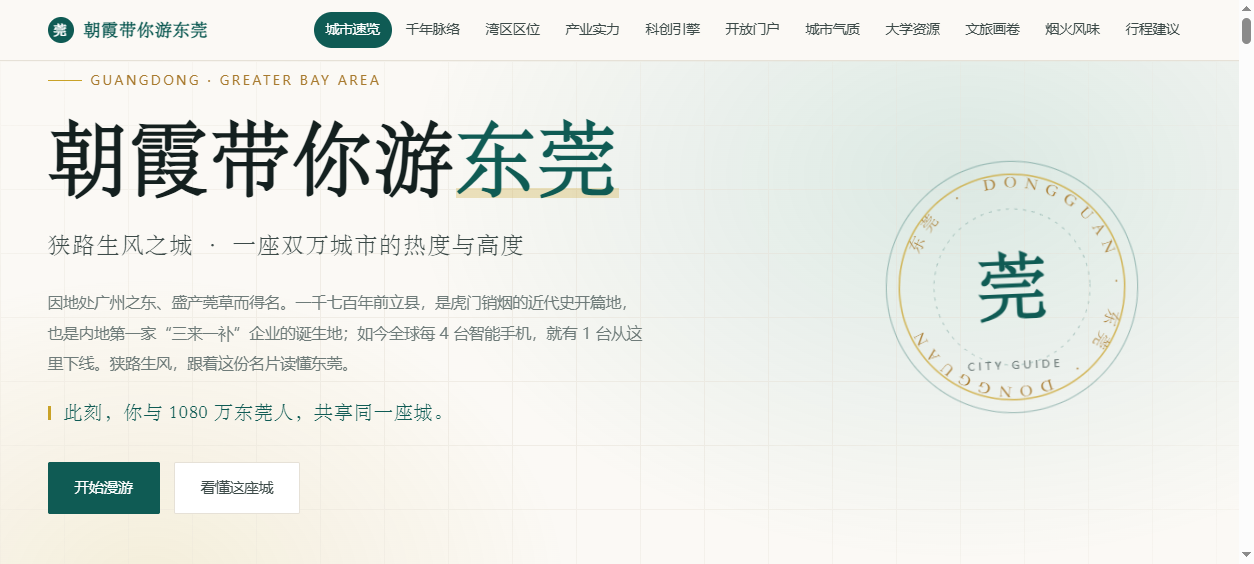
朝霞带你游东莞:一句话生成一座城市的数据驱动名片
本案例演示:如何用「网站设计」能力,把一座城市的官方资料整理成一份可交互、可换城市的单文件 HTML 城市名片。成品为「朝霞带你游东莞」,页面结构完全由数据驱动,换任何城市只需替换一个数据对象。
场景描述
做城市推介材料,通常卡在两难:做成 PPT,数据堆叠、翻页即逝;写成公众号长文,好看但拿不出手、也不好改。市面上的旅游攻略模板又大多只有"去哪玩、吃什么",撑不起招商、接待、对外宣传的场合。
一位在政府办公室工作的用户,需要一份既能讲清城市实力(GDP、外贸、产业集群、大科学装置)、又能带人逛街巷(景点、美食、行程)的城市名片,且希望它能被复用到其他城市、其他场合。
想要完成的任务
- 输入:一座城市的名称,以及它的官方资料(统计公报、政府门户介绍、文旅信息等)。
- 目标:一份单文件 HTML,零外部依赖,双击即开、可直接分享。
- 预期交付物:包含 11 个板块的可交互网页,页面文字与数据全部由页面内的一个
CITY常量对象驱动渲染。
使用的 Skill
| Skill | 用途 | 来源或安装方式 |
|---|---|---|
| 网站设计 | 生成单文件 HTML 网页,承载全部板块与动效 | WorkBuddy 内置(设计创意模式 → 网站设计) |
前置条件
- WorkBuddy 版本:5.x(需进入「设计创意」模式)
- 操作系统:Windows 10/11
- 所需账号或权限:无
- 所需输入文件:无硬性要求;建议准备该城市的官方统计公报、政府门户「走进 X 城」介绍、文旅信息,用于核对数据
在 WorkBuddy 中的操作
- 在对话框上方切换到「设计创意」模式,选择「网站设计」。
- 输入下方「提示词或任务指令」,把
{{城市}}换成目标城市名。 - 发送后,WorkBuddy 生成单文件 HTML,右侧内置浏览器自动打开预览。
- 从首屏开始逐板块检查:数字是否正常滚动、时间轴是否完整、数据是否与官方口径一致。
- 核对无误后,将 HTML 保存到本地(可直接双击打开或分享)。
提示词或任务指令
~~~text 帮我做一份「{{城市}}」的城市名片交互式网页,输出单文件 HTML,无任何外部依赖。
【一、页面结构】按顺序生成 11 个板块:
- 城市速览——8 张数据卡,覆盖行政区划、人口规模与结构、三次产业结构、人均 GDP、市场主体、创新主体、城市荣誉等基本面
- 千年脉络——垂直时间轴,用 8-11 个关键年份串起城市发展史,提炼一条贯穿全篇的叙事主线
- 区位交通——SVG 同心圆"时空圈",中心放该市主枢纽,四方标注到周边核心城市/机场的通勤分钟数
- 产业实力——产业集群卡片(用"全球每 X 台就有一台产自这里"等独家比例数据)+ 增速条形图 + 高增长产品标签
- 科创引擎——深绿渐变卡片,突出大科学装置、重点实验室、科学城数据
- 开放门户——5 项外贸外资核心数据
- 城市气质——6 张带线性图标的气质卡,亮出该市独有城市名号
- 大学资源——列出该市高校(校名 + 层次标签 + 一句话介绍)
- 文旅画卷——4 个分区 Tab 切换(老城人文 / 历史史迹 / 湖山生态 / 潮流文创),每区 4-6 个景点卡片
- 烟火风味——8-10 道地道美食,按区县标注
- 行程建议——1 日 / 2 日 / 3 日三条路线
【二、内容要求】
- 全部数据使用官方公开口径,页脚标注来源
- 页脚加一句提示:票价、开放时间等信息可能变动,出行前请核实官方渠道
- 语言风格:稳重、克制、有文化质感,避免营销腔
- 景点按片区归类,行程不要走回头路
【三、技术要求】
- 单文件 HTML,CSS 与 JS 全内联,不引用任何 CDN、字体或外部图片
- 全站内容由一个名为 CITY 的 JavaScript 常量对象驱动渲染,换城市只需替换该对象
- 必须包含:顶部滚动进度条、区块滚动渐入、数字滚动计数、条形图进入视口自动生长、导航自动高亮、回到顶部按钮
- 响应式:桌面多列网格、手机单列、导航横向滚动
【四、交付】 输出一个 .html 文件,命名为「朝霞带你游{{城市}}.html」,并打开预览确认效果。 ~~~
在 WorkBuddy 中的效果
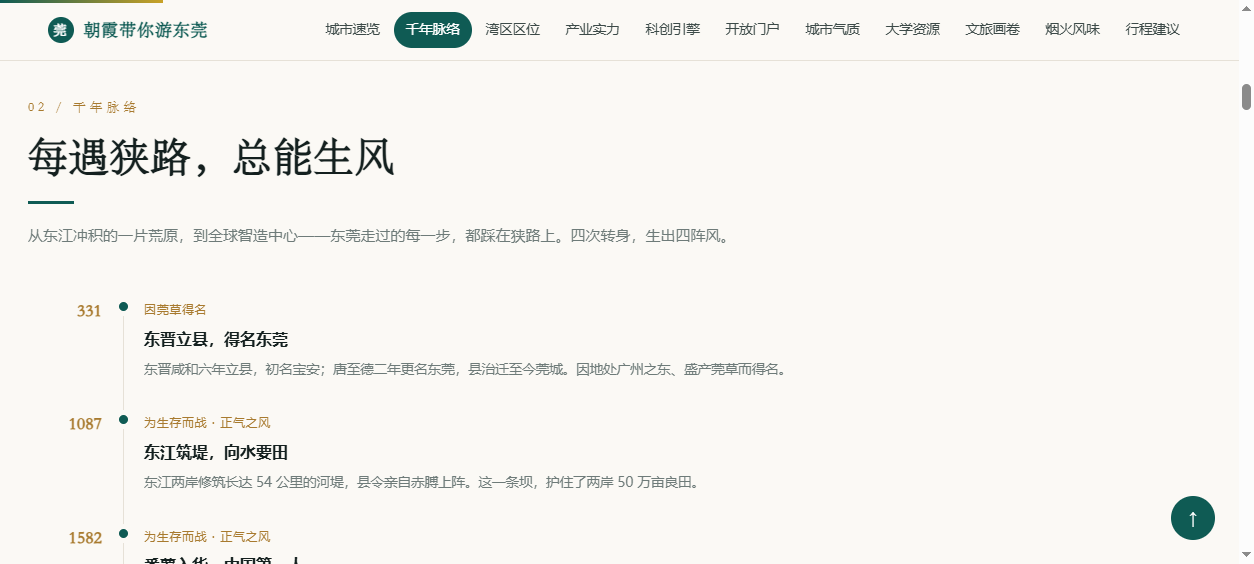
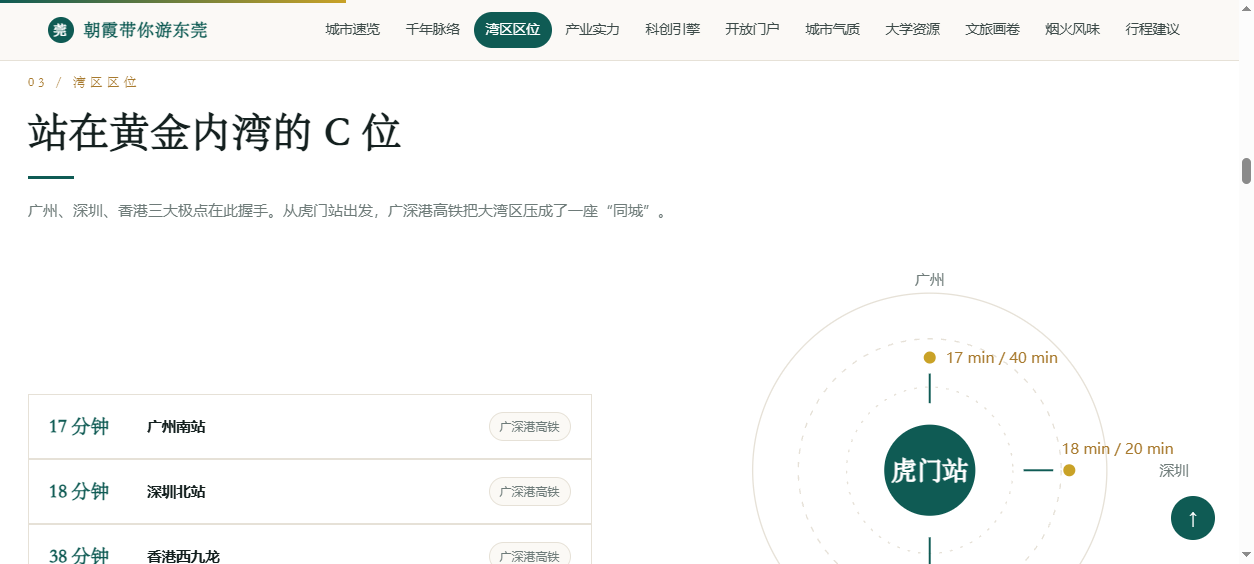
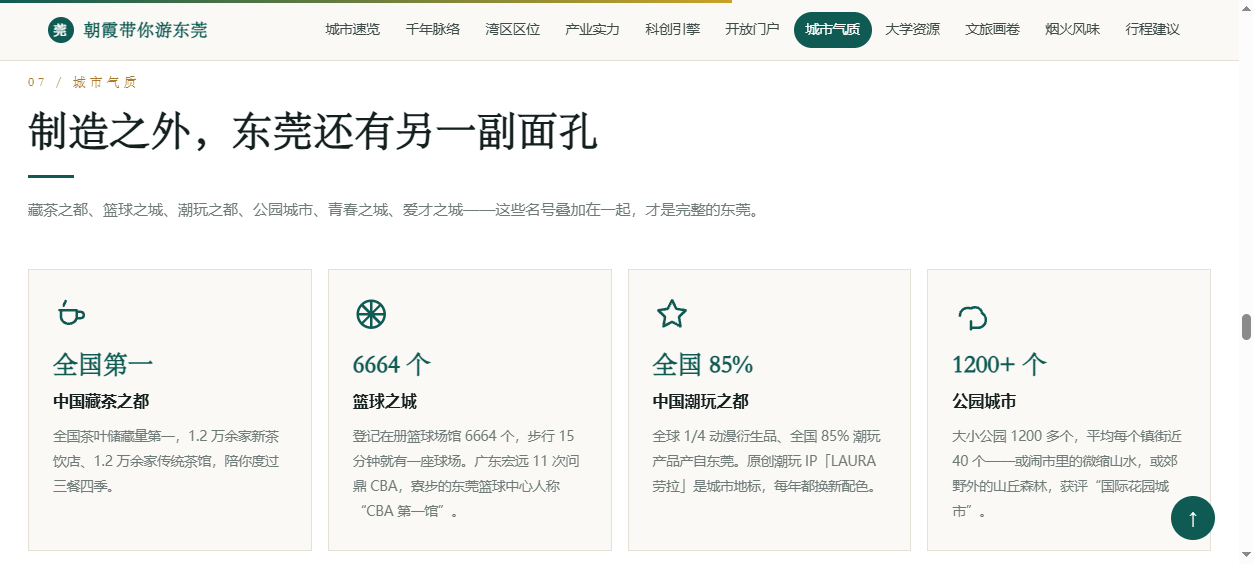
成品为「朝霞带你游东莞」,约 46 KB,零外部依赖。11 个板块从城市速览、千年脉络、湾区区位,一路走到城市气质、大学资源、文旅画卷与行程建议。
- 首屏:衬线大标题 + 旋转徽标 + 四组核心数据(GDP、人口、外贸、平均年龄)滚动计数 + 一句欢迎语
- 千年脉络:11 个时间节点的垂直时间轴,用"每遇狭路总能生风"串联发展史
- 湾区区位:SVG 同心圆时空圈,中心为虎门站,四方标注到广州、深圳、香港、机场的分钟数
- 城市气质:藏茶之都、篮球之城、潮玩之都等 6 张带线性图标的气质卡
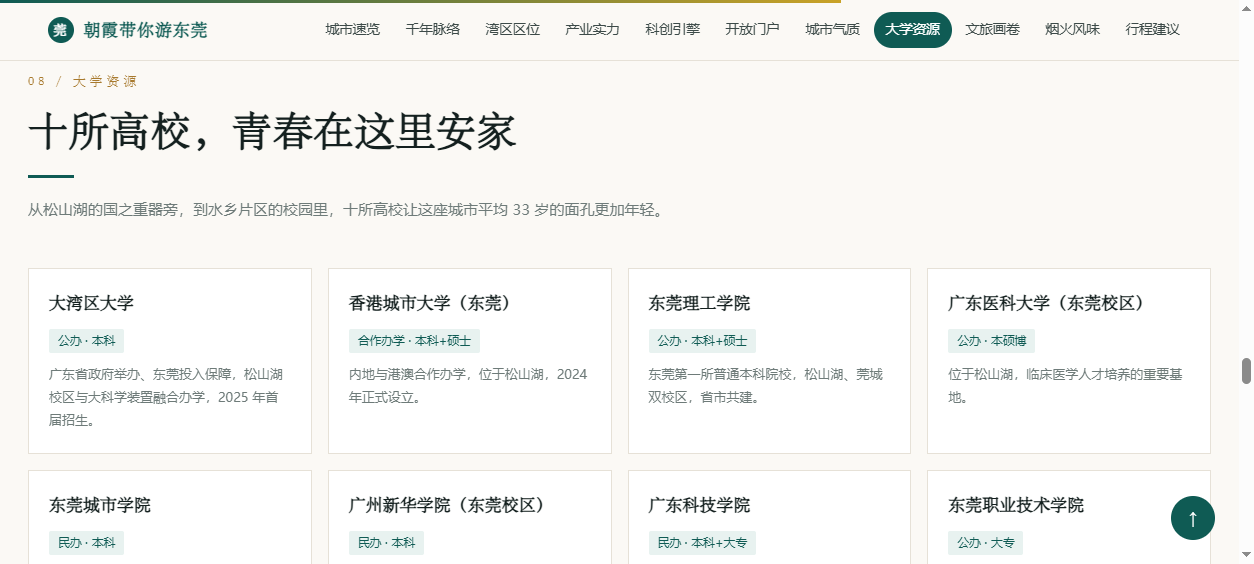
- 大学资源:10 所高校卡片
验收标准
- 页面是单文件 HTML,无任何外部资源引用(可离线双击打开)。
- 11 个板块齐全,导航可跳转、自动高亮。
- 首屏四组核心数据能正常滚动显示真实数值(不卡在 0)。
- 换城市时,只需替换
CITY对象,页面结构与动效无需改动。 - 页脚标注数据来源,并提示票价、开放时间可能变动。
- 所有数据可回溯到官方公开口径,重要数字需人工复查。
遇到的问题
- 首屏数据数字显示为 0:数字滚动动画初始绑定在下方板块上,首屏数据条不在动画触发范围内,导致数字停在初始值 0。解决:对首屏数据条单独触发一次计数动画。
- 斑马纹底色上白卡片"糊"成一片:交替区块(白底)里的白色卡片缺少对比。解决:为斑马纹区块内的卡片单独反色(白卡片换暖白底)。
- 打印时区块整体空白:区块初始
opacity:0,打印时不会触发渐入。解决:在@media print中强制opacity:1。 - 老版 WPS 资料无法直接读取:
.wps为 OLE2 二进制格式。解决:本机用 Microsoft Word 的 COM 接口打开并导出为文本后再整理。
安全与限制
- 数据必须人工复核:GDP、人口、外贸、高校名单等数字应以官方统计公报、政府门户为准;AI 可能张冠李戴,涉及对外发布前务必逐项核对。
- 景点票价与开放时间会变动:页面仅作展示参考,页脚已提示出行前核实官方渠道。
- 肖像权:投稿/公开展示的版本不放个人照片,避免他人"做同款"后复用肖像;如做个人 IP 版,请自行确认肖像使用授权。
- 不收集数据、不调用权限:页面为纯静态 HTML,无后端、无统计、无外部请求。
可以怎样复用
- 换城市:只改
CITY对象(城市名、徽标字、核心数据、时间轴、产业集群、交通时空圈、文旅分区、美食、高校、行程),11 个板块与全部动效自动适配。 - 换用途:删掉「千年脉络」或「行程建议」等板块,改成企业介绍页、产品发布会长页、活动宣传页。
- 做同款:把本案例的提示词中的
{{城市}}换成目标城市,即可一键生成对应版本。 - 配自动化:可进一步配置定时任务,让核心数据定期更新,形成城市信息的自动维护页。
分类:创意开发难度:进阶作者:JZCreative日期:2026-07-15Skill:本地文件读写Skill:本地 HTTP 服务器Skill:Git 推送与 GitHub Pages
用 WorkBuddy 生成一个 GSAP 粒子球体作品集动画网站
场景描述
年底需要做一份工作室年度作品集 Showreel。传统的做法是用 After Effects 或 Premiere 手动剪辑,但这类工具对动效交互和 3D 视觉的迭代成本很高——每次调整缓动曲线或粒子参数都要重新渲染。
我希望换一种方式:用 GSAP + 软件 3D 投影做一个纯前端动画,300 个粒子聚拢成球体,6 个节点代表 6 组作品,点击节点后镜头聚焦、标题浮出、作品视频展开。整个过程在浏览器里实时运行,可以随时调整参数立即看到效果。
但手写这个动画的 3D 数学、粒子分布、时间线编排和 Mockup 布局非常耗时。所以我把它交给 WorkBuddy,用自然语言描述需求,让它逐步生成并迭代。
想要完成的任务
- 输入:一份 6 场景脚本(含标题、副标题、作品名、链接),27 个本地媒体文件(MP4/MOV 视频 + 截图)
- 目标:一个自包含 HTML 文件 + 本地媒体,在浏览器中实时播放粒子球体 Showreel 动画
- 交付物:
- 可在浏览器中预览的 HTML 动画
- 推送到 GitHub 仓库并通过 GitHub Pages 在线访问
前置条件
- WorkBuddy 版本:支持本地文件读写和 Bash 执行的版本
- 操作系统:macOS(Windows/Linux 同样适用,路径稍作调整)
- 所需账号或权限:GitHub 账号,已配置 SSH key 或 personal access token
- 所需输入文件:27 个媒体文件放在本地文件夹,一份脚本文本
使用的 Skill
本次任务没有安装额外的 Skill,全程使用 WorkBuddy 的内置能力:
| 能力 | 用途 | 来源或安装方式 |
|---|---|---|
| 本地文件读写 | 读取素材文件、写入生成的 HTML | WorkBuddy 内置 |
| Bash 执行 | 启动 HTTP 服务器、检查视频尺寸、Git 操作 | WorkBuddy 内置 |
| 网页预览 | 在浏览器中实时预览动画效果 | WorkBuddy 内置 |
| GSAP CDN 引用 | 通过 <script> 标签引入 GSAP 3.12.5 | 外部 CDN(cdnjs) |
在 WorkBuddy 中的操作
第一步:描述需求并提供素材路径
我把脚本和素材路径发给 WorkBuddy:
我准备设计一个工作室作品集动画视频,标题是「JZ Creative Studio 2025 Showreel」。
要求:浅色背景 + 点线 MG 设计,开场形成一个基于 GSAP 的大型粒子球体,
球面上有节点代表作品组,聚焦节点后弹出作品视频。

脚本:
场景1 - SVG 交互设计(蕉内 / 香奈儿 / 喜茶)
场景2 - H5 互动页面(中国新闻网 / 互动叙事H5)
场景3 - Vibe Coding(在线技能五子棋)
场景4 - AIGC 创意设计(数据可视化 / 航天科普 / 政务漫画)
场景5 - AI 创新方法论(编程式快闪 / 音乐Remix / SVG融合)
场景6 - 复旦百廿·母校礼赞(复旦120周年专题)

素材都在本地文件夹:/Users/yaoyao/Documents/Marshall工作文档/运营/Showreel/2025
WorkBuddy 读取了素材目录,生成了第一版 HTML,并启动了本地 HTTP 服务器让我预览。
第二步:迭代调整视觉与动画
第一版出来后,我开始逐轮反馈。以下是关键的迭代节点:
第 2-3 轮:颜色太多 → 改为 Apple 黑白灰(#1D1D1F / #86868B / #F5F5F7);只有开场没有转场 → 补全 6 个场景的完整流程。
第 4-5 轮:节点用 CSS 3D Transform 会随球体翻转被压扁 → 放弃 CSS 3D,改为纯 JS 软件 3D 投影(手动旋转矩阵 + 透视投影),节点用 2D translate() 定位,只同步位置不翻转。
第 6-7 轮:节点视觉上在球体之外 → 使用 Fibonacci 球面粒子索引直接替换对应位置的粒子,确保节点在球面上;增加坐标轴、大圆参考线、倾斜轨道、粒子间虚线连接等装饰。
第 8-9 轮:Mockup 风格不统一 → 统一为浏览器窗口线框风格(标题栏 + 圆点 + URL + 内容区);通过 sips 命令检查所有截图实际像素尺寸,修正竖版/横版比例。
第 10-11 轮:作品展示面积太小 → 放大 Mockup 尺寸并增加漂浮动画;标题从节点位置浮出,带连接线和持续漂浮。
第 12 轮:页面空白打不开 → JS 语法错误(},0}) 漏了一个 }),修复后正常。
第 13-14 轮:动画太快 → 全局减速 1.5-2 倍,缓动改用 power4.inOut / back.out(1.2);五子棋视频被裁切 → Mockup 内容区比例精确匹配视频比例(780×528 对应 1.560)。
第 15-16 轮:节点进入球体内部 → 投影坐标乘以 0.82 使节点视觉上嵌入球面;结尾 LOGO 替换为水墨头像 PNG;字体改为阿里巴巴普惠体 2.0。
第 17 轮:放大动画不显示 → 发现 GSAP timeline 中退出和新场景的 camS tween 各自创建独立临时对象,导致起始值=终值无渐变 → 改为共享同一对象修复。
第三步:推送到 GitHub 并启用 Pages
把这个项目和关联资产都推到我的 GitHub 仓库:
https://github.com/JZCreative/2025showreel
WorkBuddy 自动完成了:
- 创建
.gitignore(排除 node_modules、构建产物) git init+git add+git commitgit push(414MB 媒体文件,约 4 分钟上传完成)- 通过 GitHub API 启用 Pages
- 创建
index.html重定向页面
提示词或任务指令
以下是经过脱敏、可以复用的核心任务指令:
设计一个工作室作品集动画,要求:
- 浅色背景 + 点线 MG 设计风格
- 开场:GSAP 驱动的 3D 粒子球体(300 个粒子,Fibonacci 分布)
- 球面上 6 个节点代表 6 组作品
- 聚焦节点:球体旋转 → 镜头缩放 → 节点放大 → 标题浮出 → Mockup 展开
- 颜色:Apple 黑白灰(#1D1D1F / #86868B / #F5F5F7)
- 字体:阿里巴巴普惠体 2.0
- 键盘控制:Space 播放暂停 / ← → 切换场景 / Esc 跳结尾
- 结尾:粒子消散,水墨头像淡入

素材路径:[本地文件夹路径]
迭代阶段的典型反馈指令:
节点看起来还是在粒子球之外,让它们进入球体内部;
五子棋视频被裁切了,调整 Mockup 比例匹配视频;
动画整体太快,慢一些更丝滑;
结尾 LOGO 替换为这个 PNG。
在 WorkBuddy 中的效果
最终交付物:
- 主文件:
showreel-preview.html(约 33KB,自包含 HTML + CSS + JS) - 媒体资产:
public/works/下 27 个文件(13 视频 + 14 截图) - 在线预览:https://jzcreative.github.io/2025showreel/
- GitHub 仓库:https://github.com/JZCreative/2025showreel
动画效果概述:
300 个粒子聚拢成球体,带坐标轴、大圆参考线和粒子间虚线连接。
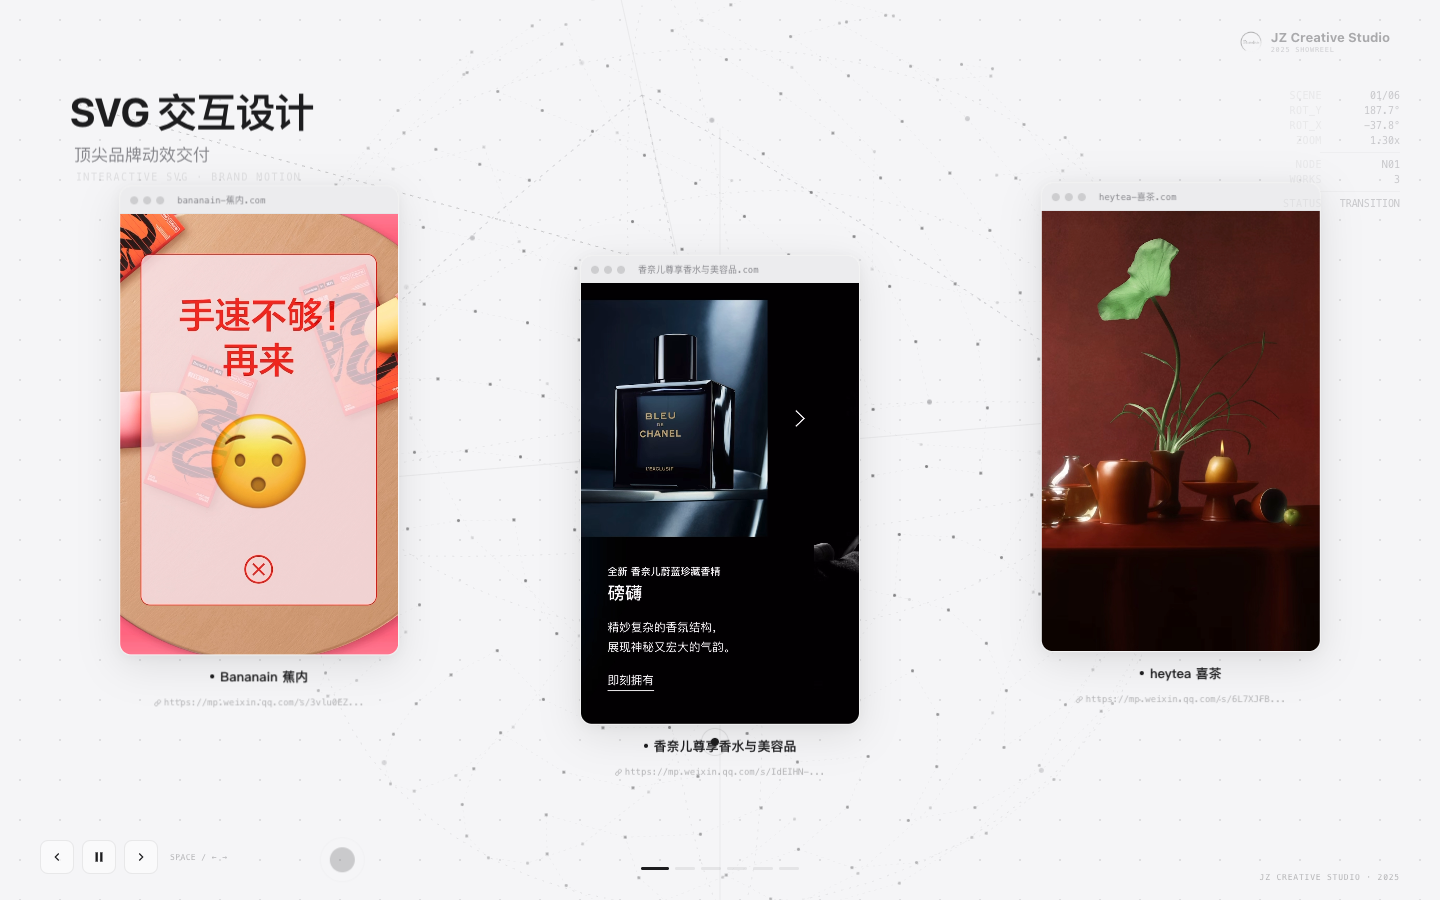
聚焦节点后,标题从节点浮出,Mockup 浏览器窗口沿分支线展开,右上角信息面板实时显示旋转数据。
- 300 个粒子从随机散开位置聚拢成球体(3 秒,
power4.out) - 球体缓慢自转,带坐标轴、大圆参考线、粒子间虚线连接
- 点击节点或按
→切换场景:球体旋转将目标节点转到正面(1.8 秒,power4.inOut) - 镜头缩放至 1.3x,节点放大 1.8x(
back.out(1.2)回弹) - 标题从节点位置浮出到左上角,带贝塞尔曲线连接线
- Mockup 浏览器窗口沿分支线展开,持续 sine.inOut 漂浮
- 右上角信息面板实时显示旋转角度、缩放倍率、当前节点
验收标准
- [x] 浏览器中打开能正常播放 6 个场景的完整动画
- [x] 粒子球体旋转流畅,节点在球面内部
- [x] 每个场景的视频比例正确,无裁切
- [x] 键盘控制(Space / ← → / Esc)正常响应
- [x] 播放到结尾后不自动循环
- [x] 字体为阿里巴巴普惠体 2.0
- [x] 结尾显示水墨头像
- [x] GitHub Pages 在线可访问
- [x] README 包含项目说明和使用方式
遇到的问题
CSS 3D Transform 导致节点压扁
问题:节点作为 3D-transformed div 在球体旋转时被透视压扁变形。
解决:完全放弃 CSS 3D Transform,改为纯 JS 软件 3D 投影。手动计算旋转矩阵(Y 轴旋转 → X 轴旋转 → 透视投影),节点用 2D translate(x, y) 定位,只同步位置不参与 3D 翻转。
性能卡顿(69000 次 DOM 更新/帧)
问题:260 个粒子各自绑定 onUpdate: apply() 回调,每帧触发 260 次完整 DOM 更新。
解决:改用 gsap.ticker.add(formTick) 单帧回调,每帧只调用一次 apply() 统一更新所有粒子和装饰元素。
放大动画瞬间跳变
问题:退出旧场景和新场景的 camS tween 各自创建临时对象 {s: camS},timeline 创建时 camS=1.3,新场景 tween 从 1.3→1.3 无渐变。
解决:在 goScene() 开头创建共享对象 const camObj = {s: camS},退出和新场景的 tween 都操作同一对象,退出 tween 先把值归 1,新场景 tween 再从 1 渐变到 1.3。
GitHub 大文件警告
问题:s2w1.mov(67MB)超过 GitHub 建议的 50MB 上限。
解决:文件仍在 100MB 硬限制内,推送成功。GitHub 发出警告但未阻止。如果后续需要更大文件,可考虑 Git LFS。
安全与限制
- 本地文件访问:WorkBuddy 需要读取本地素材文件夹,确保路径正确且文件无敏感信息。
- GitHub 推送:推送前确认
.gitignore排除了node_modules、构建产物和.workbuddy工作区数据。 - GitHub API:启用 Pages 需要 personal access token,不要将 token 提交到仓库。
- 媒体版权:确保推送的视频和截图拥有发布权限,本项目中的作品均为自有内容。
- 在线预览:GitHub Pages 为公开访问,确认内容可以公开展示。
可以怎样复用
这个案例的方法可以迁移到多种场景:
- 替换内容:把脚本和素材换成自己的作品集,即可生成个人 Showreel。
- 调整视觉:修改
--fd/--fb/--fmCSS 变量切换字体,修改--bg/--ink/--soft切换配色。 - 增减场景:在
SCENES数组中增删条目,调整NIDX节点索引即可。 - 换 3D 效果:修改
project()函数的投影参数或genSphere()的分布算法,可以产生不同的球体形态。 - 迁移到其他框架:核心的 3D 投影逻辑是纯 JS,可以移植到 React/Vue 组件中。
关键经验:
- 先描述效果,再描述实现:告诉 WorkBuddy 你想要什么视觉效果,而不是直接指定技术方案。它会在尝试中找到最优解(比如从 CSS 3D 到软件投影的转变)。
- 一轮一个反馈点:每次只反馈一个最突出的问题,避免同时改太多导致难以定位。
- 用
sips/ffprobe验证事实:涉及像素尺寸、视频比例等客观参数时,用命令行工具获取实际值,而不是凭目测。 - 共享对象避免 tween 状态丢失:GSAP timeline 中多个 tween 操作同一变量时,必须使用共享对象而非各自创建临时对象。
分类:知识管理难度:进阶作者:nikola日期:2026-07-14Skill:ima 知识库连接器
告别微信收藏夹吃灰:用 ima + WorkBuddy 把碎片内容构建成可生长的知识体系
场景描述
微信是大多数人日常信息摄入的最大入口——公众号文章、群聊讨论、朋友分享的图片和链接,每天大量的好内容从眼前流过。
但问题是:收藏了一百篇文章,就再也没打开过;截图存了一堆,想用的时候翻不到;知识是零碎的,散落在聊天记录和收藏夹里,从来没有被真正消化成自己的东西。
我自己就是这样。微信收藏夹里堆了几百条内容,但真正回头看过的不到十分之一。后来我试了 ima 知识库——把微信内容直接转发进去,确实比收藏夹好用,能搜索、能归类。但光存不够,我还想把这些碎片内容串起来,形成一个有结构、能持续生长的知识体系。
这时候 WorkBuddy 的 ima 连接器就成了关键拼图:ima 负责存,WorkBuddy 负责加工和重组。
两种用法:轻量 vs 深度
| 方案 | 适合谁 | 能做什么 | 不能做什么 |
|---|---|---|---|
| 只用 ima | 轻度用户 | 存微信内容、偶尔搜索问答 | 内容仍是碎片,难以形成体系 |
| ima + WorkBuddy | 想构建知识体系的人 | 存 + 加工 + 结构化 + 持续生长 | 需要额外配置连接器 |
让我一句最直接、最不绕弯子的话来总结ima+workbuddy的优势是:WorkBuddy可直接把整个知识库或单文件作为上下文,进行加工处理,生成的内容可一键回传ima,形成闭环,把零碎微信内容系统化构建成可复用的知识体系,而非仅在ima中进行简单的知识问答。
朋友,这么讲你应该就能理解其中的妙处了吧(很棒,朋友,哈哈哈~)。
如果你只是想找个比微信收藏夹更好用的地方存东西、偶尔搜一下,ima 单独用就够了。如果你想把这些碎片真正内化、变成可复用的知识资产,接着往下看。
想要完成的任务
- 将微信中的文字、图片、公众号文章等内容存入 ima 知识库。
- 在 WorkBuddy 中连接 ima 知识库,将知识库内容作为 AI 对话的上下文。
- 让 WorkBuddy 按你指定的知识领域,把零碎内容梳理成有结构的知识体系(如分类框架、主题汇总、知识地图)。
- 将 WorkBuddy 生成的结构化成果回传到 ima,形成「收集 → 加工 → 沉淀」的闭环。
- 后续有新的微信内容时,可以持续追加并重新梳理。
使用的 Skill 与连接器
| 工具 | 用途 | 来源或安装方式 |
|---|---|---|
| ima 知识库连接器 | 连接 ima 知识库,让 WorkBuddy 读取和操作知识库内容 | WorkBuddy 内置连接器市场,直接添加 |
| ima 知识库(客户端) | 接收微信内容,提供存储和基础管理 | 腾讯 ima 官方客户端 |
ima 知识库连接器是 WorkBuddy 与 ima 之间的桥梁——WorkBuddy 可以读取整个知识库或单个文档作为对话上下文,也能把处理结果写回 ima。
前置条件
- WorkBuddy 可以正常使用。
- 已安装腾讯 ima 客户端(PC 或 Mac)/小程序也行,并创建了知识库。
- 已掌握把微信内容转发到 ima 的方法(微信内长按 → 转发 → 选择 ima)。
- 在 WorkBuddy 中已添加并授权 ima 知识库连接器。
在 WorkBuddy 中的操作
第一步:把微信内容存入 ima
这是日常动作,不需要 WorkBuddy。微信里看到任何有价值的内容:
- 公众号文章:打开文章 → 右上角「...」→ 用小程序打开 → 选择 ima
- 图片/截图:长按图片 → 用小程序打开 → 选择 ima
日积月累,你的 ima 知识库里就有了原始素材。 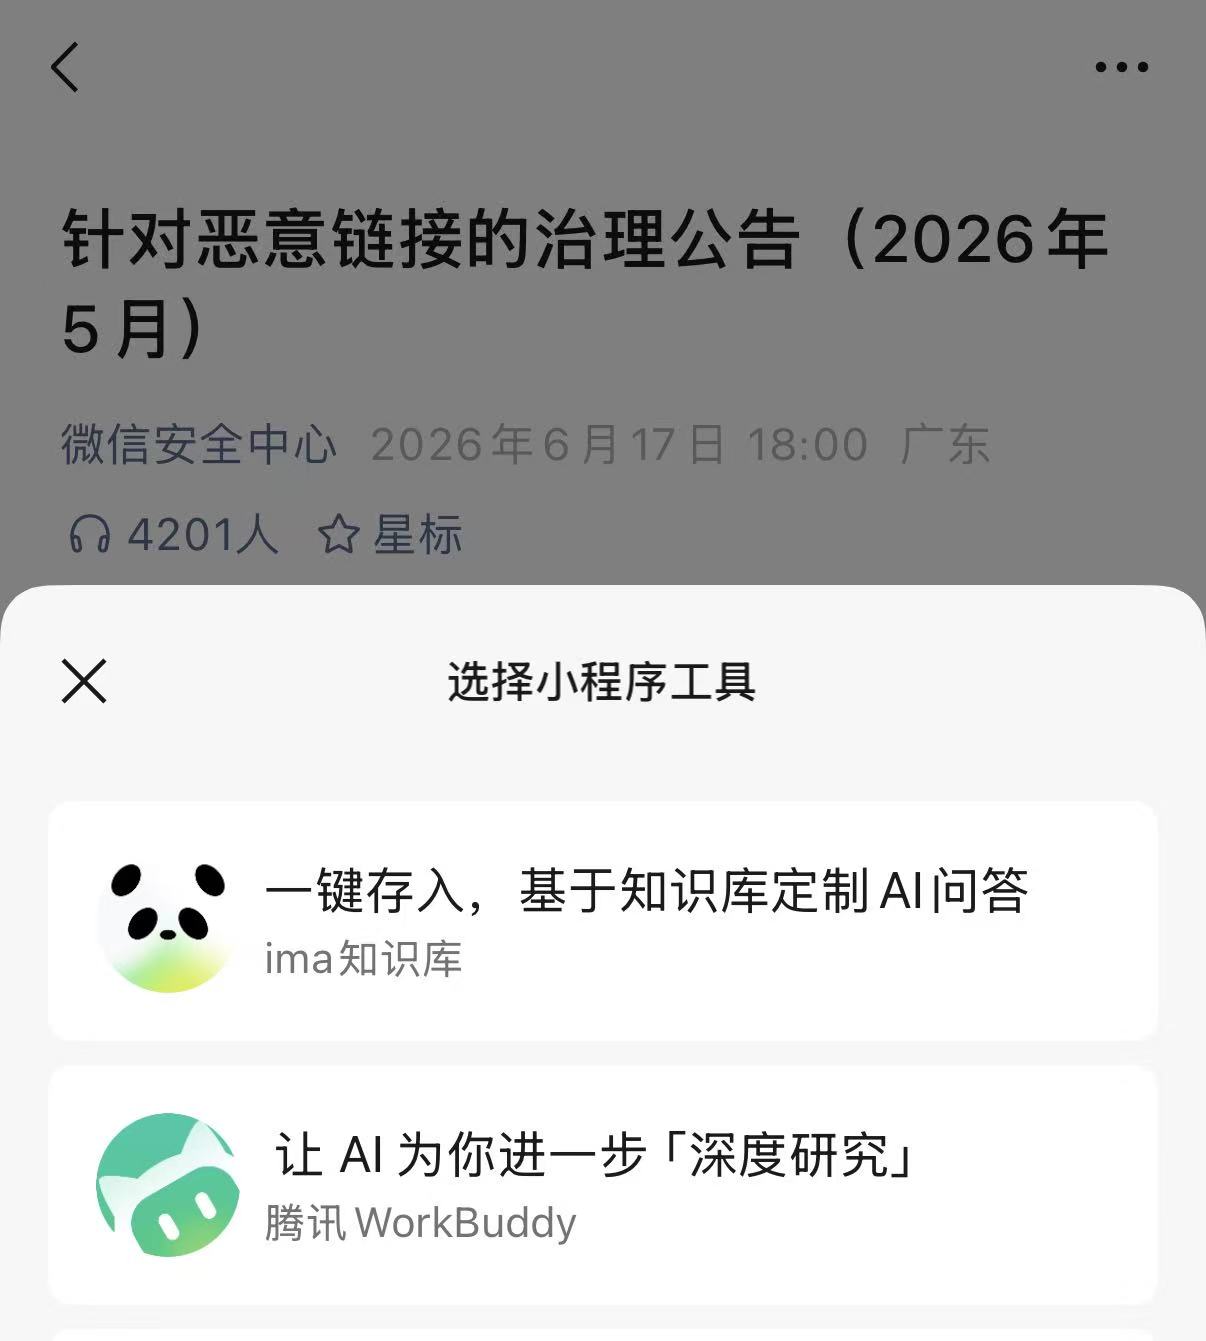
第二步:在 WorkBuddy 中添加 ima 连接器
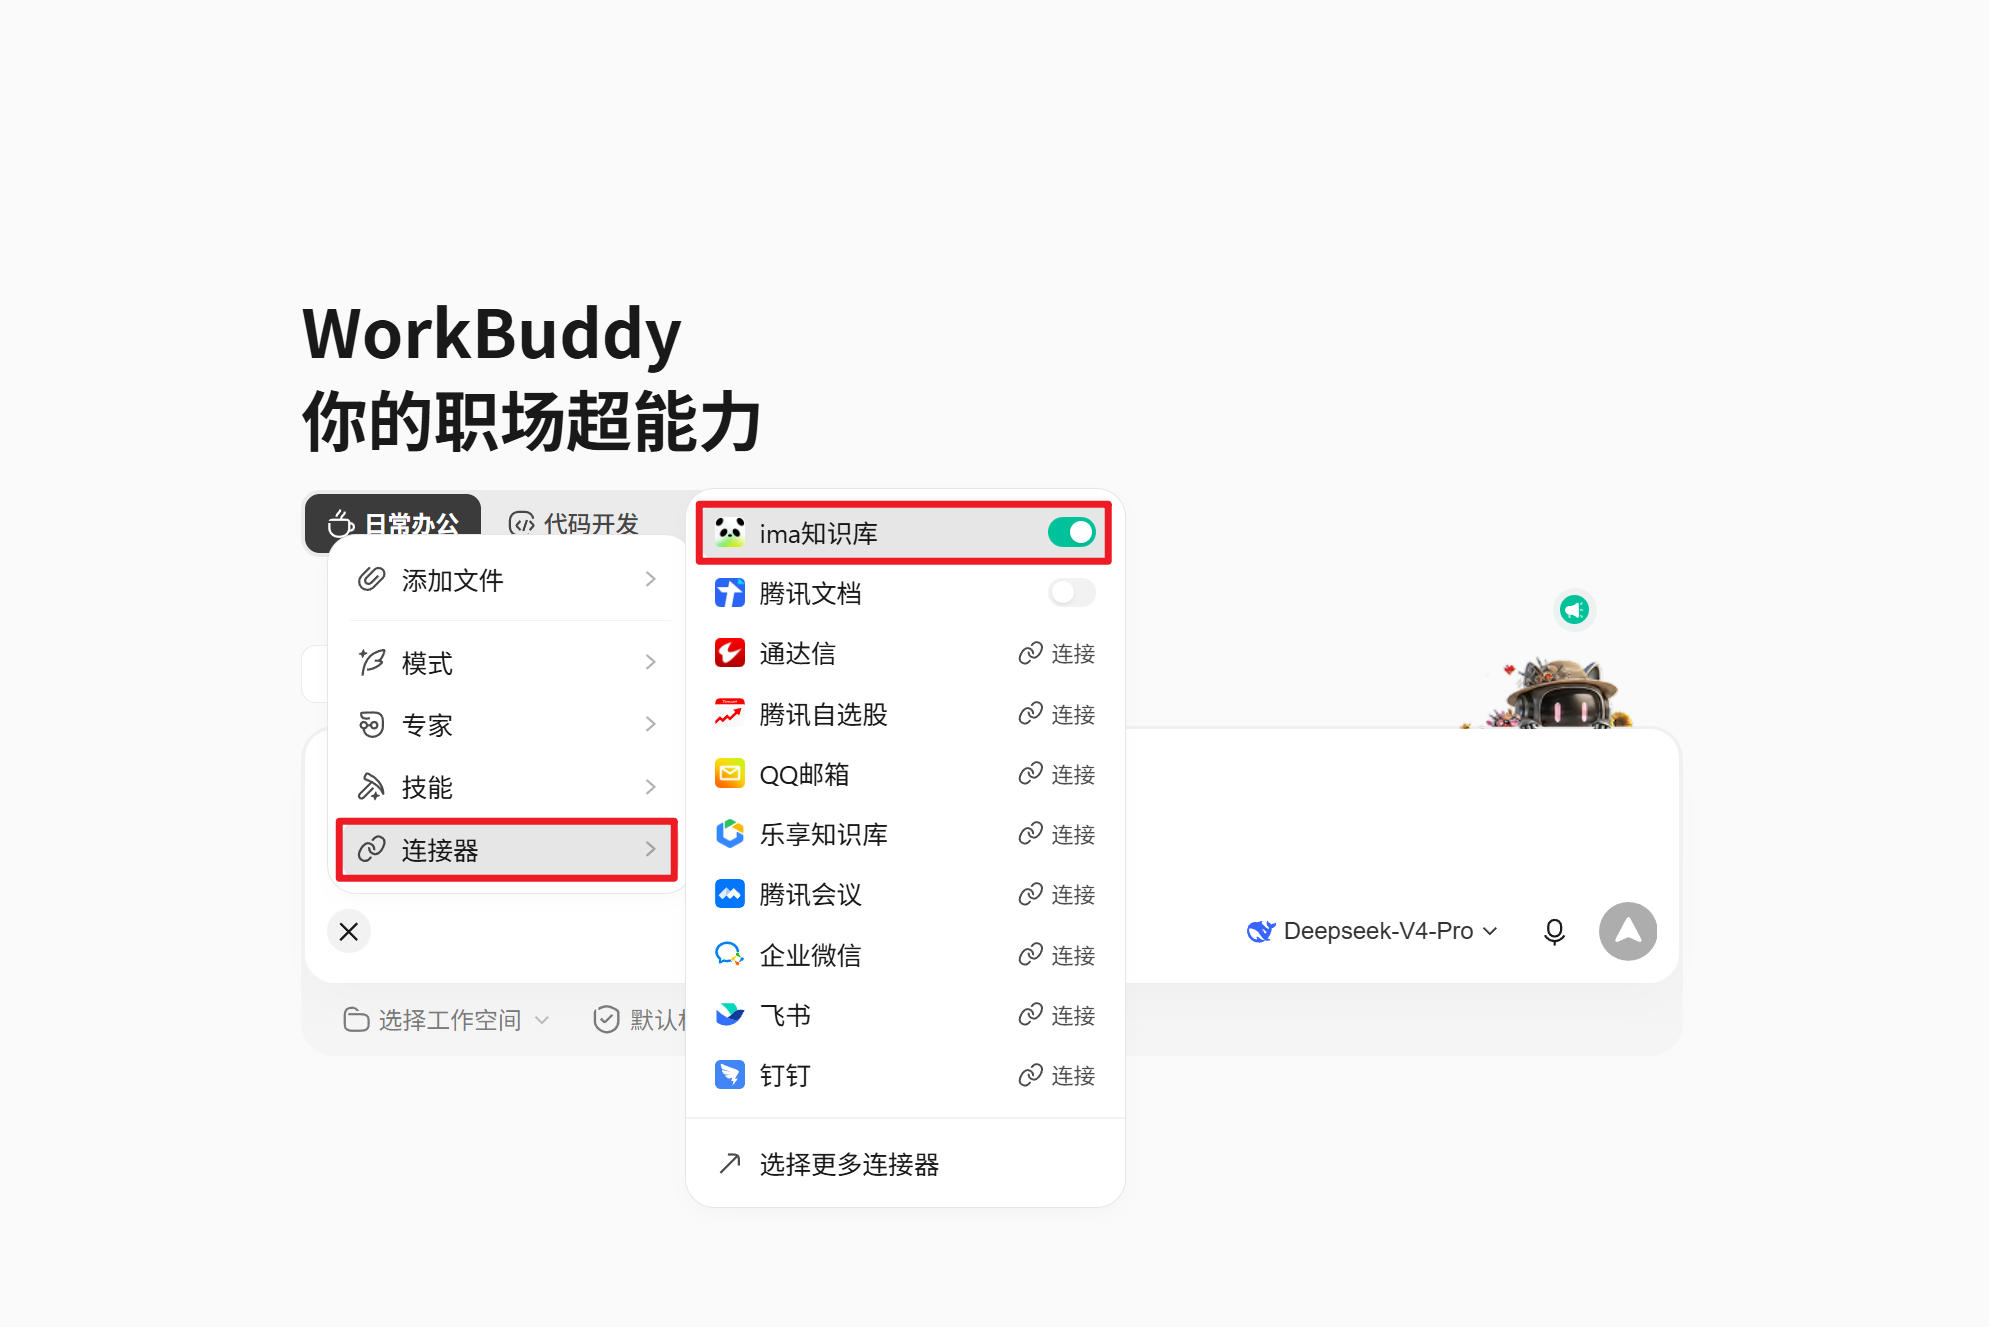
在 WorkBuddy 中打开连接器管理面板,搜索并添加「ima 知识库」连接器,完成授权。授权完成后,WorkBuddy 就能读取你的 ima 知识库内容了。
第三步:用 WorkBuddy 梳理知识体系
连接器就位后,在 WorkBuddy 中输入任务描述。比如你最近在 ima 中存了大量 AI 产品相关的文章,想让 WorkBuddy 帮你梳理:
我最近在 ima 知识库里存了很多关于 AI 产品的文章,请帮我做一次知识梳理。

要求:
1. 浏览知识库中的全部内容,先给我一个内容概况。
2. 按「大模型底层能力、AI 应用产品、行业趋势」三个维度分类整理。
3. 每个类别下列出核心观点和支撑内容的关键来源。
4. 找出内容之间的关联(比如 A 文章的观点被 B 文章进一步验证或反驳)。
5. 最后输出一份知识地图,标注当前我覆盖了哪些子领域、哪些领域还有空白。
WorkBuddy 会读取你的 ima 知识库,基于全部内容进行分析,把碎片拼成一张有逻辑的网。
第四步:把梳理成果回传 ima
梳理完成后,告诉 WorkBuddy 把结果保存回 ima:
把刚才生成的知识梳理报告保存到 ima 知识库,命名为「AI 产品知识体系-2026.07」。WorkBuddy 会通过连接器将成果写回 ima,下次你在 ima 里搜索就能找到这份结构化报告了。
第五步:持续更新知识体系
过了一段时间,你又存了新的微信内容到 ima。再次打开 WorkBuddy:
ima 知识库里最近新增了一些内容,帮我基于之前的知识体系框架,把新内容整合进去。如果有新的子领域出现,补充到知识地图里;如果新内容与之前的观点冲突,指出差异。这样你的知识体系就不是一次性的,而是随着输入持续生长。
提示词或任务指令
请连接我的 ima 知识库,帮我做一次完整的知识体系梳理。

背景:
我把日常在微信看到的有价值内容(公众号文章、群聊讨论、技术博客截图等)都存到了 ima,内容集中在 [你的领域:如 AI 产品 / 技术写作 / 前端开发]。

要求:
1. 先浏览全部内容,做一次内容盘点,告诉我库里都有什么。
2. 按 3-5 个核心维度分类组织内容,每个维度下列出关键观点和对应的原始内容来源。
3. 找出内容之间的关联、互补和矛盾之处。
4. 画一张知识地图(文字形式即可),标注已覆盖的子领域和空白区域。
5. 把所有梳理结果写回 ima,命名为「[领域]知识体系-YTD」。

后续我新增内容后,会继续让你更新这份知识体系。
在 WorkBuddy 中的效果
这一套流程跑通之后,你得到的是一个「活的」知识系统:
- 微信内容不再堆积在收藏夹里吃灰,而是被分类、关联、结构化地沉淀在 ima 中。
- 原来的零散碎片变成了一个有骨架、能导航的知识地图,随时知道自己在某个领域已经掌握了什么、还缺什么。
- WorkBuddy 不只是帮你整理,还帮你建立跨内容之间的连接——这是人脑很难做到的,尤其是内容量大的时候。
- 梳理结果回传 ima 后,你既可以在 ima 里直接搜索查看,也可以继续作为下一轮 WorkBuddy 对话的上下文。
- 新的微信内容能源源不断地输入到这个体系里,知识库会越来越「厚」,而不是越来越乱。
验收标准
- ima 客户端正常使用,微信内容能成功转发到 ima。
- WorkBuddy ima 连接器已授权,能在对话中成功读取知识库内容。
- WorkBuddy 能基于知识库内容,输出有结构的知识梳理报告(包含分类、关联、知识地图)。
- 梳理成果能成功写回 ima 知识库,在 ima 中可以搜索到。
- 后续新增内容后,WorkBuddy 能在原有体系上整合而非推倒重来。
常见问题
ima 连接器连不上
检查连接器的授权状态。如果之前授权过期,需要在 WorkBuddy 连接器管理面板中重新授权。另外确认 ima 客户端已登录同一账号。
WorkBuddy 读不到知识库里的某些内容
检查内容是否已经成功保存到 ima 知识库(在 ima 客户端中能看到)。部分格式(如纯视频、小程序卡片)可能不被支持。
知识梳理结果不够深入
在提示词里给 WorkBuddy 更明确的指令:指定你想要的分类维度、希望提取的粒度、以及输出格式。提示词越具体,结果越可控。
内容太多,一次梳理不完
可以先按时间范围或主题范围做分区处理。例如「先梳理最近三个月的内容」或「只梳理与 AI 产品相关的内容」。分批梳理后再做一次整体汇总。
安全与限制
- ima 知识库中的内容属于你自己的数据,在 WorkBuddy 中使用时不会外泄。
- 如果知识库中包含敏感个人信息或公司内部资料,使用前先确认哪些内容适合作为 AI 对话上下文。
- 回传内容到 ima 前,检查生成结果中是否有 AI 编造的数据或来源,必要时人工复核。
- ima 连接器的可用性和功能可能随官方更新变化,以连接器市场中的最新说明为准。
可以怎样复用
这个 Case 的核心是「收集 → 加工 → 沉淀」的三步闭环,替换知识领域和工具,可以适配很多场景:
- 读书笔记体系:把微信读书的书摘、划线发到 ima,用 WorkBuddy 按主题整理成读书笔记。
- 技术调研体系:把各种技术文章、GitHub 项目链接存到 ima,用 WorkBuddy 做技术选型分析和竞品对比报告。
- 学习追踪体系:把课程笔记、学习截图发到 ima,WorkBuddy 定期帮你做学习复盘和薄弱点诊断。
- 内容创作素材库:把选题灵感、参考文章、读者反馈存到 ima,WorkBuddy 帮你梳理选题排期和内容大纲。
分类:企业服务难度:入门来源:腾讯云官方文档《典型应用场景》
项目管理:AI 自动汇总项目进度
场景
多项目并行、协作人员众多时,信息散落在群聊、会议和文档中,负责人大量时间耗在整理信息、同步结论和追踪进度上。
核心做法
- 每 4 小时自动汇总群聊、会议记录、文档、链接和图片中的项目信息,提取讨论结论并识别文档新增批注
- 将最新共识、项目进度和待解决问题同步到项目看板,未参会成员快速了解情况
- 在企业微信群聊或私聊中直接提问,快速查找会议结论、项目背景和关键进展
应用成效
成效:同时负责的项目数量从 2-3 个提升到 5-6 个。
分类:法律服务难度:入门来源:腾讯云官方文档《典型应用场景》
法律服务:专业经验结构化沉淀
场景
律师的专业经验分散在案件处理、客户沟通和项目协作中,工作繁忙难以持续整理沉淀。
核心做法
- 汇总群聊、会议和文档中的关键信息,整理为项目记录和知识资产
- 将过往经验整理为可复用的模板、项目文档和流程表格
- 随新项目推进持续补充更新,让历史经验服务后续项目
应用成效
成效:组织知识持续积累,团队成员按需查找调用。
分类:法律服务难度:入门来源:腾讯云官方文档《典型应用场景》
法律服务:长周期客户服务看板
场景
长周期案件中律师既要办案又要反复向客户同步进展,重复沟通占用大量时间。
核心做法
- 从客户群聊中提炼最新服务记录和关键进展,形成结构化信息
- 将当前阶段、已完成事项和待处理任务整理到服务看板
- 基于项目上下文生成清晰专业的服务进展海报,交付客户
应用成效
成效:客户及时了解进度与后续安排,信任感提升。
分类:制造业难度:入门来源:腾讯云官方文档《典型应用场景》
制造业:客户反馈变研发灵感
场景
客户需求、使用疑问和现场问题分散在不同客户群,研发团队难以及时掌握真实需求。
核心做法
- 从客户群聊提取需求、疑问、问题反馈和现场图片,整理进智能表格
- 按周期汇总反馈,识别反复出现的功能需求和集中性痛点
- 将零散反馈归纳为可跟进的研发灵感看板,供产品规划参考
应用成效
成效:为产品迭代提供真实需求依据。
分类:供应链难度:中级来源:腾讯云官方文档《典型应用场景》
供应链:跨系统协作自动流转
场景
供应链涉及销售、采购、库存、财务多环节,信息传递依赖人工录单、电话核对和消息催办。
核心做法
- 将群聊中的订单、需求整理到智能表格,再由 WorkBuddy 写入对应业务系统
- 审批、发货、回款等关键节点自动同步到相关群聊
- 企业微信机器人应答订单状态、账款余额、库存数量等常见问题
应用成效
成效:减少跨部门协作中的人工录入与催办。
分类:金融服务难度:入门来源:腾讯云官方文档《典型应用场景》
金融服务:客户线索与专业报告
场景
金融客户服务中,员工需结合产品特点识别服务机会、跟进反馈并准备专业材料。
核心做法
- 结合产品特点和客户特征,提炼潜在客户线索
- 汇总客户触达后的反馈,识别有进一步沟通意向的客户
- 基于数据分析生成客户易于理解的专业报告
应用成效
成效:报告基础版本制作时间从两三天缩短至几分钟。
分类:连锁餐饮难度:入门来源:腾讯云官方文档《典型应用场景》
连锁餐饮:门店装修标准化
场景
连锁门店装修中总部标准传达不清、一线理解不一致,导致执行偏差和返工。
核心做法
- 汇总企业微信群聊、文档和会议内容,提炼为统一的图纸标注规范
- 汇总加盟商群中的实际问题和高频错误,持续补充完善规范
- 设计师将图纸交给 WorkBuddy,AI 按规范识别并标注需调整的位置
应用成效
成效:案例显示装修返工率降低 60%。
分类:医疗健康难度:中级来源:腾讯云官方文档《典型应用场景》
医疗健康:系统咨询机器人答疑
场景
医院新系统上线后运维团队被大量重复咨询和故障反馈淹没,夜间报障还可能遗漏。
核心做法
- 基于系统说明和历史问答构建知识库,自动回答群内常见问题
- 识别报错截图中的关键信息,给出处理建议
- 无法解决的问题生成工单或提醒运维跟进,新问题回流知识库
应用成效
成效:重复答疑和夜间故障遗漏显著减少。
分类:医疗健康难度:中级来源:腾讯云官方文档《典型应用场景》
医疗健康:灵活排班全流程闭环
场景
医院排班人员多、规则复杂、临时调整频繁,人工排班、通知、换班和月底核算耗时巨大。
核心做法
- 排班规则和人员名单整理到智能表格,由 AI 按规则生成排班计划
- 排班完成后机器人自动通知值班人员
- 员工通过企业微信审批提交换班,审批通过后 AI 更新排班
- 月底根据值班记录自动汇总工作量并核算薪酬,供管理员复核
应用成效
成效:人工协调成本大幅降低。
分类:一人公司难度:中级来源:腾讯云官方文档《典型应用场景》
OPC 的一天:一人公司用 WorkBuddy × ima
场景
一个人经营公司,行业变化、竞品消息、客户邮件一起涌来;既要判断方案方向,又要亲自制作文件。
核心做法
- 创建定时任务搜索行业变化与竞品动态,生成带来源链接的简报,一键存回 ima 形成行业情报库
- 通过连接器读取 QQ 邮箱与飞书消息,标出需立即回复的内容并生成今日优先级
- 腾讯会议连接器导入会议记录,整理成新需求、已确认事项、待确认问题和后续行动
- 把每次产出沉淀回知识库,越用越厚,形成专属团队
应用成效
成效:早上得到的不再是一堆待读信息,而是可直接执行的工作安排。
分类:自动化难度:入门来源:麒跃科技《WorkBuddy 数字员工》实测
5 个提示词搭一条数字员工流水线
场景
收件箱永远 99+、下班前补周报、好文章收藏后再也不看——三个日常顽疾交给 5 个「数字员工」接力处理。
核心做法
- 选题侦察兵:每天基于 7 天热点出 10 个选题(标题+痛点+素材),你挑 3 个排期
- 日报秘书:下班前丢流水账,整理成进展/风险/明日计划三段式周报
- 邮件分拣员:按紧急度分级,草拟即时回复,标出需亲自决策的事项
- 竞品雷达:拆解竞品文章的目标、钩子与可借鉴动作
- 素材管家:收藏内容自动分类打标签,告别收藏夹吃灰
提示词示例
你是我的工作助理。我会给你今天的零散记录,请你整理成周报,格式:
① 今日进展(3 条,每条含结果与数据);
② 风险与阻塞;
③ 明日计划。
语气专业、克制,不超过 300 字。
应用成效
成效:博主两个月实测:平均每天省下约 3 小时。关键设计是前一个员工的产出直接喂给下一个。
分类:研发难度:入门来源:腾讯云开发者社区
需求文档拆成任务清单与验收标准
场景
产品给一段需求,开发常卡在「到底要做哪几件事、做到啥程度算完」。
核心做法
- 粘贴需求原文,让 AI 输出任务清单:任务名、归属模块、预估复杂度
- 为每条任务生成验收标准(AC):给定…当…则…,明确做到啥算完成
- 补充隐含需求:权限控制、性能边界、异常处理、日志审计
- 列出风险与待确认项,回头找产品对齐;进阶可转成看板卡片
提示词示例
请把下面的需求拆解成开发任务清单。
需求描述:[粘贴需求]
请输出:
1) 任务清单:任务名、归属模块、预估复杂度(低/中/高)
2) 每条任务的验收标准(AC):用「给定…当…则…」
3) 隐含需求补充:权限、性能、异常、日志审计
4) 风险与待确认:哪些点需求没说清
应用成效
成效:需求到开发之间最稳的「翻译层」。踩坑:不给需求原文会凭空编任务,不要求 AC 则拆项不可验收。
来源:腾讯云开发者社区
分类:开发者难度:入门来源:腾讯云开发者社区
三周,从「玩具」用成「工作台」
场景
把 WorkBuddy 当聊天机器人就亏了——真正值钱的是它能直接在你的环境里动手,一条链路打通。
核心做法
- 代码与终端一体化:贴报错让它读文件、跑命令、对比依赖版本、定位根因,不再反复横跳
- 直接产出交付物:技术方案、README、复盘按结构生成 .md/.docx,复制即用
- 把日报、数据抓取、周期性检查挂成自动化定时任务,到点自动跑、只看结果
应用成效
成效:把机械性劳动外包出去,每天多出一块完整时间做真正要动脑的事。
来源:腾讯云开发者社区
分类:办公难度:中级来源:腾讯云开发者社区
自动化 + 专家协作,办公效率拉满
场景
任务描述笼统产出要返工、重复劳动每天手动做、AI 生成内容缺依据——三个坑各有解法。
核心做法
- 写正式报告找公文/研报类专家,自带结构方法论;表格用 sheetagent 技能处理透视与合并
- 常用行业报告、公司制度、产品文档放进资料库,让 AI 基于真实材料生成内容
- 四要素描述法:目标 + 素材 + 要求 + 边界
- 大任务拆成 2-3 个连续任务,每步验收后再继续;重复劳动一律改造成定时自动化
- 例行任务用轻量模型、复杂任务才上强模型,控制消耗
应用成效
成效:用顺之后每天实打实省下 1-2 小时。
来源:腾讯云开发者社区
分类:零代码难度:入门来源:腾讯云官方教程《实践七:零代码制作本地应用》
零代码制作本地应用
场景
无代码基础也想快速验证想法:知识管理、待办工具、数据小脚本都可以直接说给 AI 做。
核心做法
- 新建任务选择代码开发模式,一句话描述需求,AI 生成完整代码并尝试运行
- 出现异常时描述观察到的现象(按钮、报错、步骤),配合截图多轮排查修复
- 按需持续升级:模糊搜索、每天自动推送待办、对接 QQ/微信录入、内容自动关联
应用成效
成效:先做最小可用版本,再逐步增加复杂能力,稳定迭代。
分类:知识管理难度:入门来源:腾讯云官方教程《如何用 WorkBuddy 把 ima 知识库越用越厚》
把 ima 知识库越用越厚
场景
收藏夹吃灰、文件散落各处、找过的资料第二次还要重搜——个人知识没有复利。
核心做法
- 把微信收藏、文档、网页内容转存进 ima 知识库
- 在 WorkBuddy 中直接基于知识库提问,让回答来自你自己的资料
- 每次任务的产出有价值的部分一键存回知识库,定期整理成笔记
应用成效
成效:知识库越用越厚,逐渐形成个人的「第二大脑」。
分类:日化难度:企业级来源:2026 腾讯全球数字生态大会公开报道
中顺洁柔:供应链全链路求最优解
场景
供应链链路长、变量多,靠人工排产和选仓难以求最优解。
核心做法
- 1200 名员工完成 WorkBuddy 强制考核培训,全员会用
- 销售订单、发货、选仓到生产排产的整条链路交给智能体求最优解
- 业务人员自己动手后,原本在外包团队和 IT 手里的规则沉淀到企业内部
应用成效
成效:供应链成本节降达到四位数级(万元级以上)。
分类:通信难度:企业级来源:2026 腾讯全球数字生态大会公开报道
联通华盛:开票三表智能核对
场景
31 个省级公司财务人员每月各花两天,人工核对打款、订单与开票三张表。
核心做法
- 把三张表和匹配规则交给智能体自动核对
- 差异项自动标出并生成核对结论
应用成效
成效:一名财务人员每月 2 小时完成;按约 100 个内部案例总结,重复性工作提效约 10 倍。
分类:乳业难度:企业级来源:2026 腾讯全球数字生态大会公开报道
伊利:经营策略直达千名导购
场景
营销策略到一线导购的传导慢、颗粒度粗。
核心做法
- WorkBuddy 汇聚业务数据、生成经营策略
- 策略下发到上千名导购,由 ADP 导购智能体生成推荐与话术
- 组合使用腾讯云 ADP、WorkBuddy 与企业微信
应用成效
成效:运营提效超过 50%,A/B 测试中销售订单提升 26%。
分类:制造业难度:企业级来源:2026 腾讯全球数字生态大会公开报道
头部制造:月审 2 万单索赔发票
场景
售后、产品、市场提出 13 个场景,索赔发票人工初审量大易错。
核心做法
- 通过 MCP 直连企业经销商管理系统
- 每月 2 万单索赔发票由 WorkBuddy 自动初审
- 企业版统一管控后,测试账号上线第二天被员工领完
应用成效
成效:企业内 AI 使用者规模扩大 10 倍以上。
分类:文化传媒难度:企业级来源:腾讯云开发者社区
文化传媒:政策分析 75 倍提效
场景
员工手动处理数万字政策文件、多源数据整理与深度报告,分析周期长达数小时至数天。
核心做法
- 政策文件分析:3.8 万字材料 2.5 小时 → 2 分钟生成 7 页 PPT 报告,自动标注观点出处
- 会议纪要:2500 字纪要 50 分钟人工提取 → 60 秒生成 12 项工作推进台账
- 热点选题:每日抓取 15+ 信息源,8 分钟生成舆情监测报告
- 内容智能审核:六维度审核系统将稿件评分从 6.15 提升至 9.15,错别字检测准确率 100%
应用成效
成效:核心场景效率提升 50-75 倍。
来源:腾讯云开发者社区
分类:电商难度:企业级来源:腾讯云开发者社区
本地生活电商:运营数据驱动提效
场景
多系统数据分散、周报耗时 4-6 小时、8 人团队无专职文案、新人上手要一个月。
核心做法
- 对接团购平台、社群及会员系统,自动汇总多源数据生成运营仪表盘
- AI 批量生成商品详情页文案、社群话术与活动文案
- 基于用户分层与商品数据智能推荐活动主题,自动生成方案与效果预测
- 沉淀运营 SOP、爆品复盘、用户分群策略,新人 AI 对话快速上手
应用成效
成效:报表 4 小时→15 分钟;内容产出 +60%;活动策划 +50%;新人上手周期缩短 50%。
来源:腾讯云开发者社区
分类:政务难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
深标院:标准化专业智能体
场景
标准化研究机构希望用智能体提升专业工作效率,同时守住数据安全底线。
核心做法
- 依托 WorkBuddy 与企业微信,3 个试点部门 75 人先行先试 3 个月
- 内部累计上架 46 个技能和 3 个专家包
- 开发上线标准化专业智能体「让标准创造价值的 AI伙伴」
应用成效
成效:高频事务处理效率提升 40% 以上,全流程零数据泄露、零权限越界。
分类:政务难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
湾擎政务训练营:2 天 54 项场景
场景
政务服务场景碎片化、个性化强,需要快速孵化和验证 AI 应用。
核心做法
- 依托广东省政数局湾擎·WorkBuddy 政务智能中枢开营
- 22 家试点部门、8 个地市的政务骨干集中实训
- 两天产出 54 项政务 AI 场景应用,复测验证后汇编成全省场景全景图
应用成效
成效:对比原有工作方式实测平均效率提升 70% 以上,一地创新、全省复用。
分类:智库难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
国家数据发展研究院:科研办公辅助
场景
研究人员的時間大量耗在检索、摘录、比对和格式整理上。
核心做法
- 启用 WorkBuddy 专享版,搭配腾讯乐享知识库
- 覆盖公文起草、院务办理、知识检索和科研辅助四个场景
- 把机械性工作交给 AI,研究员专注判断与洞见
应用成效
成效:研究支撑效率明显提升。
分类:税务难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
深税悦悦:千万级纳税人智能咨询
场景
面向全市 1000 余万纳税人、缴费人的咨询,人工坐席无法全覆盖。
核心做法
- 基于 ADP 构建税务咨询智能体「深税悦悦」
- 从一问一答升级为办问一体,直接辅助办理
- 咨询数据回流持续优化应答
应用成效
成效:纳税人需求自助满足率超过 97%,已有 10 个省市税务局试用。
分类:科研难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
谛听地震科学智能体:一句话处理波形
场景
地震监测数据处理需要专业模型和部署运维,一线人员使用门槛高。
核心做法
- 中国地震局地球物理研究所将「谛听」地震波大模型封装为技能接入 WorkBuddy
- 首批上线震相拾取、事件分类、震级估算和事件定位四项技能
- WorkBuddy 负责理解需求、选择技能,波形处理交给大模型
应用成效
成效:一句话即可处理本单位监测数据,无需自行部署维护模型。
分类:水务难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
水务大脑:一个入口调用水务智能
场景
水务业务系统已有存量,新建 AI 能力不应推翻重来。
核心做法
- 以腾讯云专属专区为底座,建立决策、记忆、感知算力三个中枢
- 员工通过企业微信、WorkBuddy 一个入口即可调用
- 整套系统满足等保三级要求
应用成效
成效:存量系统平滑接入 AI 能力,加速水务智能化。
分类:法律难度:企业级来源:消费日报网《腾讯云加速政务智能体落地》
法镜:法律业务智能体底座
场景
法律业务的核查、核对与流程管控高度依赖人工经验。
核心做法
- 中律科技与腾讯云联合发布法律业务智能体底座「法镜」
- 与 WorkBuddy 深度结合
- 首批上线网络核查、内核核对和案件全流程管控三个场景
应用成效
成效:法律专业能力产品化,可按场景调用。
完整案例(开源社区案例组)来自开源项目 WorkBuddyGuide(MIT License),版权归原贡献者所有;
简报案例根据官方文档与公开报道改写,来源见各篇末尾链接。